nepali-news-dataset
收藏资源简介:
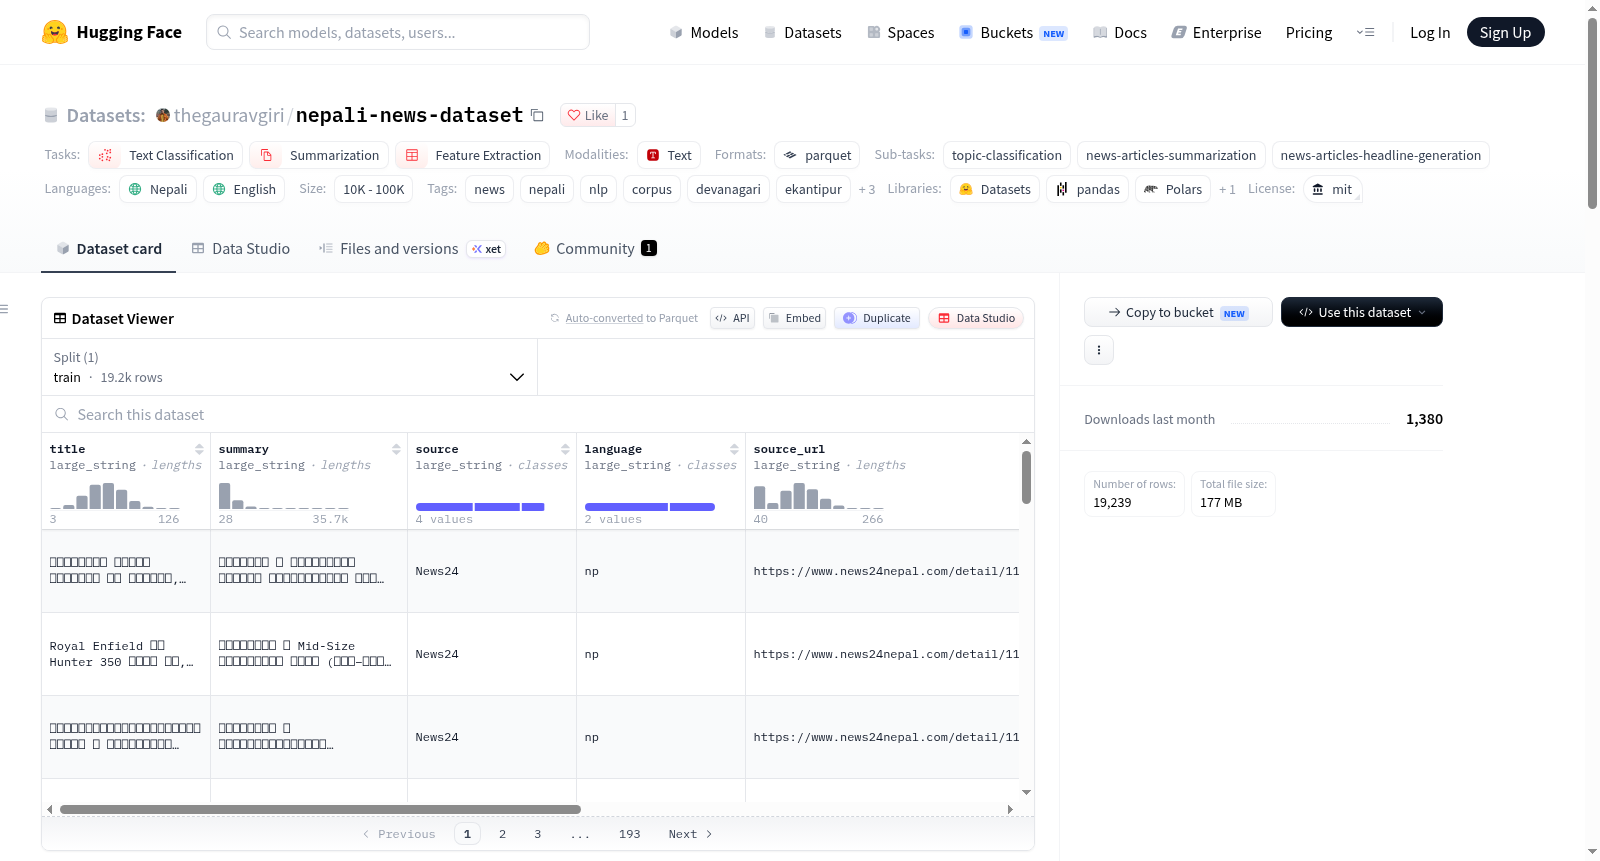
该数据集是一个自动聚合、每4小时更新一次的尼泊尔语和英语新闻数据集,包含超过15,000篇全文新闻文章,且数量持续增长。数据来源包括Ekantipur(कान्तिपुर)、Nagarik News(नागरिक दैनिक)、The Kathmandu Post和News24 Nepal(न्युज २४)四个新闻门户。每条记录包含标题、摘要(正文)、来源、语言(尼泊尔语代码np或英语代码en)、原文链接、图片链接、发布日期和抓取时间戳。数据集采用UTF-8天城文编码,遵循MIT开源协议。适用于文本分类(如主题分类)、新闻摘要、新闻标题生成、特征提取等自然语言处理任务。用户可通过Hugging Face datasets库直接加载,也可通过无认证、无速率限制的API端点获取实时或历史数据。
This dataset is an automatically aggregated, updated every 4 hours Nepali and English news dataset, containing over 15,000 full-text news articles and growing. Data sources include four news portals: Ekantipur (कान्तिपुर), Nagarik News (नागरिक दैनिक), The Kathmandu Post, and News24 Nepal (न्युज २४). Each record contains title, summary (body), source, language (Nepali code np or English code en), original link, image link, publication date, and crawl timestamp. The dataset is encoded in UTF-8 Devanagari script and follows the MIT open-source license. It is suitable for NLP tasks such as text classification (e.g., topic classification), news summarization, news headline generation, and feature extraction.
🇳🇵 Nepali News Dataset & NLP Corpus 数据集详情
数据集概述
该数据集是一个开放获取的尼泊尔语和英语新闻数据集,专为自然语言处理(NLP)和机器学习任务设计,包含15,000+篇全文新闻文章,并通过自动化管道每4小时更新一次。
基本信息
- 语言:尼泊尔语(
np/ne)和英语(en),采用干净的UTF-8天城文(Devanagari)编码 - 许可证:MIT License
- 数据规模:10K < n < 100K
- 多语言性:多语言(multilingual)
- 标注方式:无人工标注(no-annotation)
- 数据来源:原始数据(original)
数据字段结构
每条数据记录包含以下字段:
| 字段 | 类型 | 描述 |
|---|---|---|
title |
string | 新闻标题(尼泊尔语天城文或英语) |
summary |
string | 文章完整多段落正文 |
source |
string | 新闻门户来源(Ekantipur、KathmanduPost、NagarikNews、News24) |
language |
string | 语言代码(np为尼泊尔语,en为英语) |
source_url |
string | 文章原始链接 |
image_url |
string | 特色缩略图/照片URL |
date |
string | 发布快照日期(YYYY-MM-DD格式) |
scraped_at |
string | 文章抓取时的ISO时间戳 |
数据来源(支持的新闻门户)
| 门户 | 语言 | 更新频率 | 网站 |
|---|---|---|---|
| Ekantipur(कान्तिपुर) | 尼泊尔语(np) |
每4小时 | https://ekantipur.com |
| Nagarik News(नागरिक दैनिक) | 尼泊尔语(np) |
每4小时 | https://nagariknews.nagariknetwork.com |
| The Kathmandu Post | 英语(en) |
每4小时 | https://kathmandupost.com |
| News24 Nepal(न्युज २४) | 尼泊尔语(np) |
每4小时 | https://news24nepal.com |
适用任务
该数据集支持以下NLP任务:
- 文本分类(主题分类)
- 摘要生成(新闻文章摘要)
- 特征提取
- 新闻标题生成
数据配置与访问
- 配置名称:
default - 数据文件:
data/train.parquet(训练集) - 数据集大小分类:10K < n < 100K
数据更新机制
数据通过GitHub Actions自动化管道每4小时自动抓取和更新,支持实时和历史数据访问。用户可通过Hugging Face原始端点(raw endpoints)获取当日实时新闻和历史每日存档数据,无需身份验证且无速率限制。