
遇见数据集

Sandhya1912/AA-Omniscience-Public

收藏
Hugging Face2026-05-29 更新2026-05-31 收录
官方服务:

资源简介:

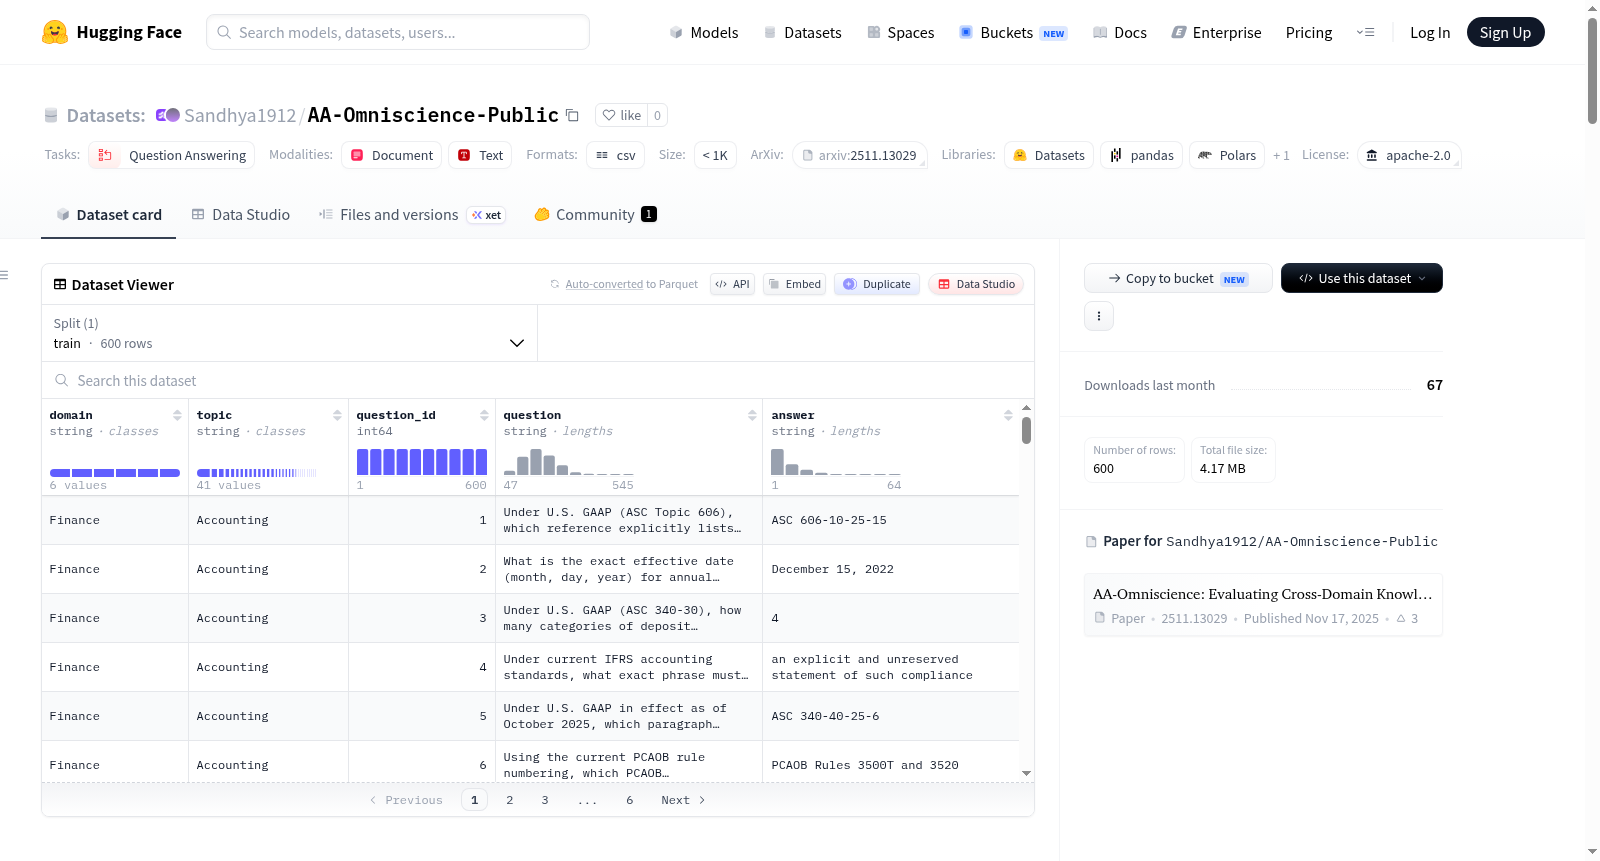
AA-Omniscience-Public 是一个基准数据集,包含600个跨多个领域的问题,用于测试大型语言模型的知识可靠性和幻觉倾向。该数据集旨在衡量模型在跨领域准确回忆事实信息的能力,以及在知识不足时正确弃权的能力。完整数据集包含6000个问题,覆盖经济重要领域,而公共版本是完整数据集的10%代表性子集,以确保评估完整性。问题通过自动化问题生成代理创建,基于权威来源,并经过相似性、难度和模糊性过滤,具有难度高、答案明确、不依赖特定来源和答案精确的特点。数据集用于评估模型的知识准确性和幻觉率,但公共版本在领域或主题级别的结果可能不可靠,因为样本量较小。

AA-Omniscience-Public contains 600 questions across a wide range of domains used to test a model’s knowledge and hallucination tendencies. It is a benchmark dataset designed to measure a model’s ability to both recall factual information accurately across domains, and correctly abstain when its knowledge is insufficient. The full dataset comprises 6,000 total questions, split across economically significant domains, and the public version is a 10% subset of the full question set, sampled to be representative. Questions are created using a question generation agent, derived from authoritative sources and filtered based on similarity, difficulty, and ambiguity, making them difficult, unambiguous, not reliant on specific sources, and precise. The dataset is used to evaluate model knowledge accuracy and hallucination rates, though the public set may not be reliable at a domain or topic level due to small size.
提供机构:
Sandhya1912
搜集汇总
数据集介绍
Sandhya1912/AA-Omniscience-Public 数据集图片
构建方式
AA-Omniscience-Public 数据集源自全量版 AA-Omniscience 的 10% 子集,全量集涵盖 6000 道横跨多经济领域的高难度知识问题。所有题目通过自动化问答生成智能体,从权威资料中提取并经过相似度、难度与歧义性三重筛选而构建。为确保子集代表性,研究人员在采样时使公开集与全量集的模型评估结果高度对齐,从而保证公开集能够有效反映模型知识准确性与幻觉率的整体表现。
特点
该数据集最显著的特点在于引入了惩罚错误猜测的评估机制,区别于传统准确率与幻觉率指标。题目设计追求高难度、无歧义、不依赖特定来源,并限定答案为日期、名称、数字等精确短格式。每道题目均要求模型仅凭内在知识作答,不得借助外部工具或上下文,从而严格评测其跨领域知识召回与正确弃权的平衡能力。
使用方法
使用时,模型需在无任何外部辅助的条件下接收提示,被明确指导仅在确信时回答,否则应表示不知道。随后使用基于 Gemini 2.5 Flash Preview 的评分模型,依据严格规则将回答分类为正确、错误、部分正确或未作答。评分细则包括数值精度容忍、隐含信息推断、拼写变异宽容等标准化准则,确保评估的公平与精准。研究社区可通过公开集快速获取模型在 Omniscience 指数上的性能指示。
背景与挑战
背景概述
AA-Omniscience-Public数据集由Artificial Analysis团队于2025年创建,旨在评估大型语言模型在跨领域知识召回与幻觉抑制方面的能力。该数据集包含600个精选问题,覆盖经济、法律、科学等多个重要领域,通过引入惩罚错误回答的评分机制,构建了有别于传统准确率和幻觉率的“全知指数”。其核心研究问题聚焦于模型在缺乏上下文和工具辅助的情况下,能否准确回忆事实并在知识不足时正确弃权。该数据集对于推动模型在专业任务中的可靠性评估具有重要价值,为领域特定模型的选择提供了量化依据。
当前挑战
该数据集面临的核心挑战在于如何准确衡量模型的知识边界与幻觉倾向。领域层面,现有模型常因过度自信而产生虚假信息,AA-Omniscience通过设置惩罚错误回答的评分框架,迫使模型在不确定时选择弃权,从而区分知识准确性与幻觉行为。构建过程中,挑战包括生成足够困难且无歧义的问题以避免基准测试饱和,同时确保问题来源的权威性和答案的唯一性。此外,维护评估公平性要求仅公开10%的子集,但这导致领域和主题级别的结果可靠性不足,限制了细粒度分析的准确性。
常用场景
经典使用场景
AA-Omniscience-Public 数据集的核心应用场景在于对大型语言模型进行跨领域知识可靠性评估。该数据集通过精心设计的600道高难度、无歧义且答案精确的问题,覆盖广泛的经济关键领域,旨在系统性地衡量模型在缺乏外部上下文或工具辅助时,回忆并准确呈现事实性知识的能力。其独特之处在于引入了对错误猜测的惩罚机制,这使得它能有效区分模型的知识准确度与幻觉率,从而为用户在特定领域任务中选拔表现稳健的模型提供了极具价值的参考依据。
解决学术问题
该数据集主要针对大型语言模型中普遍存在的知识幻觉与跨领域知识掌握不均衡等核心学术难题。通过构建一个包含高难度、领域多样且答案严格的问答基准,AA-Omniscience 能够精准量化模型在何种程度上会生成与事实相悖的虚假信息,并揭示其在不同知识领域间的能力差异。这项工作对于提升模型的可信赖度、推动更鲁棒的知识表示与推理方法研究具有深远意义,为构建更安全、更可靠的人工智能系统奠定了重要的评估基础。
衍生相关工作
该数据集启发了多项探讨前沿模型知识边界与不确定性建模的后续工作。其独特的‘拒绝回答’评分机制鼓励研究者深入探索模型自知之明的培养方法,例如开发更优的置信度校准技术与不确定性估计工具。此外,AA-Omniscience 的自动化问题生成与过滤流程为构建大规模、动态更新的跨领域知识基准提供了可复现的范式,催生了针对特定经济领域(如医学、法律、编程)的更细粒度知识可靠性评测体系,推动了整个领域向更可控、更透明的方向发展。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

