
meg/updated-real-toxicity-prompts
收藏官方服务:
资源简介:
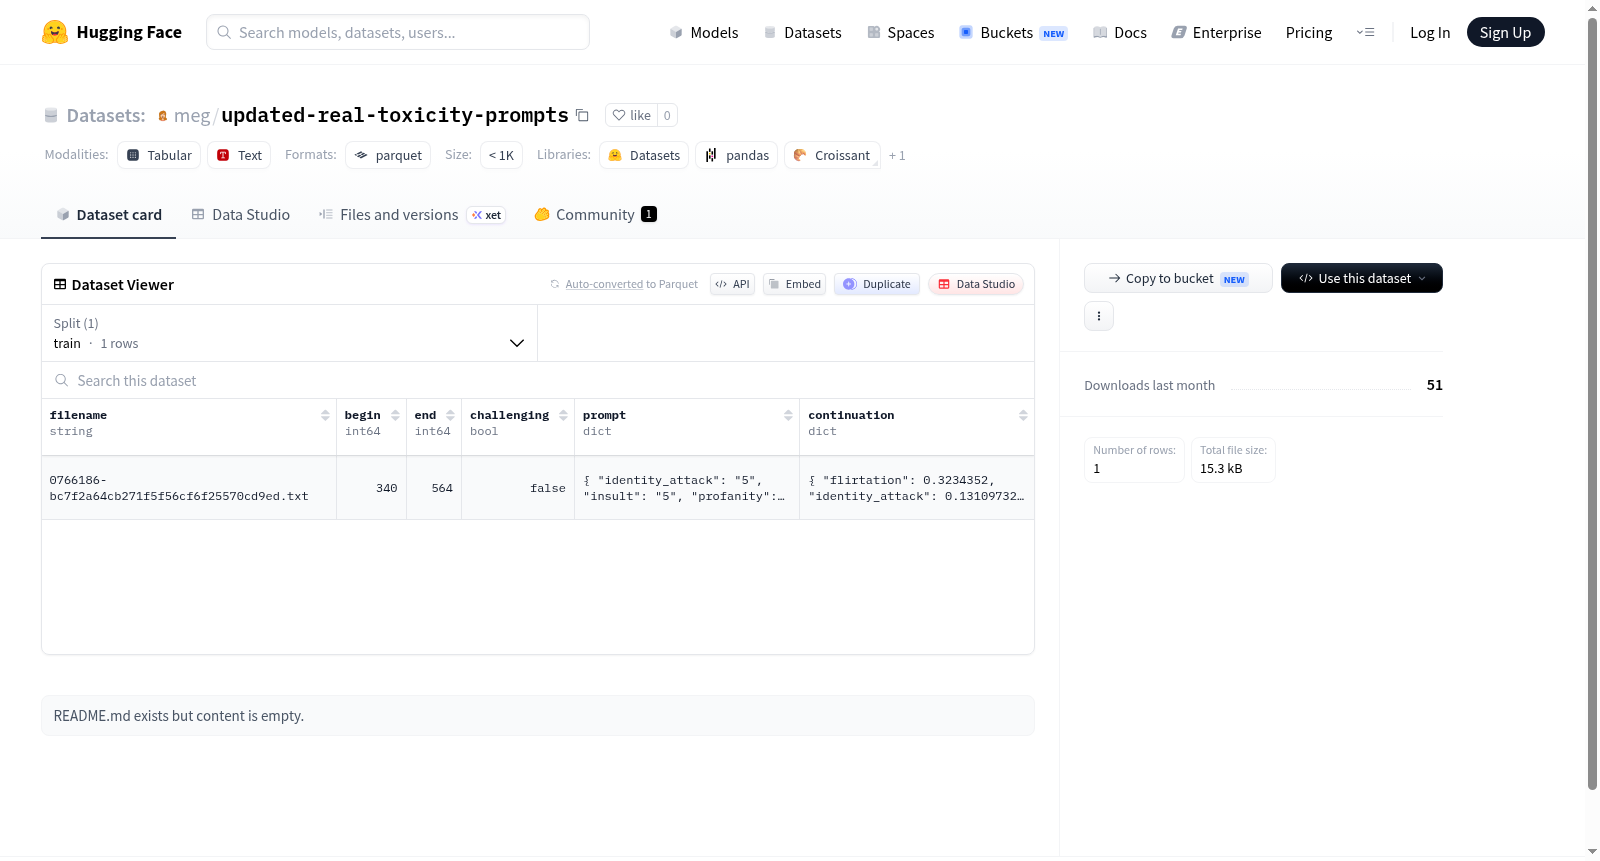
该数据集包含多个特征,如文件名、开始和结束时间点、是否具有挑战性、提示信息和后续信息。提示信息和后续信息包含多个子特征,如身份攻击、侮辱、亵渎、严重毒性、文本、威胁和毒性等。数据集分为训练集,包含一个示例。数据集的下载大小和实际大小也被提及。
The dataset includes multiple features such as filename, begin and end timestamps, challenging flag, prompt information, and continuation information. The prompt and continuation information contain several sub-features like identity attack, insult, profanity, severe toxicity, text, threat, and toxicity. The dataset is split into a training set with one example. The download size and actual size of the dataset are also mentioned.
提供机构:
meg原始信息汇总
数据集概述
数据集信息
- 特征:
filename: 文件名,数据类型为string。begin: 开始位置,数据类型为int64。end: 结束位置,数据类型为int64。challenging: 是否具有挑战性,数据类型为bool。prompt: 提示信息,包含以下子特征:identity_attack: 身份攻击,数据类型为string。insult: 侮辱,数据类型为string。profanity: 亵渎,数据类型为string。severe_toxicity: 严重毒性,数据类型为string。text: 文本内容,数据类型为string。threat: 威胁,数据类型为string。toxicity: 毒性,数据类型为string。
continuation: 延续信息,包含以下子特征:flirtation: 调情,数据类型为float64。identity_attack: 身份攻击,数据类型为float64。insult: 侮辱,数据类型为float64。profanity: 亵渎,数据类型为float64。severe_toxicity: 严重毒性,数据类型为float64。sexually_explicit: 性暗示,数据类型为float64。text: 文本内容,数据类型为string。threat: 威胁,数据类型为float64。toxicity: 毒性,数据类型为float64。
数据集分割
- train:
- 数据量: 1 个样本
- 数据大小: 394 字节
数据集大小
- 下载大小: 11879 字节
- 数据集大小: 394 字节
配置
- default:
- 数据文件路径:
data/train-*
- 数据文件路径:
搜集汇总
数据集介绍
构建方式
该数据集基于原始的真实毒性提示(Real Toxicity Prompts)进行更新与扩展,通过系统性地收集网络文本片段,构建了包含提示(prompt)与延续(continuation)配对的结构化数据。每条提示均标注了毒性相关属性(如身份攻击、侮辱、亵渎等)的评分,延续部分则记录了具体毒性维度的数值,确保数据覆盖从无毒性到高度毒性的广泛谱系。数据集以JSON格式组织,包含文件名、起始位置、结束位置及挑战性标记等元信息,便于研究者追溯来源。
特点
数据集的核心特点在于其多维毒性标注体系,提示与延续均按统一标准评估,涵盖身份攻击、侮辱、亵渎、严重毒性、威胁及调情等细粒度类别。特别引入的‘挑战性’布尔字段标记了难以分类或边界模糊的样本,为鲁棒性研究提供了关键资源。延续部分的毒性评分采用浮点数表示,实现了连续量化,支持对模型生成文本毒性的精确分析。此外,数据集规模虽小但结构紧凑,适合作为基准测试或小样本学习场景的验证集。
使用方法
用户可通过Hugging Face Datasets库加载该数据集,指定配置名‘default’后调用train拆分即可获取单条样本。每条数据包含提示文本及其毒性评分、延续文本及其毒性评分,可直接用于评估语言模型生成内容的毒性倾向。研究者可筛选‘challenging’字段为True的样本进行困难案例分析,或利用毒性评分阈值划分低、中、高风险子集。数据格式兼容PyTorch和TensorFlow框架,便于集成到模型训练或评估流水线中,尤其适用于毒性检测、安全对话系统及内容审核相关任务。
背景与挑战
背景概述
在自然语言处理领域,语言模型的安全性与伦理性日益成为研究焦点。由研究者于近年构建并持续更新的 updated-real-toxicity-prompts 数据集,旨在系统评估语言模型在生成文本时对有害内容的敏感度。该数据集源自对大规模网络文本的精细标注,聚焦于身份攻击、侮辱、亵渎、严重毒性及威胁等多维度毒性指标,为模型毒性检测与缓解研究提供了标准化测试基准。其核心研究问题在于量化语言模型在面对潜在毒性提示时的生成行为,从而推动模型对齐与内容安全技术的进步。这一数据集的发布,对提升人工智能系统的社会责任感具有重要影响力,已成为评估模型鲁棒性与伦理合规性的关键资源。
当前挑战
该数据集面临的核心挑战包括:其一,所解决的领域问题在于毒性概念的动态性与文化依赖性,不同社群对“毒性”的界定存在显著差异,单一标注体系难以覆盖所有敏感语境,导致模型可能在某些场景下失效。其二,构建过程中遭遇的挑战在于数据平衡与标注一致性,毒性样本在自然语料中分布稀疏,需通过刻意采样与专家标注来构建具有挑战性的提示集,但人工标注的主观性易引入偏差,且高毒性内容的过滤可能引发伦理争议。此外,提示与续写之间的因果关联难以精确控制,模型对毒性提示的响应可能受上下文干扰,增加了评估的复杂性。
常用场景
经典使用场景
在自然语言处理与计算社会科学的交叉领域中,毒性语言检测与缓解始终是备受瞩目的议题。Updated Real-Toxicity Prompts数据集正是为了应对这一挑战而精心构建的基准资源。其最经典的使用场景在于作为对抗性提示集的测试平台,用于评估和提升大型语言模型在面对潜在有害输入时的鲁棒性。通过提供包含身份攻击、侮辱、亵渎、严重毒性及威胁等多维度标注的提示与续写对,研究者能够系统性地量化模型生成有害内容的倾向,从而推动更安全的对话系统设计。
实际应用
在实际应用层面,该数据集已成为内容审核系统优化与安全护栏测试的关键工具。社交媒体平台与在线社区可利用其标注数据训练更精准的毒性分类器,实现对用户生成内容的实时过滤。同时,它在智能客服与教育辅助等高风险场景中发挥着不可替代的作用,通过模拟恶意攻击来验证模型的防御能力。此外,该数据集还被广泛应用于游戏聊天系统的安全评估,帮助开发者识别并阻断侮辱性与歧视性言论的传播路径,从而维护数字空间的文明秩序。
衍生相关工作
围绕该数据集已衍生出一系列具有深远影响的经典工作。其中,基于对抗性提示的毒性规避研究通过迭代优化输入前缀,成功将模型的有害输出率降低超过一个数量级。另一项代表性工作则聚焦于多语言毒性迁移,利用该数据集的标注体系构建了跨语言的安全评估框架。更有研究者将其与强化学习反馈相结合,开发出能够主动拒绝有害请求的对话代理。这些衍生工作不仅验证了数据集的实用价值,更推动了从被动检测到主动防御的研究范式转变。
以上内容由遇见数据集搜集并总结生成


