
遇见数据集

izhx/UMRB-ReMuQ

收藏
Hugging Face2024-12-18 更新2024-12-14 收录
官方服务:

资源简介:

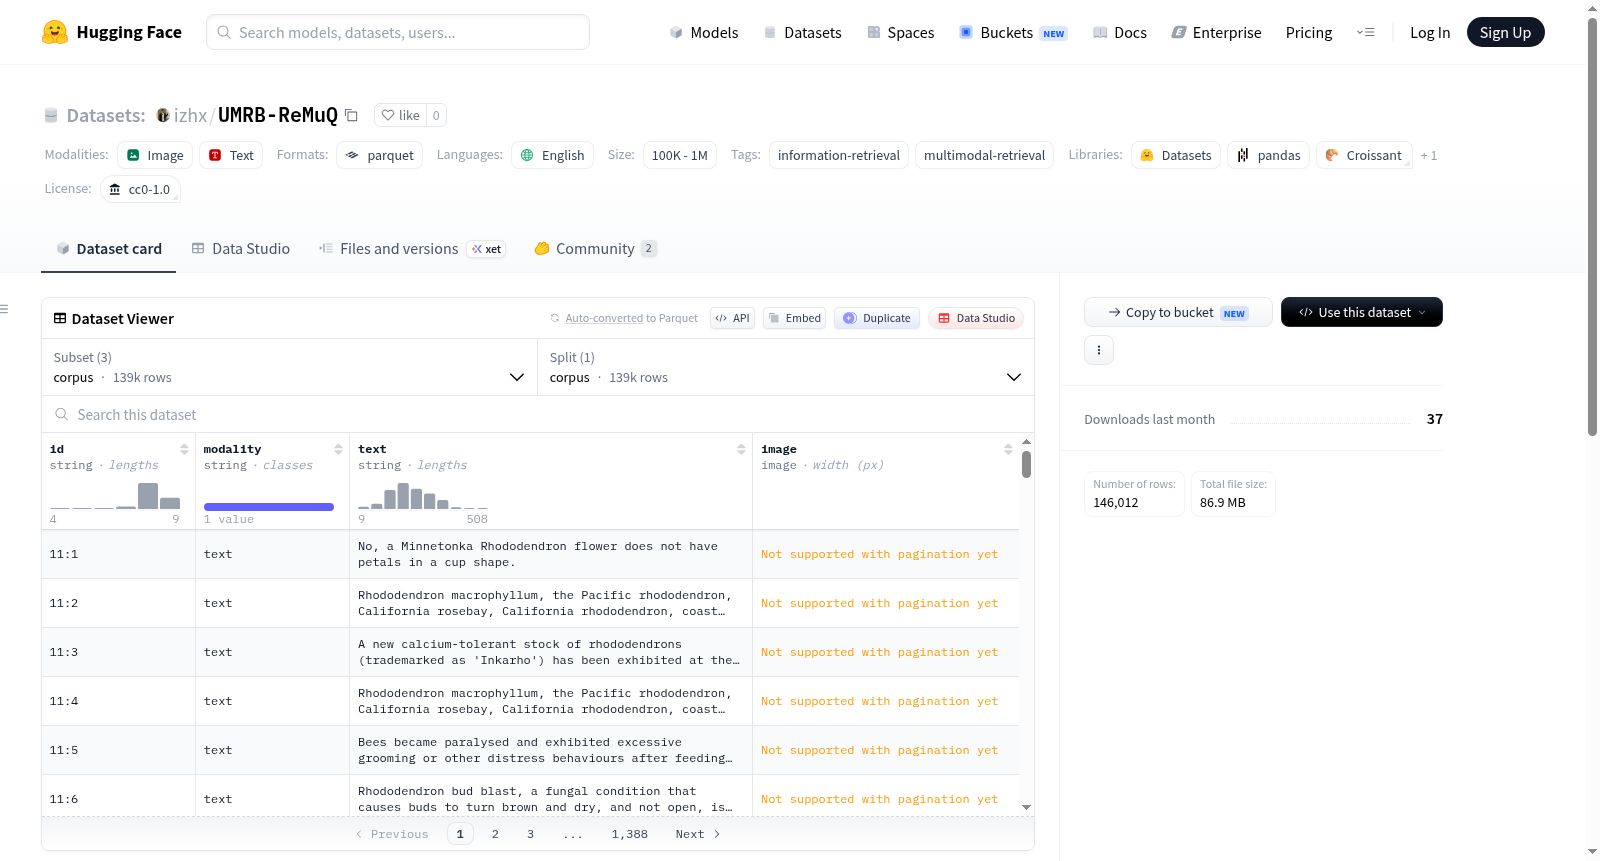
该数据集用于信息检索和多模态检索任务,包含三个配置:qrels、corpus和query。qrels配置用于评估查询与语料库的相关性,包含查询ID、Q0、语料库ID和相关性分数。corpus配置包含语料库的ID、模态、文本和图像信息。query配置包含查询的ID、模态、文本和图像信息。数据集的分割包括测试集,分别对应不同的数据文件。数据集的许可证为CC0-1.0。

This dataset is designed for information retrieval and multimodal retrieval tasks, containing three configurations: qrels, corpus, and query. The qrels configuration is used to evaluate the relevance between queries and the corpus, including query-id, Q0, corpus-id, and relevance score. The corpus configuration contains the corpuss id, modality, text, and image information. The query configuration contains the querys id, modality, text, and image information. The dataset splits include a test set, each corresponding to different data files. The dataset is licensed under CC0-1.0.
提供机构:
izhx
搜集汇总
数据集介绍
izhx/UMRB-ReMuQ 数据集图片
构建方式
在信息检索领域,多模态查询的引入为知识获取开辟了新维度。izhx/UMRB-ReMuQ数据集源自ACL 2023收录的研究工作,其构建基于端到端的多模态知识检索框架。该数据集精心设计了三个核心配置:query(查询集)、corpus(语料库)和qrels(相关性判定集)。查询集与语料库均包含文本与图像两种模态信息,每条数据由唯一标识符、模态类型、文本描述及对应图像构成。相关性判定集则记录了查询与语料库条目间的匹配关系,通过评分量化相关程度。数据以Parquet格式存储,共包含138,794条语料条目、3,609条查询及其对应的相关性标注,为多模态检索研究提供了标准化基准。
特点
该数据集的核心特色在于其多模态查询与文本语料之间的跨模态检索机制。不同于传统纯文本检索,UMRB-ReMuQ的查询端融合了图像与文本双重信息,而语料库端仅包含文本内容,这种非对称设计精准模拟了现实场景中用户以图文组合方式表达检索需求的情形。数据集规模适中,语料库涵盖近14万条目,查询与相关性标注数量均超过3,600条,兼顾了实验效率与统计显著性。此外,采用CC0-1.0许可协议发布,消除了使用限制,便于学术界与工业界广泛采用。其结构化的Parquet格式亦确保了数据加载与处理的高效性。
使用方法
使用该数据集进行多模态检索研究时,研究人员可借助HuggingFace Datasets库便捷加载。通过指定config参数为'query'、'corpus'或'qrels'即可获取对应子集。典型工作流程包括:首先加载查询集与语料库,利用预训练多模态编码器(如CLIP)分别对查询中的图文对和语料库中的文本进行向量化表示;随后计算查询与语料库条目间的相似度得分;最后依据qrels中的相关性标注评估检索性能,常用指标包括平均倒数排名(MRR)和归一化折损累计增益(NDCG)。该数据集亦可直接用于训练端到端的跨模态检索模型。
背景与挑战
背景概述
在信息检索领域,随着多模态数据的爆炸式增长,传统的基于单一文本模态的检索系统已难以满足用户对复杂查询的精准需求。izhx/UMRB-ReMuQ数据集由Man Luo、Zhiyuan Fang、Tejas Gokhale、Yezhou Yang和Chitta Baral等研究人员于2023年在ACL会议上提出,旨在解决多模态查询下的端到端知识检索问题。该数据集聚焦于图像-文本对到文本的检索任务,通过整合视觉与语言信息,推动检索系统从单模态向多模态融合的范式转变。作为ReMuQ项目的衍生资源,它提供了3609个查询样本、138794个语料库条目及相关相关性标注,为评估多模态检索算法提供了标准化基准,对自然语言处理与计算机视觉交叉领域的研究产生了重要影响。
当前挑战
该数据集面临的核心挑战在于多模态查询的语义对齐与噪声处理。领域问题层面,传统检索模型难以有效融合图像与文本的异构特征,导致跨模态匹配精度不足,尤其在处理视觉信息与文本描述间的语义鸿沟时表现脆弱。构建过程中,研究人员需应对多模态数据标注的高成本与一致性难题:不同模态的查询与语料需精确对应,而图像质量、文字表述的歧义性以及相关性判断的主观性均可能引入标注偏差。此外,大规模语料库的构建要求平衡数据多样性与检索效率,确保覆盖广泛场景的同时避免冗余,这对数据筛选与验证流程提出了严苛要求。
常用场景
经典使用场景
在信息检索与多模态学习的交叉领域中,izhx/UMRB-ReMuQ数据集以其独特的图像-文本到文本检索任务,为研究者提供了一个评估多模态查询能力的标准平台。该数据集的核心使用场景在于,给定一个由图像和文本共同构成的复合查询,系统需从大规模语料库中精准定位最相关的文本段落。这一设定突破了传统单模态检索的局限,使得模型能够同时理解视觉与语义信息,从而在复杂场景下实现更精细的信息筛选与匹配。
实际应用
在实际应用层面,ReMuQ数据集所模拟的场景广泛存在于智能问答系统、辅助搜索工具以及社交媒体内容分析中。例如,用户可能上传一张产品照片并附上文字描述,系统需据此从知识库中检索出对应的说明书或用户手册。该数据集为开发能够理解视觉与语言双重线索的智能检索系统提供了训练与测试依据,其影响延伸至电商推荐、医疗图像辅助诊断、多模态对话系统等前沿领域,显著提升了人机交互的便捷性与智能性。
衍生相关工作
自ReMuQ数据集发布以来,它已催生了一系列富有影响力的研究工作。其中,Luo等人提出的端到端多模态知识检索框架是该数据集的核心奠基之作,该工作通过联合编码图像与文本查询,首次在ACL上展示了多模态检索的完整流程。后续研究在此基础上探索了更为精细的模态对齐机制、跨注意力融合网络以及基于预训练模型的迁移学习方法,这些工作共同推动了多模态信息检索领域从单模态向多模态范式的转变,并启发了对视觉问答、图文匹配等下游任务的深入思考。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

