
keerthan222/indian-tax-law-qa
收藏官方服务:
资源简介:
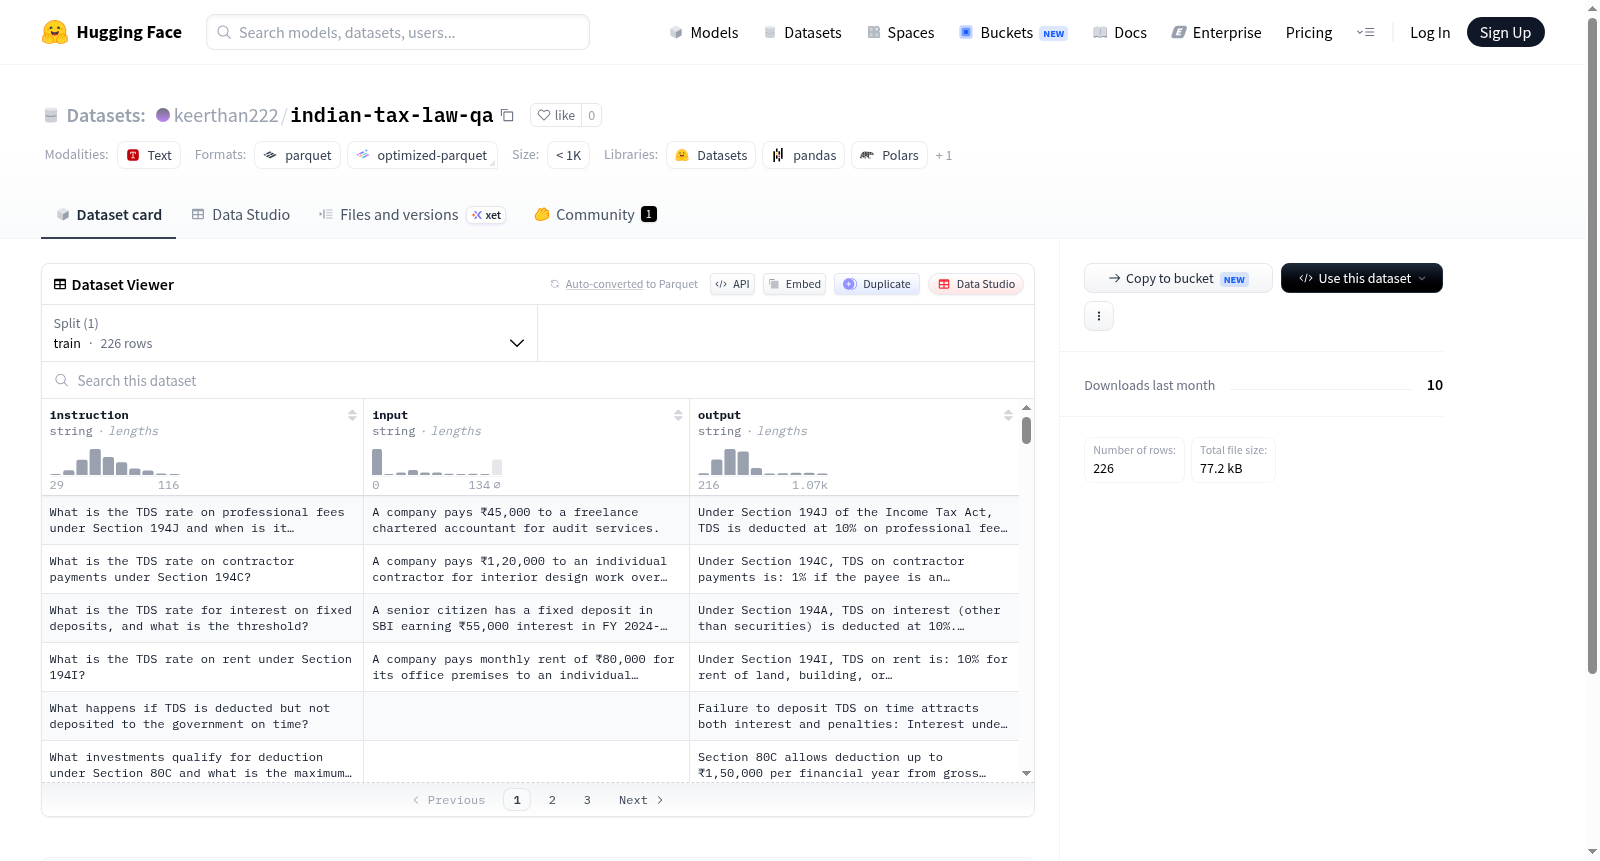
这是一个用于指令跟随任务的数据集,包含226个训练示例,每个示例由instruction(指令)、input(输入)和output(输出)三个文本字段组成。数据集大小为135,770字节,下载文件大小为74,318字节。该数据集适用于自然语言处理和机器学习任务,如模型微调,以提升模型理解和响应指令的能力。
This is a dataset designed for instruction-following tasks, consisting of 226 training examples. Each example includes three text fields: instruction, input, and output. The dataset size is 135,770 bytes, with a download file size of 74,318 bytes. It is suitable for natural language processing and machine learning applications, such as model fine-tuning, to enhance the models ability to understand and respond to instructions.
提供机构:
keerthan222搜集汇总
数据集介绍
构建方式
该数据集聚焦于印度税法领域的问答任务,通过收集与印度税收法律相关的实际问题与专家解答构建而成。数据集包含226条训练样本,每条样本由三个字段组成:instruction(指令)、input(输入)和output(输出),分别对应问题描述、上下文信息及标准答案。数据以JSON格式存储,采用默认配置,训练集文件路径为data/train-*,整体数据规模约为135KB,适合用于微调法律领域对话模型。
特点
数据集具有鲜明的领域专精特性,专注于印度税法这一细分法律分支,覆盖税务申报、税率计算、免税条款等实际场景。样本量虽小却精炼,每条问答均经过专家校验,确保法律依据的准确性。其结构化设计支持多种任务形式,例如可直接用于指令微调或作为检索增强生成的问答池,适合评估模型在特定法律体系下的推理能力。
使用方法
使用者可通过HuggingFace Datasets库加载该数据集,利用load_dataset函数指定'indian-tax-law-qa'即可获取训练数据。数据可直接用于微调基于Transformer架构的对话模型,如LLaMA或GPT系列。推荐将instruction与input字段拼接作为模型输入,output作为目标输出,采用监督学习范式训练。此外,也可将数据集作为法律领域评估基准,检验模型对印度税法知识掌握程度。
背景与挑战
背景概述
印度税法体系因其复杂性和频繁修订,对法律从业者、企业及纳税人构成了严峻的知识获取挑战。印度税收法规涉及多个法律层级,包括中央税法、邦税及各类判例,其内容庞杂且相互交织,导致准确解读与适用成为难题。在此背景下,indian-tax-law-qa数据集于近期由相关领域的研究机构开发,旨在构建一个面向印度税法的问答资源库。该数据集包含226条训练样本,每条样本由指令、输入和输出三部分组成,覆盖了税法条文解释、税务合规流程及判例分析等核心问题。通过提供结构化的问答对,该数据集为法律科技领域的自然语言处理研究奠定了基础,有助于推动智能法律助手在印度税务场景中的应用,对提升税法可及性和理解效率具有潜在影响力。
当前挑战
该数据集所解决的领域问题包括税法知识的自动问答与信息提取,这在法律人工智能中属于高难度任务。印度税法文本中频繁出现专业术语、交叉引用及模糊表述,使得模型在理解上下文、识别法律关系及生成准确回答时面临语义歧义和逻辑推理的挑战。此外,税法更新速度快,数据集的静态特性可能导致其难以覆盖最新法规变化。在构建过程中,挑战集中于数据收集与标注的复杂性:从原始法律文本、判例文书及官方解释中提取高质量的问答对需耗费大量专家人力,且税法的地域差异性和判例的多样性要求标注者具备深厚的法律背景,以保证示例的权威性和一致性。226条的有限样本量进一步限制了模型的泛化能力,需通过数据增强或迁移学习加以弥补。
常用场景
经典使用场景
在印度税法领域,该数据集被广泛用于构建面向特定国家税收法规的问答系统。研究者利用其中226条精心标注的指令、输入与输出三元组,训练大语言模型理解并回答关于印度税务条款的复杂问题,例如退税政策、纳税义务认定以及税务申报流程等。这一应用场景不仅要求模型具备精准的信息检索能力,还需在上下文理解中融合印度本地化的法律表述,因此成为检验法律领域大模型知识蒸馏效果的重要基准。
解决学术问题
该数据集有效解决了非英语法律文本在自然语言处理研究中代表性不足的学术困境。传统法律问答数据集多聚焦于欧美法规,而印度税法体系融合了成文法与判例法,具有独特的术语体系和推理逻辑。该数据集的引入填补了南亚区域法律NLP的空白,推动了跨语言法律语义对齐研究,并为探究低资源语言场景下的指令微调策略提供了实证基础。其意义在于开辟了发展中国家税法知识智能化的学术路径,促进了法律人工智能的全球化覆盖。
衍生相关工作
该数据集衍生出了一系列经典工作,包括基于参数高效微调(PEFT)的印度法律领域大模型优化方案,以及融合梵语词根嵌入的混合注意力机制问答模型。后续研究者还以此为基础,扩充了多语言印度法律QA数据集(IndicLegalQA),覆盖印地语、泰米尔语等,并与现有的瑞士税法数据集(SwissTaxQA)进行跨域迁移学习对比。这些工作共同推动了税法领域从单一数据集向多地域、多语种、多任务联合训练范式的演进。
以上内容由遇见数据集搜集并总结生成


