
saraNour/openfoodfacts-canada-brands
收藏官方服务:
资源简介:
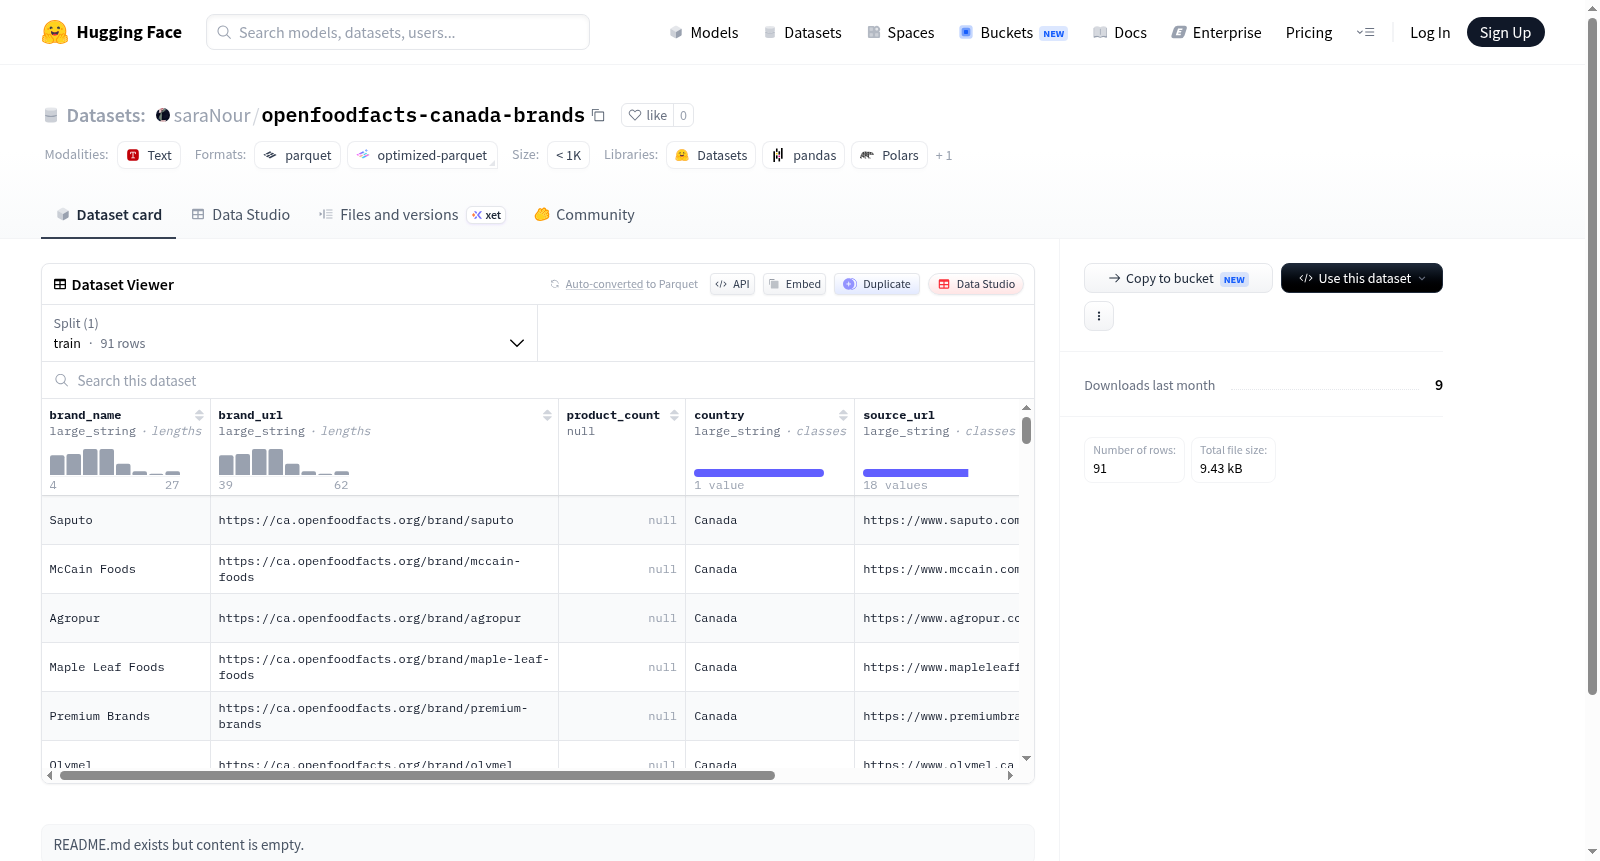
该数据集包含91个示例,涉及品牌信息,包括品牌名称、品牌URL、产品数量(当前字段为空值)、国家、来源URL和提取日期等字段。数据大小为14908字节,下载大小为6430字节,适用于训练任务。
This dataset contains 91 examples related to brand information, including fields such as brand name, brand URL, product count (currently null), country, source URL, and extraction date. The data size is 14908 bytes, with a download size of 6430 bytes, suitable for training tasks.
提供机构:
saraNour搜集汇总
数据集介绍
构建方式
该数据集源自Open Food Facts这一全球性开源食品信息数据库,聚焦于加拿大市场的品牌数据。构建过程中,通过自动化抓取与整理技术,从海量食品产品记录中提取品牌名称、品牌官方链接、所属国家、产品数量及数据提取日期等结构化字段,最终形成包含91条样本的紧凑型数据集。所有数据以统一格式存储于Hugging Face平台,便于研究者直接加载与使用。
特点
数据集虽规模精炼,却涵盖了加拿大食品品牌的核心元信息,包括品牌名称、URL及对应产品数量统计,同时标注了数据来源与提取时间戳,确保了信息的可追溯性与时效性。其特色在于聚焦单一国家市场,为区域食品品牌分析、市场占有率研究及供应链溯源提供了高度针对性的数据基底。
使用方法
用户可通过Hugging Face的`datasets`库直接加载该数据集,调用`load_dataset('openfoodfacts-canada-brands')`即可获取训练集。加载后的数据结构清晰,包含brand_name、brand_url、product_count等字段,便于使用Pandas等工具进行品牌排名、市场竞争格局可视化或与Open Food Facts其他数据集进行交叉分析。
背景与挑战
背景概述
随着食品工业的全球化与消费者对食品透明度需求的日益增长,食品标签数据集在食品安全监管、品牌溯源及市场分析等领域扮演着关键角色。Open Food Facts作为全球领先的开放食品数据库,其加拿大品牌子集(openfoodfacts-canada-brands)由社区贡献者与研究人员于近年来联合构建,旨在系统化加拿大市场上食品品牌的元数据信息。该数据集涵盖品牌名称、品牌官网链接、产品数量、所属国家及数据提取时间等核心字段,为研究加拿大食品品牌分布、消费者偏好及市场监管提供了结构化基础。其开源特性与标准化格式,显著降低了食品品牌数据获取的门槛,推动了食品信息学与公共健康领域的交叉研究。
当前挑战
该数据集面临的首要挑战在于解决食品品牌数据碎片化与不完整性的领域问题——加拿大食品市场品牌繁多,且同一品牌在不同渠道的命名规范不一致,导致自动化品牌聚类与关联分析困难重重。构建过程中,数据主要依赖志愿者众包与网络爬虫技术,但品牌URL的时效性验证、产品计数字段的空缺(product_count列为null),以及仅包含91个样本的小规模限制,均暴露出数据稀疏性与质量控制的痛点。此外,地域范围仅限加拿大,限制了跨区域品牌对比研究的泛化能力,如何持续扩充数据源并保障数据鲜活性,成为维护该资源长期价值的核心挑战。
常用场景
经典使用场景
在食品科学与消费者行为研究的交汇地带,Open Food Facts 加拿大品牌数据集以其精细化的品牌信息聚合能力,成为剖析加拿大本土食品市场结构的关键工具。该数据集收录了91个食品品牌的名称、官方网页链接、所属国家、数据来源及提取日期等结构化信息,并关联各品牌对应的产品数量。研究者常利用该数据集进行品牌市场集中度分析、地域性食品品牌分布格局探索,以及跨国食品企业在加拿大的渗透程度评估。其简洁而明确的字段设计,使得基于品牌维度的统计分析与可视化展示变得高效可行。
实际应用
在现实商业与公共卫生领域,该数据集展现出多维度应用价值。市场分析师可借助品牌名称与产品数量的关联,快速绘制出加拿大主要食品类别的品牌份额示意图,辅助企业制定针对性的营销策略与渠道布局。政府监管机构与消费者保护组织能够基于品牌来源与官方网站链接,追踪食品标签信息的准确性,促进标识合规性与透明度。此外,营养学研究团队可将该数据集与数据库中的营养成分信息联用,建立品牌—产品—营养素的多层映射关系,为制定区域性膳食指南提供实证基础。
衍生相关工作
该数据集衍生了一系列推动食品信息学发展的开创性工作。基于其品牌列表,研究者构建了加拿大食品品牌知识图谱,实现了品牌与产品、成分、包装信息之间的语义关联查询。另有一些工作利用该数据集的品牌名称与产品数量字段,训练了食品品牌识别与分类的机器学习模型,用于自动抽取非结构化电商页面中的品牌实体。还有团队将该数据集与加拿大统计局的人口普查数据融合,探索不同省份的品牌多样化程度与居民饮食模式之间的空间相关性,开启了计算社会科学与食品科学交叉研究的新范式。
以上内容由遇见数据集搜集并总结生成


