
MedFrameQA
收藏官方服务:
资源简介:
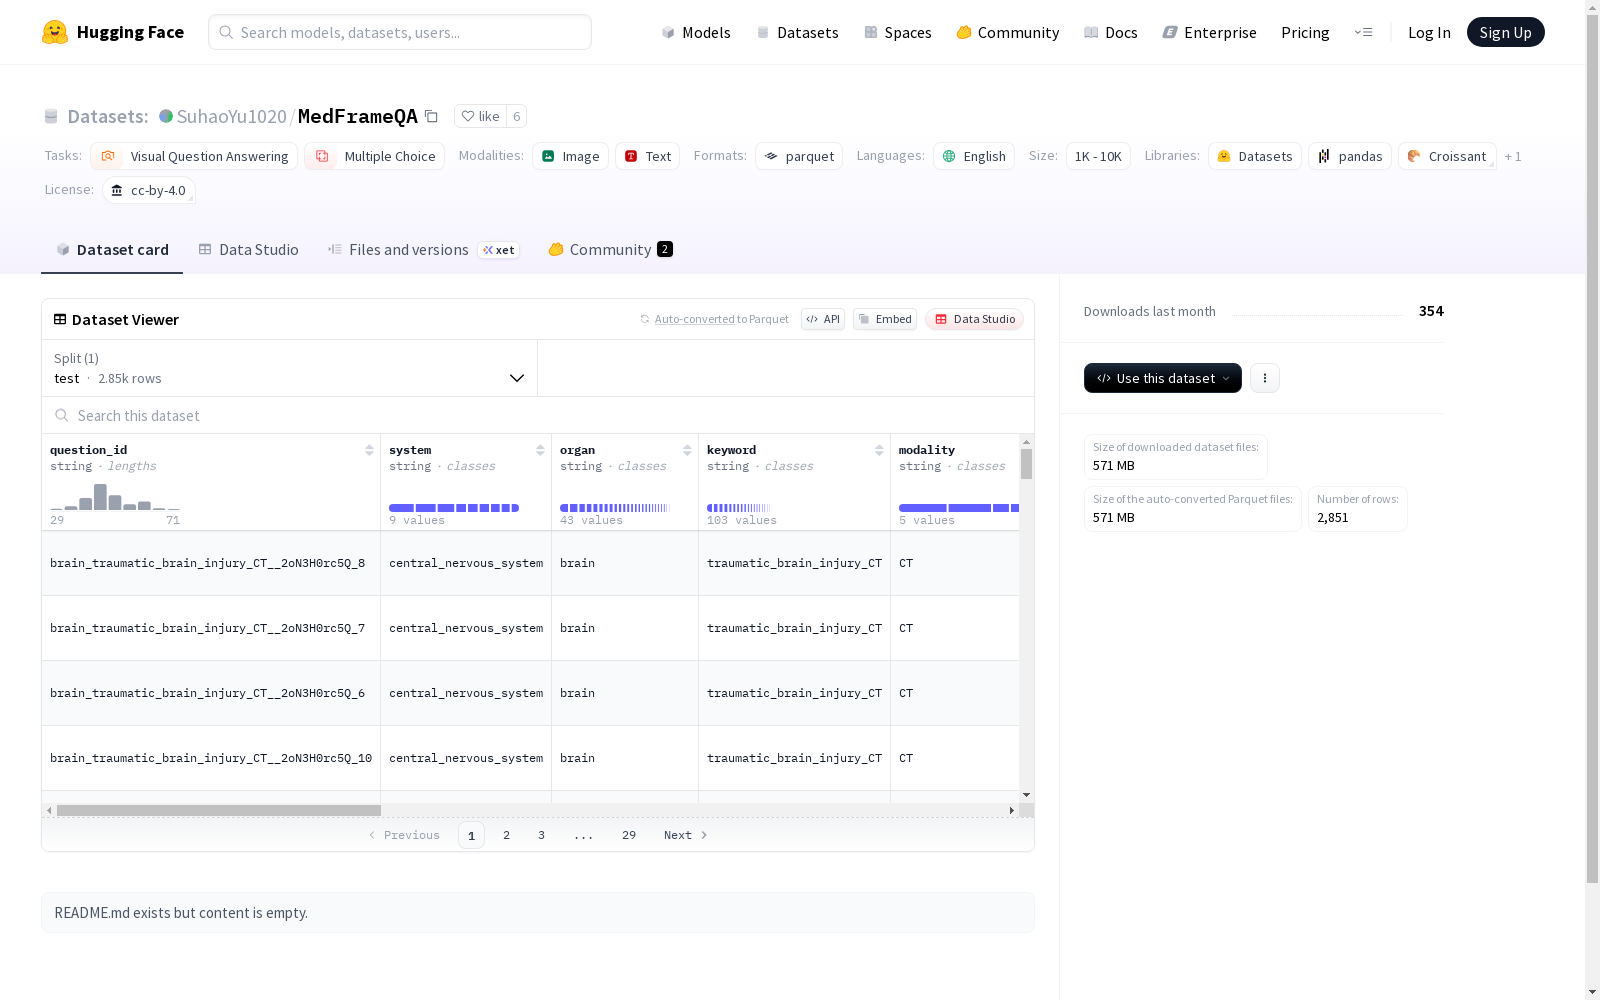
这是一个医学问答数据集,包含了问题ID、系统、器官、关键词、模态、视频ID、问题、选项、正确答案和推理链等多个字段。数据集分为训练集,共有2851个示例。
This is a medical question answering dataset that consists of multiple fields including question ID, system, organ, keywords, modality, video ID, question, options, correct answer, and reasoning chain. The dataset is split into the training set, which contains a total of 2851 instances.
创建时间:
2025-05-16
搜集汇总
数据集介绍
构建方式
在医学视觉问答领域,MedFrameQA数据集通过系统化采集临床医学影像与对应问题构建而成。该数据集整合了多模态医学图像资源,涵盖不同器官系统和影像模态,每个样本均包含序列化图像数据与结构化临床问题。专业医学团队对问题与答案进行精准标注,确保医学知识的准确性和逻辑严谨性,最终形成包含2851个测试样本的标准化数据集。
特点
该数据集最显著的特征在于其多维度医学知识表示体系。每个数据样本均配备完整的元数据系统,包括器官分类、关键词索引和影像模态标注,同时提供五帧连续医学图像序列。问题设计采用多项选择形式,并附有专业医学推理链条,既考察基础医学知识也评估临床推理能力,形成层次分明的医学认知评估框架。
使用方法
研究者可通过加载标准数据文件直接获取结构化样本,每个样本包含完整的图像序列与问答对。使用时应遵循视觉问答任务标准流程,将医学图像输入视觉编码器同时处理文本问题,通过多模态融合机制生成预测答案。评估阶段需对比模型输出与标注的标准答案,特别关注其医学推理链条的匹配程度,从而全面衡量模型在医学认知任务中的表现。
背景与挑战
背景概述
医学视觉问答作为人工智能与临床医学交叉的前沿领域,致力于构建能够理解医学影像并回答专业问题的智能系统。MedFrameQA数据集由医学人工智能研究团队于2023年创建,聚焦于多模态医学影像与文本的交互理解,涵盖放射学、病理学等关键医学学科。该数据集通过整合2851组包含序列医学影像、专业问题及多选项答案的样本,建立了涵盖不同器官系统、成像模态的标准化评估基准,显著推动了临床决策支持系统与医学教育智能化的发展进程。
当前挑战
医学视觉问答领域面临的核心挑战在于模型需同时掌握医学影像的语义解析与临床知识的深度推理。具体而言,系统必须准确识别不同成像模态下的病理特征,并建立其与临床症状的复杂映射关系。在数据集构建过程中,研究者需要克服医学影像标注的专业壁垒,确保多位临床专家对标注结果达成共识,同时需解决多序列影像时序关联性的表示难题,以及医学术语与视觉特征之间的跨模态对齐问题。
常用场景
经典使用场景
在医学视觉问答研究领域,MedFrameQA数据集通过结合多帧医学影像与专业问答,为多模态医学人工智能系统提供了标准化的评估基准。该数据集涵盖2851个测试样本,每个样本包含连续医学图像序列与对应的临床问题,要求模型基于视觉信息推断正确答案。这种设计模拟了真实临床诊断中医生观察连续影像并做出判断的过程,成为评估医学视觉推理能力的经典范式。
衍生相关工作
围绕MedFrameQA数据集已衍生出多项重要研究工作,包括基于注意力机制的多帧医学影像理解模型、结合医学知识图谱的视觉推理框架,以及针对医学领域的多模态预训练方法。这些工作不仅提升了医学视觉问答的技术水平,还推动了医学人工智能领域的标准化评估体系建立。相关成果为后续医学多模态大模型的发展奠定了坚实基础,促进了医学AI从理论研究向临床应用的转化。
数据集最近研究
最新研究方向
在医学视觉问答领域,MedFrameQA数据集正推动多模态推理研究的前沿探索。该数据集整合医学影像与结构化临床问题,聚焦于跨器官、多模态的深度语义理解,为构建可解释的医疗辅助系统提供关键支持。当前研究热点集中于结合视觉语言模型与因果推理机制,通过解析图像序列中的病理特征与文本推理链,提升模型对复杂医学场景的决策透明度。这一方向不仅响应了临床对可信人工智能的迫切需求,更在罕见病诊断和手术规划等高风险场景中展现出变革潜力,为智能医疗的标准化发展奠定了数据基石。
以上内容由遇见数据集搜集并总结生成


