issai/KazMix-3
收藏资源简介:
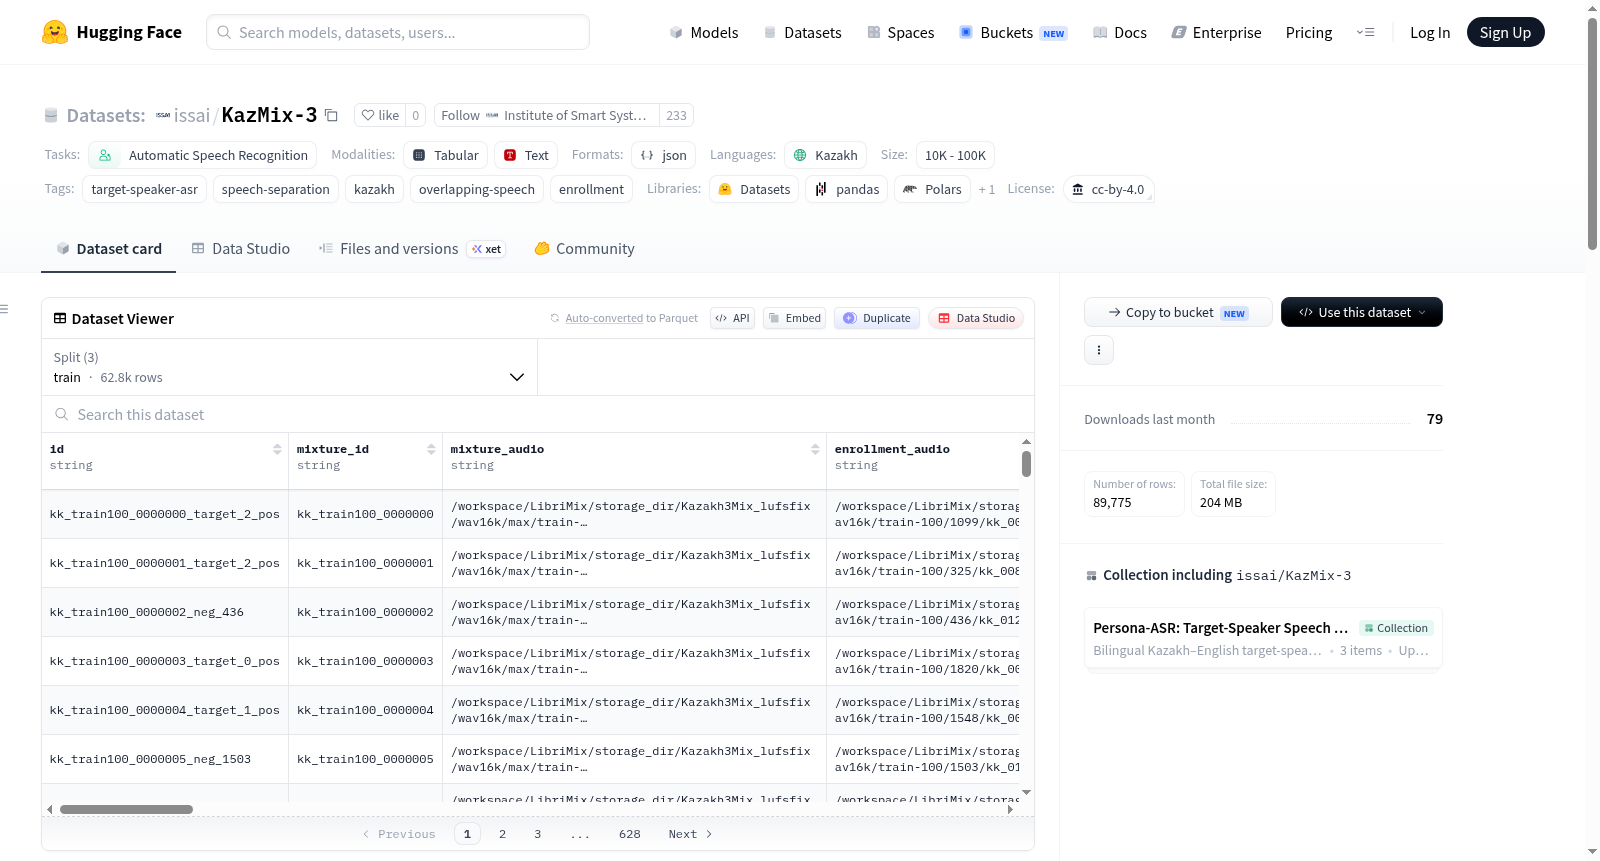
--- license: cc-by-4.0 language: [kk] task_categories: [automatic-speech-recognition] tags: [target-speaker-asr, speech-separation, kazakh, overlapping-speech, enrollment] pretty_name: KazMix-3 size_categories: [10K<n<100K] --- # KazMix-3 Kazakh three-speaker overlapping-speech dataset for **target-speaker ASR (TS-ASR)**, released with the [Persona-ASR](https://github.com/IS2AI/Persona_ASR) project. Given a short **enrollment** utterance of a target speaker and a **3-speaker mixture**, the task is to transcribe only the target speaker, or reject the utterance when the target is absent. This repository ships the **mixture manifests** and **generation scripts**, not the audio. Mixtures are derived from the **Kazakh Speech Dataset (KSD, [OpenSLR 140](https://www.openslr.org/140/))**; download KSD and run the scripts to reproduce the audio locally. ## Splits | Split | Total | Positive (target present) | Negative (target absent) | |---|---|---|---| | `train_clean_100` | 62,775 | 41,850 | 20,925 | | `val` | 13,500 | 9,000 | 4,500 | | `test` | 13,500 | 9,000 | 4,500 | Positive trials contain the enrolled target speaker and carry its transcript; negative trials do not contain the target (the model should emit no target transcript). Speakers are disjoint across splits. ## Files - `train_clean_100_kazakh3mix_lufsfix_posneg.json`, `val_kazakh3mix_lufsfix_posneg.json`, `test_clean_kazakh3mix_lufsfix_posneg.json` - `scripts/` — LUFS-uniform 3-speaker mixture generation (`rerender_kazakh3mix_lufs_uniform.py`) and manifest building. ## Manifest fields | Field | Description | |---|---| | `mixture_audio` | 3-speaker mixture (16 kHz) | | `enrollment_audio` | Target-speaker enrollment utterance | | `transcript` | Target reference transcript (empty for negatives) | | `speaker_id`, `target_speaker_id`, `target_index` | Target identity and its source index in the mixture | | `sample_type`, `class`, `label`, `is_target_present` | Positive/negative trial labels | | `snr_db`, `lufs_per_source`, `clip_scale` | Mixing SNR and per-source loudness (LUFS-uniform) | | `s1_path`, `s2_path`, `s3_path`, `source_speaker_ids`, `clean_source_rel` | Source provenance for regeneration | The full field list is present in each JSON entry. ## Mixing protocol Three-speaker mixtures in the LibriMix `clean`/`max` style, loudness-normalized to a uniform LUFS across sources. Each mixture designates one target speaker; the enrollment is a *different* utterance from that speaker. ## Regenerating the audio 1. Download KSD from https://www.openslr.org/140/. 2. Run `scripts/rerender_kazakh3mix_lufs_uniform.py`, pointing it at your local KSD path (see the [Persona-ASR repo](https://github.com/IS2AI/Persona_ASR) for full setup and dependencies). ## License and citation Manifests and scripts are released under CC BY 4.0; the underlying audio (KSD, OpenSLR 140) retains its own license. Please cite Persona-ASR and KSD. ```bibtex @article{persona_asr, title = {Persona-ASR: Bilingual Target-Speaker Speech Recognition for Kazakh--English Overlapping Speech}, author = {Meiramov, Rakhat and Rakhimzhanova, Tomiris and Taibassarov, Adil and Makhataeva, Zhanat and Varol, Huseyin Atakan}, year = {2026} } ```
Kazakh three-speaker overlapping-speech dataset for target-speaker ASR (TS-ASR), released with the Persona-ASR project. Given a short enrollment utterance of a target speaker and a 3-speaker mixture, the task is to transcribe only the target speaker, or reject the utterance when the target is absent.