small-german-medical-dialogue-dataset-for-moshi
收藏资源简介:
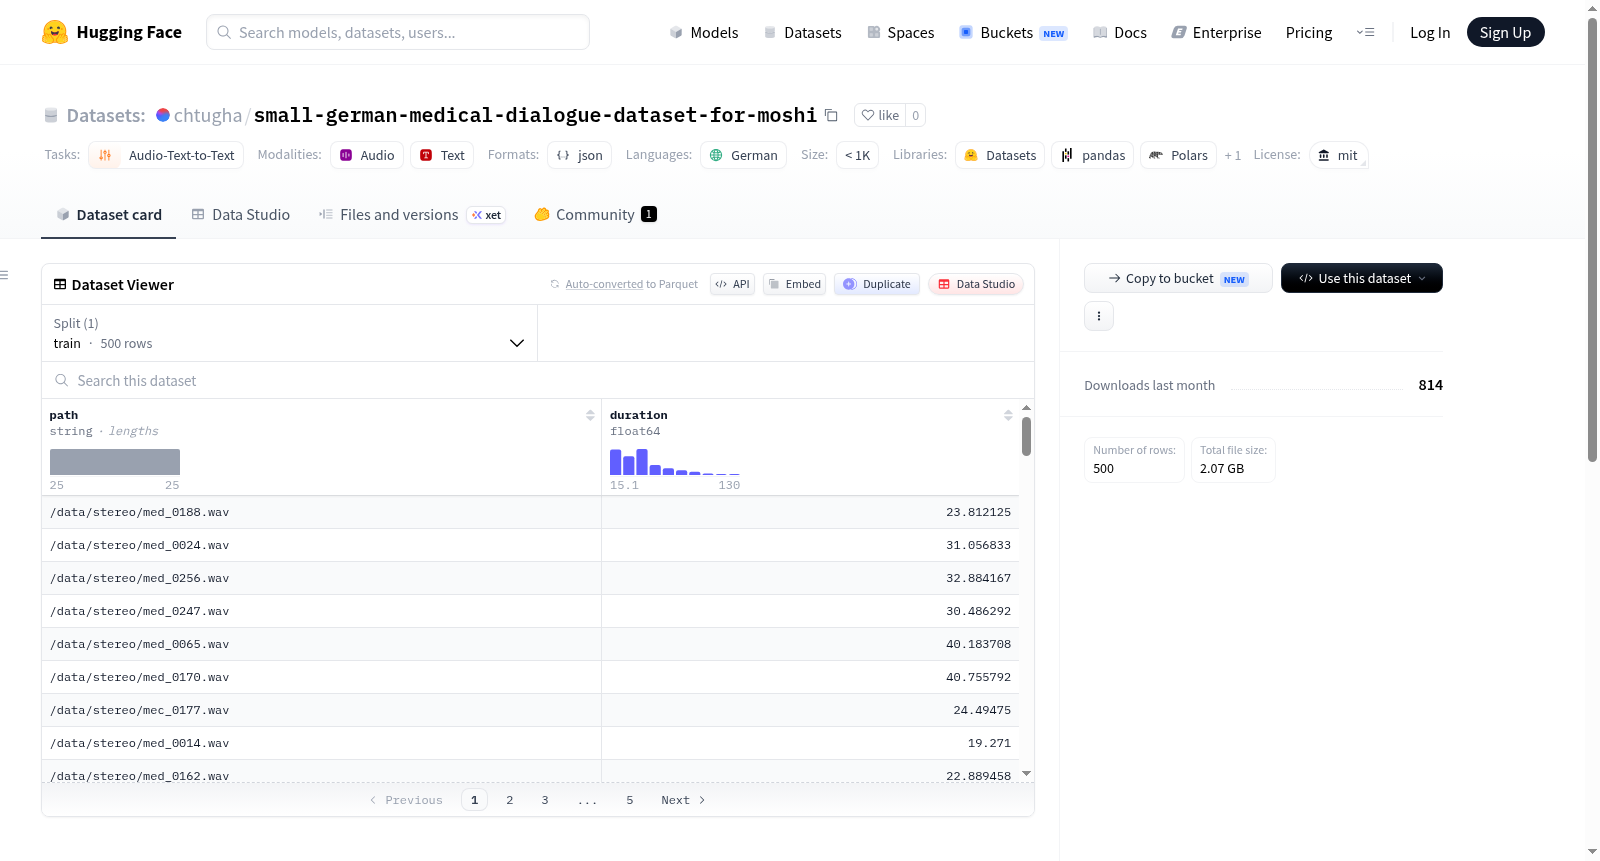
该数据集是一个小型德语对话数据集,包含500个完全虚构的医疗电话对话,模拟患者与全科医生办公室之间的交流场景。所有数据均为人工合成:首先通过人工智能生成文本对话内容,随后使用OpenAI的tts-1-hd技术生成音频,并为对话添加了精确的时间戳转录文本。数据集总计约15小时的音频对话,主题涵盖血压、血糖、胆固醇等常见医疗咨询内容。音频采用立体声格式,左右声道分离:说话人A(如患者)仅出现在左声道,说话人B(如医生办公室人员)仅出现在右声道。转录文本仅对应左声道的时间戳内容。该数据集完全由合成数据构成,不包含任何个人真实信息,适用于音频-文本转换、对话系统、语音识别等任务的研究与开发,尤其在德语医疗对话场景中具有一定的参考价值。但需注意,数据集在逻辑、语言、医学等方面的正确性未经全面验证,使用时需自行评估。
数据集概览:Small German Medical Dialogue Dataset for Moshi
数据集名称: Small German Medical Dialogue Dataset for Moshi
许可证: MIT
任务类别: 音频-文本到文本 (audio-text-to-text)
语言: 德语 (de)
数据规模: 少于1000条 (n<1K)
数据集描述
该数据集包含500条完全虚构的医疗电话对话,模拟患者与全科医生办公室之间的通话。
-
生成方式:
对话文本首先由AI生成,然后使用 OpenAI tts-1-hd 模型将文本合成为音频,并附带了精确的时间戳转录文本。 -
音频格式:
音频文件为立体声,声道分离:- 左声道:仅包含说话者 A
- 右声道:仅包含说话者 B
转录文本仅包含左声道(说话者 A)的时间戳文本。
-
内容主题:
数据集包含约 15小时的对话,内容涉及血压、血糖、胆固醇等常见医疗话题,模拟患者致电医生的场景。 -
数据性质:
所有数据均为人工生成,不包含任何个人真实信息。
免责声明
数据集的创建者声明,已抽查部分音频,但未对全部数据进行逐条验证,不对数据的逻辑、语言、数学、医学或伦理上的正确性承担责任。