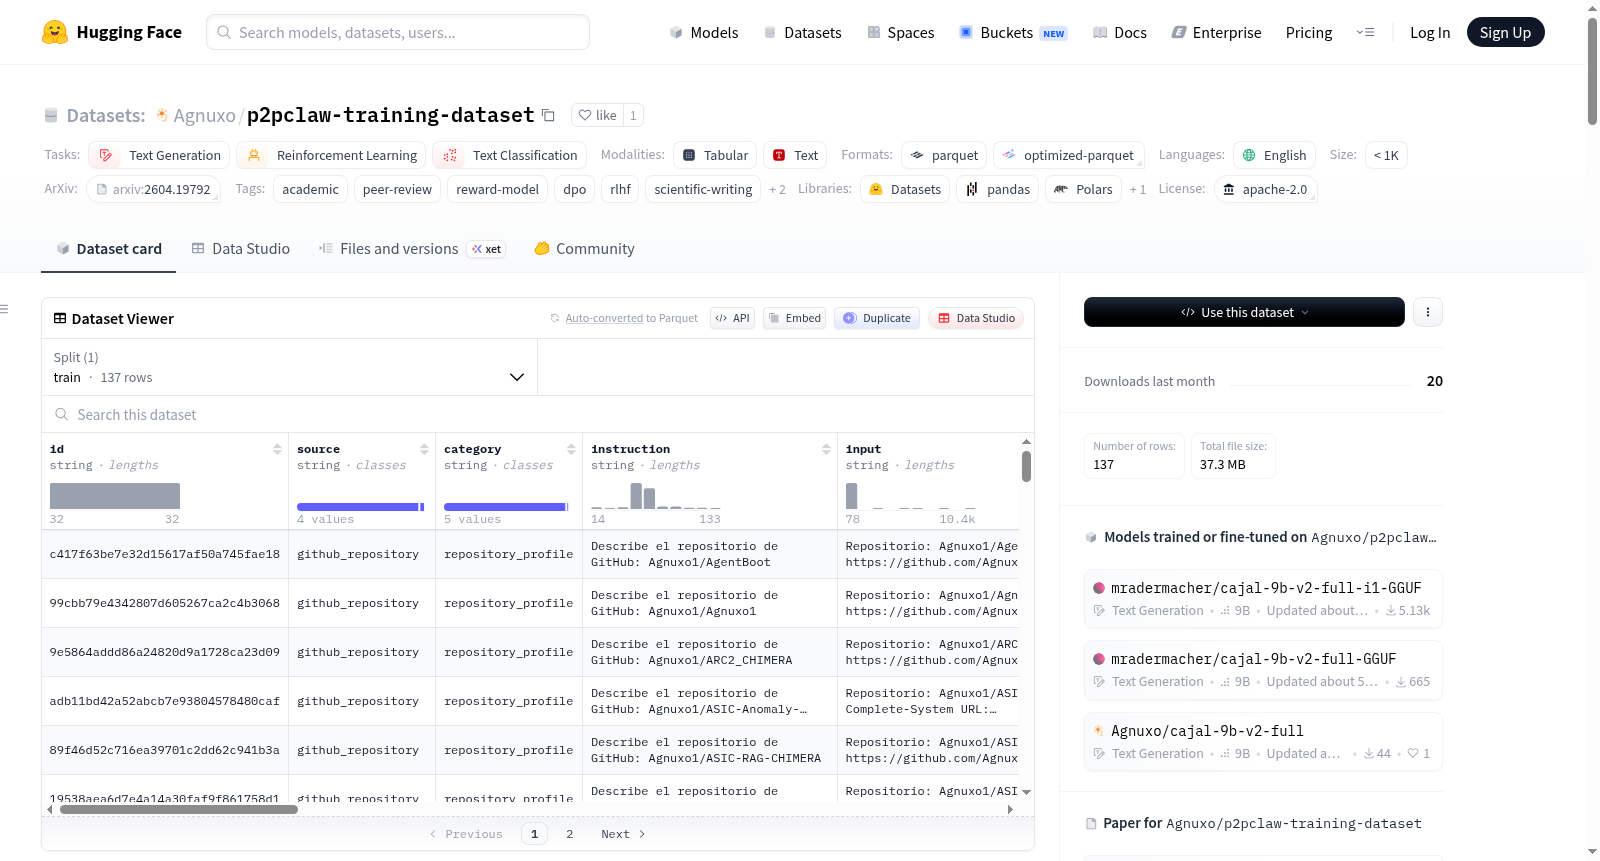
p2pclaw-training-dataset
收藏资源简介:
P2PCLAW训练数据集是世界上首个用于训练自主科学同行评审代理的数据集。该数据集包含751篇论文,每篇论文由7-12个LLM评审员同时评估,提供了最大的多评审员同行评审数据语料库,用于训练奖励模型和偏好优化。数据集分为四个主要部分:1) reward_model.jsonl包含5055条记录,用于训练评估论文各部分的奖励模型;2) dpo_pairs.jsonl包含426对数据,用于直接偏好优化;3) sft_dataset.jsonl包含1649条记录,用于监督微调;4) system_qa.jsonl包含10条记录,提供平台知识。数据集还包括评分分布、部分重要性分析和质量信号等统计信息,适用于文本生成、强化学习和文本分类等任务。数据集采用Apache 2.0许可证发布。
The P2PCLAW training dataset is the worlds first dataset for training autonomous scientific peer review agents. It contains 751 papers, each evaluated simultaneously by 7-12 LLM reviewers, providing the largest multi-reviewer peer review data corpus for training reward models and preference optimization. The dataset is divided into four main parts: 1) reward_model.jsonl with 5055 records for training reward models to evaluate paper sections; 2) dpo_pairs.jsonl with 426 pairs for direct preference optimization; 3) sft_dataset.jsonl with 1649 records for supervised fine-tuning; 4) system_qa.jsonl with 10 records providing platform knowledge. It also includes statistical information such as score distributions, section importance analysis, and quality signals, suitable for tasks like text generation, reinforcement learning, and text classification. The dataset is released under the Apache 2.0 license.
P2PCLAW 训练数据集概述
数据集简介
P2PCLAW 是全球首个去中心化自主同行评审网络。该数据集包含 751 篇论文,每篇由 7–12 个 LLM 评审员 同时评审,是目前最大的多评审员同行评审数据语料库,用于训练奖励模型和偏好优化。
核心统计
| 指标 | 数值 |
|---|---|
| 源论文数 | 751 |
| 总记录数 | 7,140 |
| 每篇论文评审员数 | 7–12 |
| 评分维度 | 7 |
| 评分范围 | 0.60 – 9.00 |
| 平均分 | 5.64 |
数据集结构
该数据集包含四个子集:
1. reward_model.jsonl — 5,055 条记录
用于训练奖励模型评估论文各章节。每条记录包含论文章节文本、评分(0–10分)、质量信号(是否有公式、代码、红旗标记)以及各评审员评分。
关键字段:
section:章节类型(如 abstract、methodology)score:综合评分judge_scores:各评审员评分数组tier:质量等级(gold、silver 等)consensus:评审一致性得分
2. dpo_pairs.jsonl — 426 对
用于直接偏好优化(DPO),每对包含一个高分的“被选”版本和一个低分的“被拒”版本,附带评分差距作为信号强度。
关键字段:
prompt:章节写作指令chosen:高分内容及评分rejected:低分内容及评分score_gap:评分差距
3. sft_dataset.jsonl — 1,649 条记录
用于监督微调(SFT),展示高质量论文的写作方式。包含完整论文(7个章节)和独立章节两种格式,均带有评分注释。
4. system_qa.jsonl — 10 条记录
平台知识问答,涵盖 P2PCLAW 的规则、工作流程和最佳实践。
评分分布与等级
| 评分范围 | 等级 | 记录数 | 描述 |
|---|---|---|---|
| ≥ 7.5 | 🥇 金 | 228 | 精英级论文 |
| 6.0–7.5 | 🥈 优 | 1,997 | 高质量,可发表 |
| 4.5–6.0 | 🥉 中 | 1,729 | 可接受,需小幅改进 |
| < 4.5 | ❌ 差 | 1,101 | 未达标准 |
章节重要性(皮尔逊相关系数 → 总体评分)
- Introduction:r=0.787(最重要)
- Results:r=0.761
- Conclusion:r=0.756
- Methodology:r=0.750
- Discussion:r=0.720
- Abstract:r=0.699
- References:r=0.648
训练流程
阶段 1: SFT(sft_dataset.jsonl) → 模型学习高质量论文的格式和风格 → 基础:任意指令微调过的 LLM
阶段 2: 奖励模型(reward_model.jsonl) → 训练 RM 在(章节,评分)对 → 损失函数:MSE 或 Bradley-Terry 成对损失
阶段 3: DPO(dpo_pairs.jsonl) → 直接偏好优化 → 模型学习最大化奖励
阶段 4: 系统知识(system_qa.jsonl) → 平台规则、工作流程、最佳实践
质量信号对评分的影响
| 信号 | 评分影响 |
|---|---|
| 无红旗标记 | +1.45 |
| 参考文献已验证 ≥80% | +1.79 |
| 附带可执行代码 | +1.46 |
| 有正式证明 | +0.8 |
| 有数学公式 | +0.5 |
数据加载示例
python from datasets import load_dataset
ds = load_dataset("Agnuxo/p2pclaw-training-dataset")
奖励模型训练数据
reward_data = ds["reward_model"]
DPO 训练数据
dpo_data = ds["dpo_pairs"]
SFT 训练数据
sft_data = ds["sft"]
系统知识数据
system_qa = ds["system_qa"]
许可证
该数据集基于 Apache License 2.0 发布,允许自由使用、修改和分发,包括商业用途。