
遇见数据集

wchai/govreport-longppl-keytokens

收藏
Hugging Face2026-05-30 更新2026-05-31 收录
官方服务:

资源简介:

GovReport LongPPL关键令牌数据集是一个用于计算LongPPL(长上下文语言建模评估指标)的预计算关键令牌跨度集合。LongPPL仅测量关键令牌(那些预测真正依赖于长上下文的令牌,占比小于10%)的困惑度,而不是平均所有令牌,从而更准确地评估长上下文语言建模性能。该数据集包含100个来自GovReport语料库的文档,总计4,867个关键令牌跨度,以字符偏移量表示,因此与分词器无关。数据来源是ccdv/govreport-summarization数据集的report字段和test分割,文档长度在5,000到32,768个令牌之间。评估器模型使用Qwen/Qwen3.6-27B,并遵循官方LongPPL默认超参数(trunc_len=4096, sliding_window=1024, alpha=2, beta=-2)。使用该数据集时,用户只需对目标模型进行前向传播,无需在评估时运行评估器,从而简化了LongPPL计算过程。

The GovReport LongPPL Key Tokens dataset is a collection of precomputed key-token spans for computing LongPPL, an evaluation metric for long-context language modeling. LongPPL measures perplexity only over key tokens (those tokens whose prediction genuinely depends on long-range context, accounting for <10% of tokens) instead of averaging over all tokens, providing a more accurate assessment of long-context language modeling performance. The dataset includes 100 documents from the GovReport corpus, with a total of 4,867 key-token spans represented as character offsets, making them tokenizer-independent. The data is sourced from the report field and test split of the ccdv/govreport-summarization dataset, with documents ranging from 5,000 to 32,768 tokens. The evaluator model used is Qwen/Qwen3.6-27B, and it follows the official LongPPL default hyperparameters (trunc_len=4096, sliding_window=1024, alpha=2, beta=-2). Using this dataset, users only need to perform a forward pass on the target model without running the evaluator at evaluation time, simplifying the LongPPL computation process.
提供机构:
wchai
搜集汇总
数据集介绍
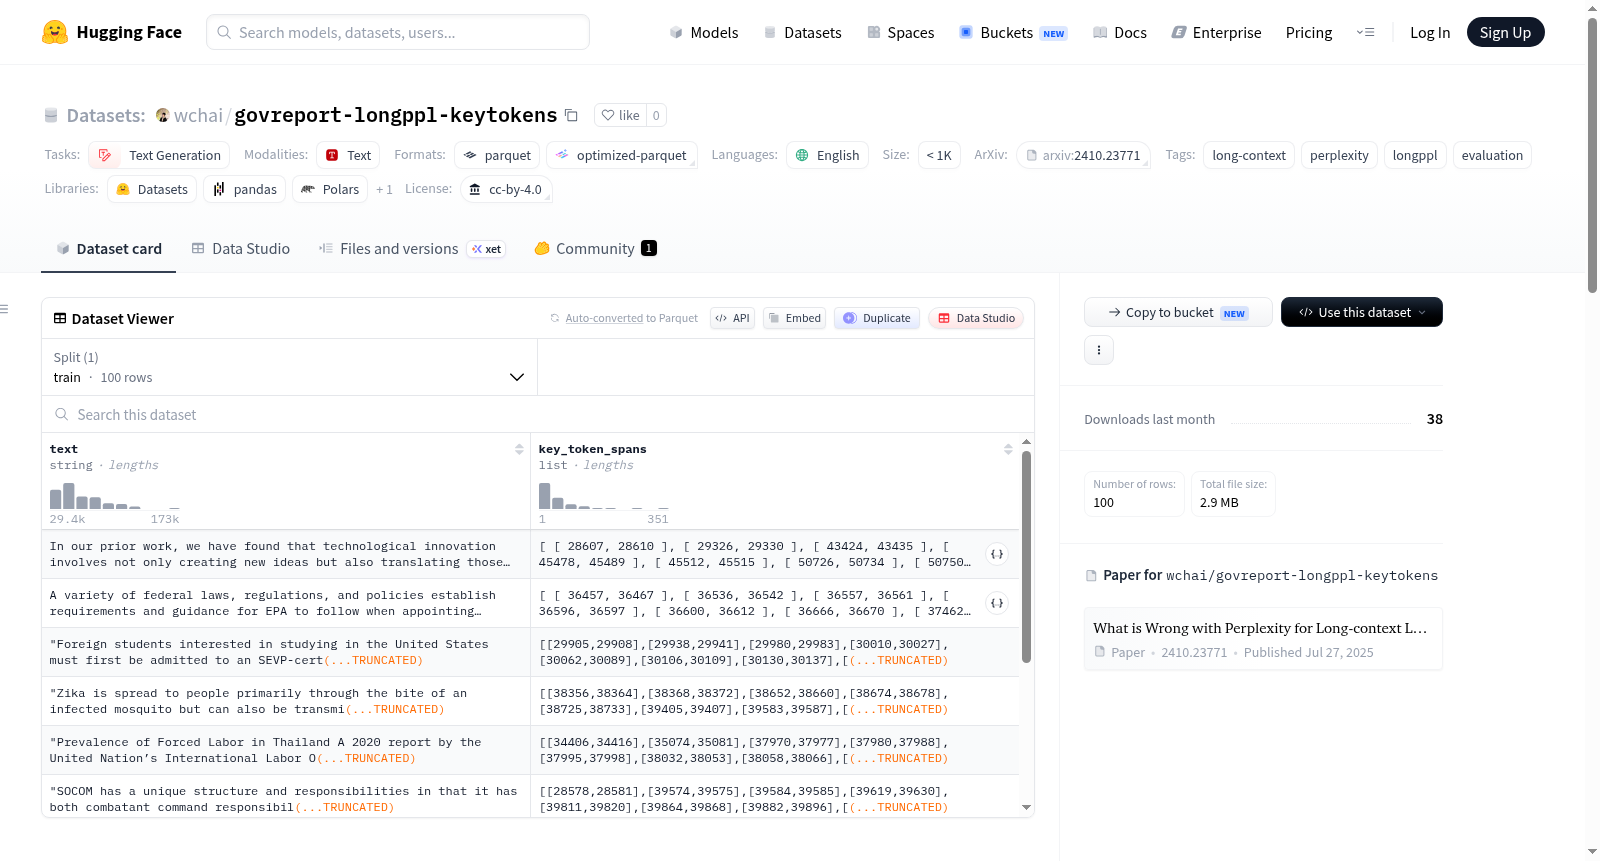
wchai/govreport-longppl-keytokens 数据集图片
构建方式
GovReport LongPPL Key Tokens数据集旨在为长文本语言模型的困惑度评估提供高效解决方案,基于LongPPL评估方法构建。其源头为ccdv/govreport-summarization数据集的test划分,选取文档长度介于5,000至32,768个token之间的政府报告。构建时采用Qwen/Qwen3.6-27B作为评估模型(原论文使用Qwen2-72B-Instruct,此处更小模型以适应单GPU),并沿用LongPPL的默认超参数:截断长度4,096、滑动窗口1,024、关键token选择阈值α=2和β=-2。最终从100篇文档中识别出4,867个关键token区间,形成tokenizer无关的字符偏移标记。
特点
该数据集的核心特点在于其预处理的关键token跨度(character intervals)设计。这些跨度仅覆盖不足10%的token,这些token的预测依赖长程上下文信息,从而使得困惑度计算聚焦于真正考验长文本建模能力的部分。所有跨度以字符偏移形式存储,具备模型无关性,可直接映射到任意目标模型的tokenizer输出上。相较于逐token平均的常规困惑度,LongPPL避免了短距离模式对评估结果的干扰,更精准反映模型的长文本感知能力。数据集规模精巧,仅含100条文本及约5,000个关键跨度,极大降低了评测时的计算开销。
使用方法
使用时需通过HuggingFace Datasets库加载数据集,获取每条样本的text字段及其对应的key_token_spans列表。关键步骤包括:首先,使用目标模型的tokenizer对text进行分词,并确保返回字符偏移映射(return_offsets_mapping=True);其次,依据字符区间的起止位置,将key_token_spans映射到具体的token索引上;最后,计算目标模型在这些关键token上的平均交叉熵损失,并取其指数得到LongPPL值。这种设计使得评估过程仅需一次前向传播即可完成,无需在评测时重复运行昂贵的关键token识别流程。
背景与挑战
背景概述
GovReport LongPPL Key Tokens数据集由Fang等人于2025年提出,旨在解决长上下文语言模型评估中的核心问题——传统困惑度指标在不区分关键与非关键令牌的情况下平均计算,无法准确反映模型对长程依赖的建模能力。该数据集基于公开的美国政府部门报告(GovReport语料库),由100篇长度在5000至32768令牌间的文档组成,预计算了仅占全文不足10%的关键令牌跨度。这些关键令牌通过Qwen3.6-27B评估模型进行长-短上下文损失对比筛选,使得后续评估目标模型时无需重复昂贵的前置计算,显著提升了评测效率。作为ICLR 2025收录论文LongPPL的配套资源,该数据集为长文本语言模型的标准化评估提供了重要基准,并推动了对长程依赖能力度量方法的深入探索。
当前挑战
主要挑战包括:第一,传统困惑度对所有令牌平等加权,无法区分语义上依赖于长程上下文的关键令牌与可通过短程模式预测的冗余令牌,导致评估结果无法真实反映模型对长文本的推理能力。第二,原始LongPPL方法依赖72B参数的大规模评估模型,资源开销极高,而本数据集在构建时被迫使用27B模型作为替代,虽然降低了硬件门槛,但导致绝对LongPPL值无法直接与论文结果对标。第三,关键令牌的选择对评估模型敏感,不同评估能力可能导致不一致的筛选结果,影响评估标准的可迁移性。第四,预计算的关键令牌跨度虽与分词器无关,但在实际映射至不同目标模型的分词方案时需精确处理字符偏移与令牌边界的对齐,可能引入额外误差。
常用场景
经典使用场景
GovReport LongPPL Key Tokens数据集专为长文本语言模型的评估而设计,其核心应用在于利用预计算的关键令牌跨度(key-token spans)高效计算LongPPL指标。在长文档处理场景中,传统困惑度(perplexity)因平等对待所有令牌而无法精准反映模型对长程依赖的真实建模能力。该数据集通过识别并仅对依赖长上下文的少数关键令牌进行困惑度计算,为研究者在GovReport语料库上提供了一种轻量级且精准的评估手段,尤其适用于测试模型在政府报告这类专业长文档上的上下文利用深度。
解决学术问题
该数据集直接回应了长上下文语言模型评估中的一个核心挑战:传统困惑度指标被大量无关令牌稀释,无法度量模型对长程依赖的有效利用。通过预先提取仅占令牌总数不到10%的关键令牌,LongPPL方法将评估焦点从全令牌平均转移到长上下文敏感的子集上,从而揭示模型在长序列处理中的真实表现。这一创新不仅为长上下文建模提供了更可靠的基准,还推动了评估范式的转变——从浮于表面的整体度量转向对关键信息的精准量化,对理解模型的长程记忆机制具有深远意义。
衍生相关工作
围绕LongPPL评估框架,已衍生出一系列相关工作。该数据集直接源于Fang等人发表于ICLR 2025的LongPPL方法,后者首次系统性地批判了传统困惑度在长上下文建模中的缺陷,并提出以关键令牌为中心的评估思路。在此基础上,后续研究可探索跨数据集的关键令牌识别一致性、不同评估器模型对关键令牌选择的影响,以及将LongPPL扩展至多语言或知识密集型任务。此外,该数据集提供了与原始论文不同的评估器配置(27B vs. 72B),为评估器规模与评估质量的关系研究提供了实证基础。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

