
jinsong8/FinRpt
收藏官方服务:
资源简介:
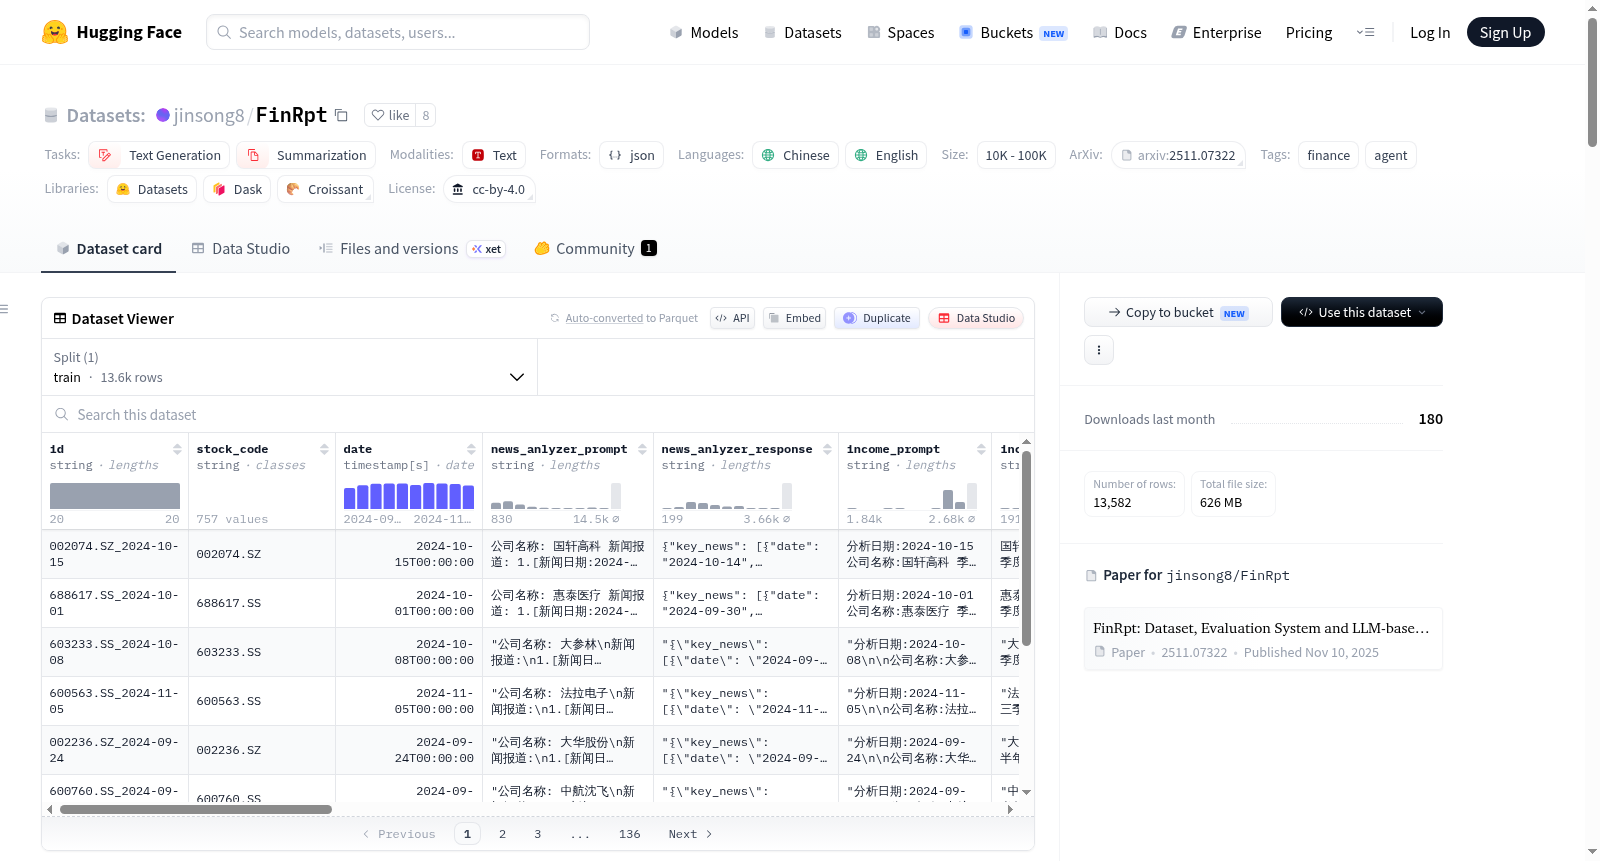
FinRpt是一个用于自动生成股票研究报告的大型高质量双语文(中文和英文)基准数据集。该数据集包含了公司股票代码和日期,以及用于生成报告的多源异构财务数据。数据集通过FinRpt-Gen多代理框架自动生成,并经过质量增强模块处理以确保生成内容的专业性和准确性。
FinRpt is a large-scale, high-quality, bilingual (English and Chinese) benchmark dataset designed for the automated generation of Equity Research Reports. It includes company stock codes, dates, and multi-source heterogeneous financial data for generating reports. The dataset is automatically generated using the FinRpt-Gen multi-agent framework and refined through a quality enhancement module to ensure professionalism and accuracy of the content.
提供机构:
jinsong8搜集汇总
数据集介绍
构建方式
FinRpt数据集的构建围绕自动化生成权益研究报告这一核心任务展开。其数据来源广泛,通过公共金融数据接口整合了公司概况、财务指标、公告、新闻、历史股价及市场指数等七类异构信息。生成过程并非依赖人工标注,而是借助名为FinRpt-Gen的多智能体框架,以GPT-4o作为核心语言模型,模拟人类金融分析师的工作流程,依次完成新闻提取、财务报表分析、风险识别等环节,并产出各智能体的中间输入与输出。为保障数据质量,所有生成内容均经过数据集增强模块的系统性审查与精炼,包括推荐评级校正器确保评级与市场趋势一致、专家撰写报告校正器提升专业准确性,以及语言模型润色器优化文本的可读性与连贯性。
特点
该数据集具备多项显著特点。首先,它是一个大规模、高质量的双语基准数据集,覆盖中文和英文,填补了金融领域长文本研究报告自动生成的数据稀缺空白。其次,其结构丰富,每个样本不仅包含最终报告,还保留了新闻分析、财务分析、风险评估等各智能体的提示与响应,为模型训练与过程分析提供了详尽资源。此外,数据经过多级质量增强,从评级一致性校验到专家内容审阅,再到语言润色,确保了报告的专业性与逻辑严谨性。最后,数据集专注于中国A股市场,样本数量介于1千至1万之间,为金融大语言模型的指令微调、文本生成及摘要任务提供了坚实的支撑。
使用方法
FinRpt数据集专为学术研究设计,适用于多种下游任务。用户可利用其丰富的提示-响应对进行指令微调,训练模型理解并执行复杂的金融分析指令。对于文本生成任务,模型可根据给定的股票代码和日期,结合多源异构数据生成结构完整、逻辑连贯的权益研究报告。数据中的财务摘要部分也可用于训练模型从季度收益数据中生成简洁摘要。使用时需注意,数据集内容不构成投资建议,其覆盖时间截至2024年11月初,且主要反映中国A股市场特征,可能不适用于其他市场。研究人员可直接从HuggingFace平台下载数据,并参考配套论文与代码库进行模型开发与评估。
背景与挑战
背景概述
在金融分析领域,权益研究报告作为投资决策的核心依据,其生成过程长期依赖资深分析师的深度解读与综合判断。然而,随着金融数据规模的爆炸式增长与市场动态的瞬息万变,传统人工撰写模式在效率与覆盖面上面临显著瓶颈。为弥合这一鸿沟,由Song Jin、Shuqi Li、Shukun Zhang与Rui Yan等研究人员于2025年提出的FinRpt数据集应运而生。该数据集由多智能体框架FinRpt-Gen自动生成,并经过专家修正与模型润色等增强模块的严格质检,旨在为大型语言模型在金融领域的应用提供高质量、双语的基准资源。其核心研究问题聚焦于如何利用异构金融数据驱动长文本、结构化的研究报告自动生成,从而推动金融智能分析范式的革新。
当前挑战
FinRpt数据集面临的核心挑战首先源于权益研究报告生成任务的复杂性:模型需同时整合公司概况、财务指标、公告新闻、历史股价等多源异构数据,并生成兼具逻辑连贯性与专业深度的长文本报告,这对语言模型的上下文理解与知识推理能力提出了极高要求。其次,在数据构建过程中,团队需克服自动化生成内容与真实市场趋势的一致性难题,例如通过推荐评级校正器确保投资评级与市场实际走向相符;此外,为保障内容的专业性与准确性,数据集引入了专家撰写的真实报告进行交叉验证,但专家资源的稀缺性与成本控制构成了另一重挑战,而最终的语言模型润色环节还需在提升可读性的同时避免引入语义偏差。
常用场景
经典使用场景
FinRpt数据集的核心应用场景在于赋能大规模语言模型进行高质量的股权研究报告自动生成。该数据集以公司股票代码与特定日期为输入,要求模型整合公司概况、财务指标、公告新闻、历史股价及市场指数等多源异构金融数据,输出结构完整、逻辑严谨的研报。其设计模仿金融分析师的工作流,通过多智能体框架分解任务,涵盖新闻分析、财务分析、风险评估等环节,为文本生成与指令微调提供了理想的训练与评测基准。
实际应用
在实际应用中,FinRpt数据集驱动的模型可显著提升金融机构的研究效率。投资银行与券商可利用其自动化生成初步研报草稿,使分析师专注于深度洞察与决策判断;资产管理公司可将其应用于个股实时监控与快速评估,辅助投资组合管理。此外,该数据集还支持金融摘要、风险预警等衍生工具的开发,为量化交易与智能投顾系统提供技术支撑,降低人力成本的同时提升信息处理速度与覆盖面。
衍生相关工作
FinRpt数据集催生了多项具有影响力的相关工作。其核心框架FinRpt-Gen开创了多智能体协作生成金融报告的新范式,后续研究在此基础上探索了不同基座模型(如DeepSeek、Llama系列)在金融领域的效果对比。同时,数据集中的指令-响应对被广泛用于金融大模型的指令微调,衍生出针对财务分析、新闻解读、风险评估等子任务的专用模型。此外,其评估体系启发了金融文本质量自动评测标准的建立,推动了领域内更系统化的性能比较与模型优化。
以上内容由遇见数据集搜集并总结生成


