
stefanocarrera/autophagycode_D_he_train-mercury_Qwen3-4B_strategy_trust_t1.1_g9_run1
收藏数据链接:
官方服务:
资源简介:
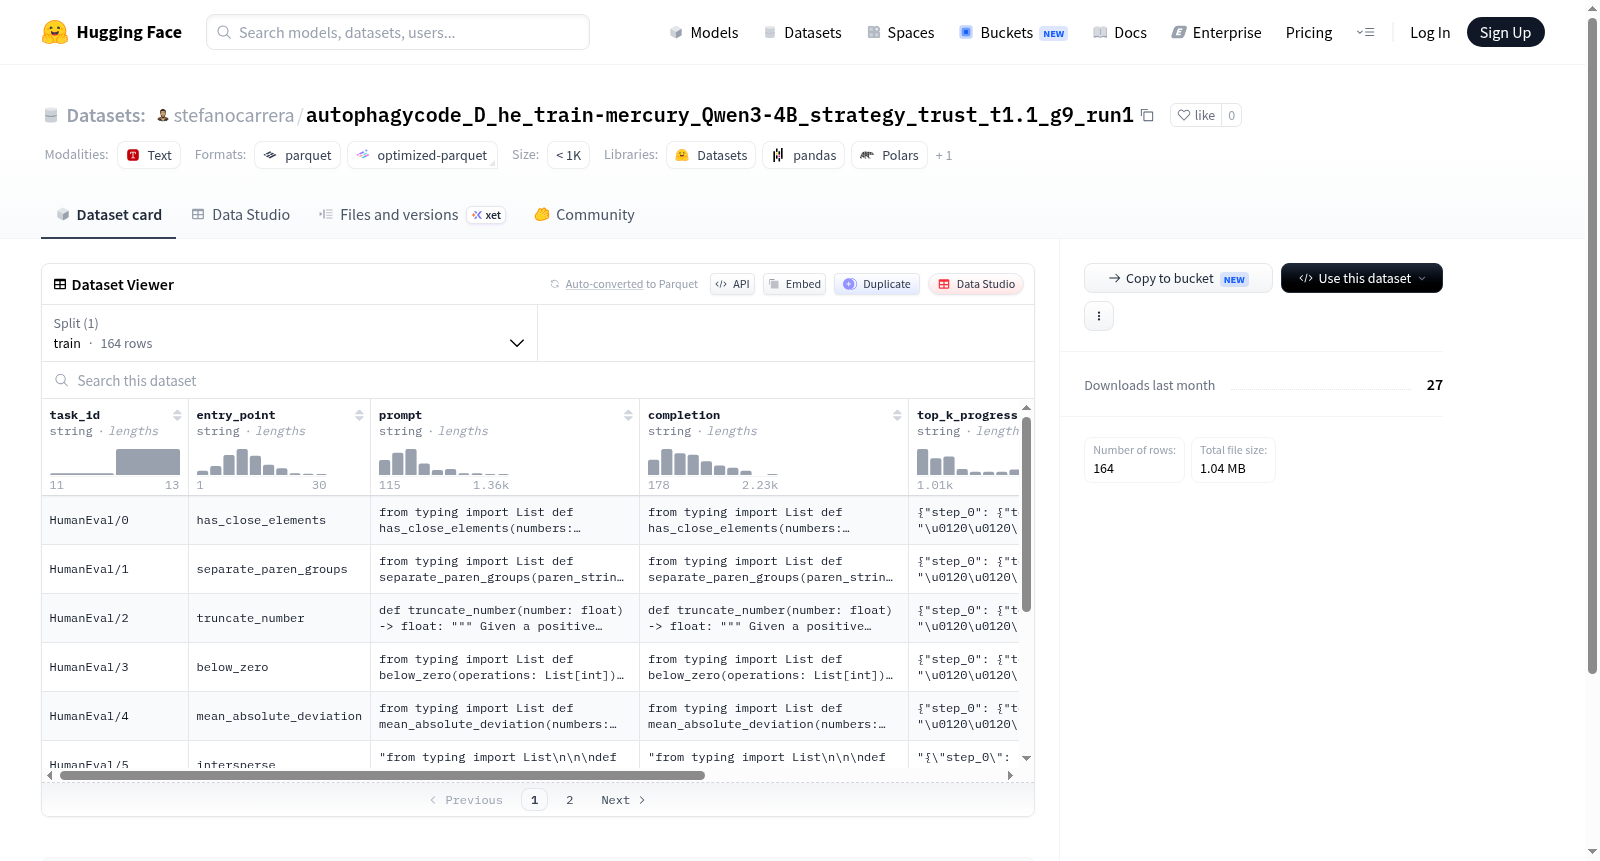
--- dataset_info: features: - name: task_id dtype: string - name: entry_point dtype: string - name: prompt dtype: string - name: completion dtype: string - name: top_k_progression dtype: string - name: test dtype: string splits: - name: train num_bytes: 4394065 num_examples: 164 download_size: 1033240 dataset_size: 4394065 configs: - config_name: default data_files: - split: train path: data/train-* ---
提供机构:
stefanocarrera搜集汇总
数据集介绍
构建方式
该数据集旨在为编程任务提供细粒度的推理过程监督数据,其构建源于对代码生成模型中复杂推理路径的探索。数据集的构建基于Qwen3-4B模型,在自噬代码任务集上,通过设定信任策略与温度参数t1.1及生成轮次g9,对模型在特定任务上的top-k推理轨迹进行采样与筛选。每个样本包含任务标识、代码入口点、提示文本、完整代码补全、最优推理路径的渐进式记录以及对应的测试用例,形成了结构化的推理过程数据集。
使用方法
该数据集适用于监督微调与推理过程分析任务。使用时,可将prompt字段作为输入,completion字段作为目标输出,用于训练模型生成符合规范代码。top_k_progression字段可被用于研究模型在多种候选推理路径中的选择机制,或作为过程奖励模型的训练数据。代码测试可通过解析test字段中的测试用例,对模型生成的代码进行功能性验证,形成从推理到执行的完整评估闭环。
背景与挑战
背景概述
该数据集名为autophagycode_D_he_train-mercury_Qwen3-4B_strategy_trust_t1.1_g9_run1,由相关研究团队在近期创建,旨在探索大语言模型在代码生成任务中的自我改进与信任机制。核心研究问题聚焦于如何通过策略性信任度调节(strategy_trust)和top-k逐步推进(top_k_progression)方法,提升模型在首次生成后迭代优化代码的能力。数据集包含164个训练样本,每个样本涵盖任务描述、函数入口、提示、完成代码、逐步改进链及测试用例,为研究代码生成的自修正和可靠性评估提供了基准。尽管规模有限,该数据集在推动大语言模型在编程辅助中的自主迭代和可信输出方面具有初步影响力,为后续更大规模的信任校准研究奠定了基础。
当前挑战
该数据集所解决的领域挑战在于提升大语言模型在代码生成中的自我修正能力与输出信任度。现有模型常生成语法正确但功能缺陷的代码,缺乏有效的自主迭代机制,而该数据集通过引入逐步改进链和信任策略,试图弥补这一短板。构建过程中面临严峻挑战:首先,高质量训练样本的采集需要精确匹配任务描述、错误代码及修正序列,人工标注成本极高且易引入不一致性;其次,设计合理的信任策略参数(如t1.1和g9)需大量消融实验以平衡探索与利用;此外,仅164个样本的小规模数据集难以覆盖多样化的代码错误类型,可能限制模型泛化能力,需后续扩展以增强鲁棒性。
常用场景
经典使用场景
该数据集名为autophagycode_D_he_train-mercury_Qwen3-4B_strategy_trust_t1.1_g9_run1,聚焦于自噬相关代码的生成与补全任务,属于生物信息学与自然语言处理交叉领域。数据集包含任务标识、入口函数、提示文本、补全结果、渐进式Top-K策略及测试用例等字段,为模型在自噬基因功能注释、蛋白质相互作用网络分析及细胞生物学机制研究中的代码生成提供了标准化训练素材。经典使用场景涵盖:基于提示的自噬相关代码片段补全、多策略信任度引导的代码生成,以及通过Top-K渐进式训练提升代码结构完整性。研究者可借助该数据集微调语言模型,使其精准生成符合领域规范的生物计算代码,从而加速自噬相关生物标志物发现与药物靶点预测。
解决学术问题
该数据集针对自噬领域计算生物学中代码复用性差、模型对领域特定语法理解不足等痛点,有效解决了如何引导语言模型生成高可信度自噬相关代码的学术问题。传统方法依赖手工编写规则或通用代码库,难以覆盖自噬机制的复杂性与多样性。该数据集引入策略信任机制与渐进式训练框架,使模型在代码生成中保持语义连贯性,同时降低错误率。其意义在于推动了生物医学领域专用代码生成模型的发展,为自噬研究中高通量数据处理、模拟仿真及自动化分析提供了可靠工具,显著提升了科研效率。影响主要体现在:减少了生物学家与计算机科学家之间的协作壁垒,促进了跨学科研究。
实际应用
在实际应用中,该数据集可赋能生物医药研发全链条。例如,制药企业可基于微调后的模型自动生成自噬相关基因敲除或过表达的模拟代码,用于药物筛选前的机制验证;医疗机构可利用生成的代码解析患者基因组数据中的自噬通路异常,辅助精准诊断;科研机构则能通过该数据集构建代码推荐系统,为实验室提供实时实验方案优化建议。此外,数据集中的测试用例可被集成到连续集成/部署流水线中,确保生物信息学软件在版本迭代时核心功能的稳定性,从而加速从基础研究到临床转化的进程。
数据集最近研究
最新研究方向
该数据集聚焦于代码生成任务的自主演化与信任机制探索,通过结合Qwen3-4B模型与策略性信任策略(trust_t1.1),研究模型在代码补全与推理过程中的自我改进路径。前沿方向包括利用top_k_progression指标追踪模型在多次迭代中的生成质量跃迁,从而揭示大规模语言模型在编程任务中从“机械生成”向“可靠推理”转化的动力学特征。这一研究方向与当前AI安全与代码正确性热点紧密关联,尤其在自动化软件工程与智能体自我纠错领域具有里程碑意义,为构建可信赖的代码生成系统提供了实证基础。
以上内容由遇见数据集搜集并总结生成


