few-shot-TrackStar
收藏资源简介:
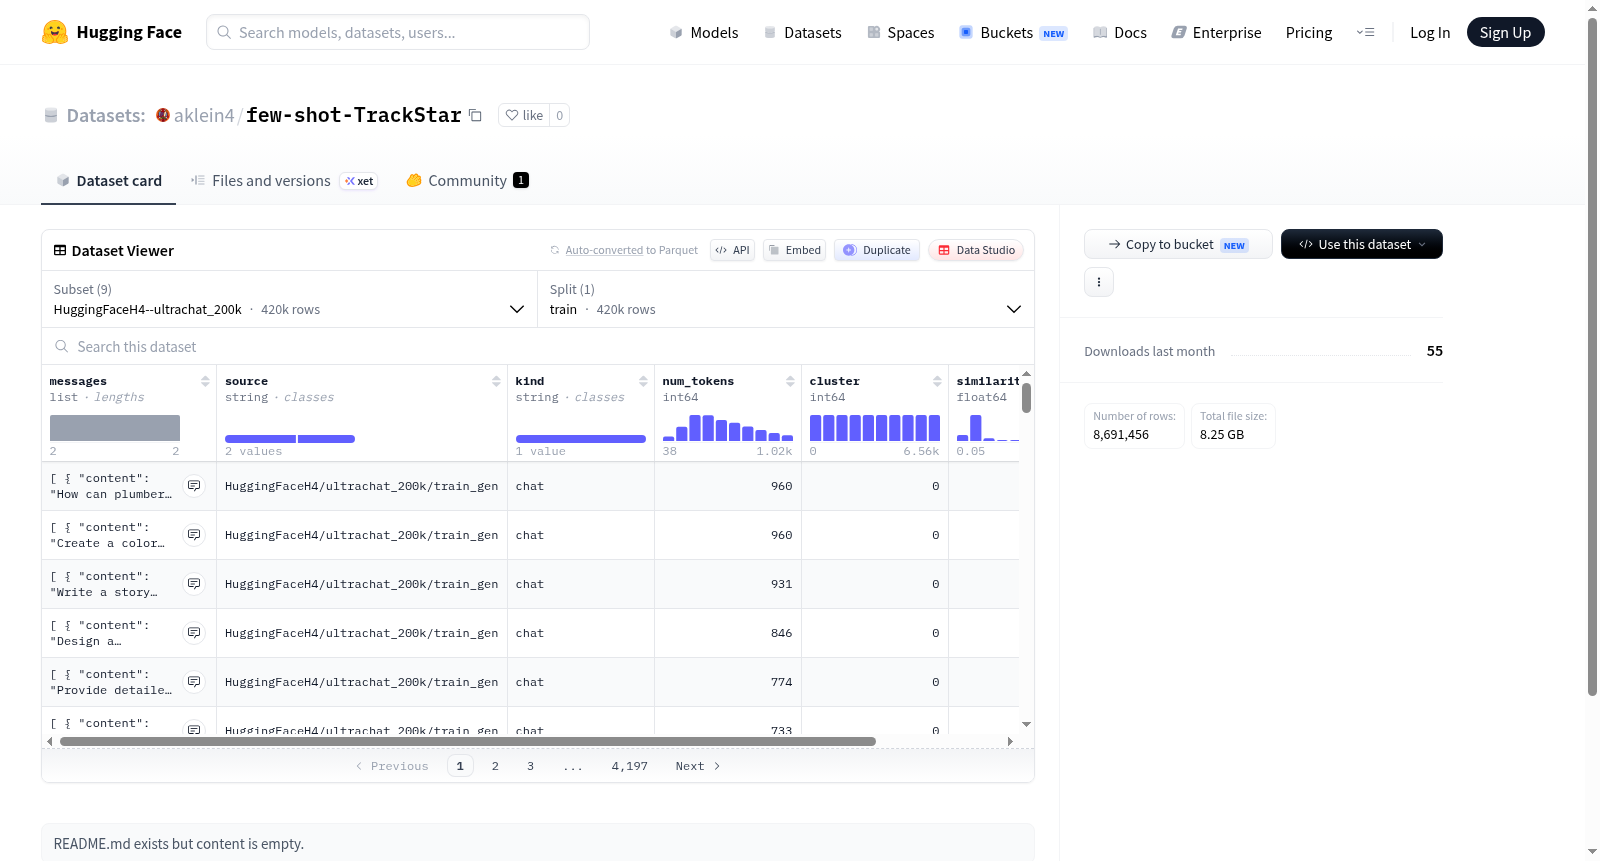
本数据集是一个用于大型语言模型指令微调(SFT)的大规模、多源对话数据集合。它整合了来自多个知名开源项目(如HuggingFaceH4、HuggingFaceTB、Magpie-Align)的数据,形成了8个具有统一格式但不同规模和侧重点的配置子集。数据核心为对话形式的messages,每条消息包含role(如用户、助手)和content(文本内容)字段。此外,每条数据记录还包含丰富的元数据:source标识数据来源子集,kind可能表示数据类型或风格,num_tokens提供文本长度信息,cluster和similarity_to_cluster_mean则暗示数据经过聚类分析以评估内部一致性或质量。数据总规模庞大,各子集样本量从约18.7万到291万不等,覆盖通用对话以及编程(Coder)、数学(Math)等特定领域。该数据集适用于训练或微调遵循指令的对话AI模型,尤其适合需要融合多源、多领域高质量对话数据的研究与开发场景。
This dataset is a large-scale, multi-source dialogue collection designed for instruction fine-tuning (SFT) of large language models. It integrates data from multiple well-known open-source projects (e.g., HuggingFaceH4, HuggingFaceTB, Magpie-Align), forming eight configuration subsets with a unified format but varying scales and focuses. The core data consists of dialogue-style messages, each containing role (e.g., user, assistant) and content (text content) fields. Additionally, each data record includes rich metadata: source identifies the data source subset, kind may indicate data type or style, num_tokens provides text length information, and cluster and similarity_to_cluster_mean suggest that the data has undergone clustering analysis to assess internal consistency or quality. The overall dataset is extensive, with subset sample sizes ranging from approximately 187,000 to 2.91 million, covering general dialogues as well as specific domains such as programming (Coder) and mathematics (Math). This dataset is suitable for training or fine-tuning instruction-following dialogue AI models, particularly for research and development scenarios that require integrating multi-source, multi-domain high-quality dialogue data.
数据集:few-shot-TrackStar
概述
该数据集是一个多来源的大规模对话数据集,整合了多个公开的对话数据子集,并进行了聚类分析,适用于少样本学习、指令微调等自然语言处理任务。
数据集配置与规模
数据集包含9个子配置(config),每个配置对应一个独立的来源数据集,全部只有训练集(train)划分。整体规模如下:
| 配置名称 | 样本数 | 数据集大小 | 下载大小 |
|---|---|---|---|
| HuggingFaceH4--ultrachat_200k | 419,648 | 950,967,198 bytes | 490,883,831 bytes |
| HuggingFaceTB--smoltalk--train | 994,048 | 1,707,706,590 bytes | 773,917,672 bytes |
| HuggingFaceTB--smoltalk2--SFT | 1,897,472 | 3,342,058,999 bytes | 1,414,983,722 bytes |
| Magpie-Align--Llama-3-Magpie-Air-3M-v0.1--train | 2,911,744 | 6,315,868,365 bytes | 2,907,416,612 bytes |
| Magpie-Align--Llama-3-Magpie-Pro-1M-v0.1--train | 968,960 | 2,317,459,053 bytes | 1,120,635,069 bytes |
| Magpie-Align--Magpie-Qwen2-Pro-200K-English--train | 186,688 | 466,336,906 bytes | 218,563,091 bytes |
| Magpie-Align--Magpie-Qwen2.5-Coder-Pro-300K-v0.1--train | 267,904 | 632,006,830 bytes | 248,876,035 bytes |
| Magpie-Align--Magpie-Qwen2.5-Math-Pro-300K-v0.1--train | 250,880 | 400,910,109 bytes | 122,561,506 bytes |
| Magpie-Align--Magpie-Qwen2.5-Pro-1M-v0.1--train | 794,112 | 2,651,970,939 bytes | 953,229,197 bytes |
数据特征
所有子配置共享一组核心特征,但个别配置的特征顺序略有差异:
- messages:对话消息列表,包含两个字段:
content(string):消息文本内容role(string):消息角色(如 user、assistant 等)
- source (string):来源标识
- kind (string):类型或种类
- num_tokens (int64):消息的 Token 数量
- cluster (int64):聚类标签,基于聚类分析得到
- similarity_to_cluster_mean (float64):样本与其所属聚类中心的相似度
数据来源
数据集整合了以下知名公开数据集:
- HuggingFaceH4/ultrachat_200k
- HuggingFaceTB/smoltalk (train 划分)
- HuggingFaceTB/smoltalk2 (SFT 划分)
- Magpie-Align/Llama-3-Magpie-Air-3M-v0.1 (train 划分)
- Magpie-Align/Llama-3-Magpie-Pro-1M-v0.1 (train 划分)
- Magpie-Align/Magpie-Qwen2-Pro-200K-English (train 划分)
- Magpie-Align/Magpie-Qwen2.5-Coder-Pro-300K-v0.1 (train 划分)
- Magpie-Align/Magpie-Qwen2.5-Math-Pro-300K-v0.1 (train 划分)
- Magpie-Align/Magpie-Qwen2.5-Pro-1M-v0.1 (train 划分)