
pooya-davoodi-parasail/openai_records_341679a6
收藏官方服务:
资源简介:
暂无详细的数据集中文描述信息。
The README does not provide a detailed description of the dataset. It only lists the features and some basic information about the splits and size of the dataset.
搜集汇总
数据集介绍
构建方式
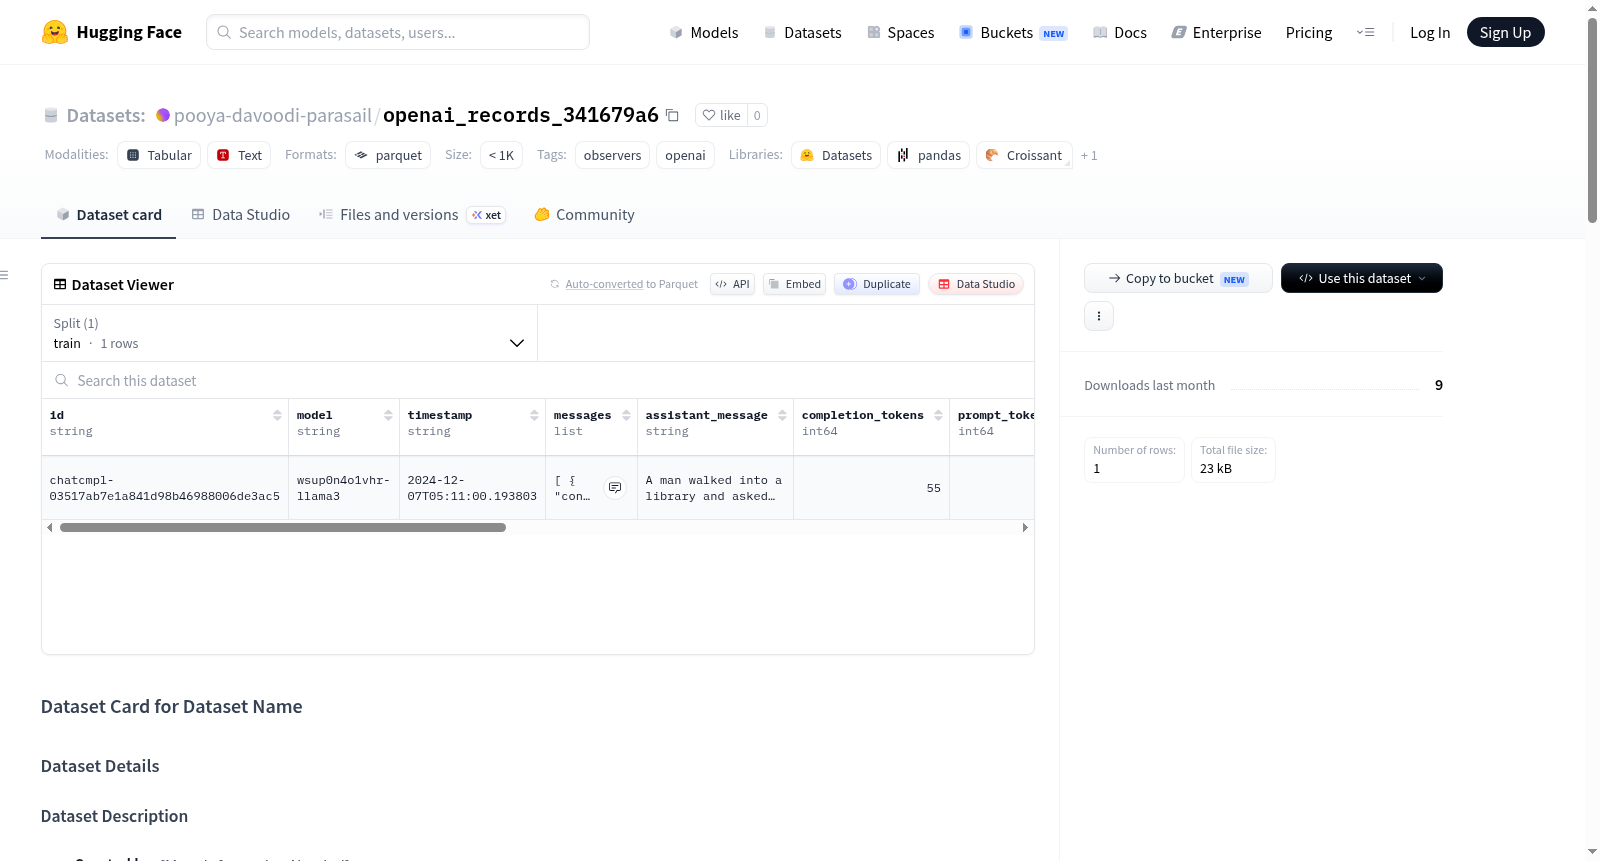
该数据集源自对OpenAI服务调用过程的系统化记录与收集,旨在为语言模型的观测与行为分析提供基础数据。构建过程中,数据采集器捕获了完整的API交互日志,每条记录包含唯一的请求标识符、调用时间戳、所用的模型名称以及完整的对话消息序列。消息序列以角色与内容的结构化形式呈现,并记录了模型生成的助手回复。此外,数据集还详尽记录了令牌消耗情况,包括提示令牌、生成令牌及总令牌数,以及请求的结束原因。所有原始响应均以字符串形式保留,确保了数据的可追溯性与完整性。整个数据集目前仅包含一个训练样本,但其结构设计为可扩展的框架,便于后续大规模数据的接入。
特点
该数据集最显著的特点在于其深度观测属性,专注于记录OpenAI语言模型在真实交互场景中的行为轨迹。数据结构高度结构化,涵盖了从请求输入到模型输出的全链路信息,包括对话上下文、令牌级消耗统计及请求终止状态。特别值得注意的是,数据集保留了原始响应字段,为后续的响应解析、错误分析与模型行为审计提供了原始依据。尽管当前样本量有限,但其字段设计的完备性使得该数据集成为研究模型调用模式、分析提示工程效果及评估API使用效率的理想起点。数据集的标签、属性、函数调用等字段虽为空值,却暗示了未来扩展与功能增强的潜力。
使用方法
该数据集的使用方法主要围绕语言模型的行为分析与观测展开。研究者可通过加载训练集,解析每条记录中的消息序列与助手回复,探究不同提示策略对模型输出的影响。令牌消耗字段可用于评估API调用的成本效率,而结束原因字段则有助于识别请求的异常终止模式。利用原始响应字段,可进行更深层次的响应格式验证或错误解析。数据集的字段设计支持多维度筛选与聚合分析,例如按模型或时间戳分组统计调用频次。对于希望构建模型观测工具链的开发者,此数据集可作为验证数据管道与解析逻辑的测试基准,尽管当前样本较少,但其清晰的字段定义降低了集成与扩展的门槛。
背景与挑战
背景概述
该数据集由Pooya Davoodi与Parasail团队创建,旨在捕捉OpenAI模型在实际交互中的行为记录。数据集聚焦于大语言模型在对话场景中的响应模式、令牌消耗及调用行为,为研究模型对齐、安全监控与性能评估提供了原始观测数据。其核心研究问题在于如何通过系统化的交互日志,揭示模型在开放域对话中的潜在偏差与局限性。尽管数据集规模较小,仅包含1个训练样本,但其结构化的字段设计(如角色、令牌数、完成原因等)为后续扩展与细粒度分析奠定了基础,对理解前沿AI系统的实际运作具有启发意义。
当前挑战
当前数据集面临多重挑战。首先,在领域问题层面,大语言模型的行为观测缺乏统一标准,如何从稀疏的交互日志中提取有意义的模式仍是一大难题,尤其面对模型输出的高度多样性与不可预测性。其次,构建过程中,数据收集依赖特定的API交互环境,可能引入选择偏差,且单一样本无法代表模型行为的全貌。此外,字段中包含的原始响应与错误信息需谨慎处理,以避免隐私泄露或误导性解读。这些挑战限制了数据集在鲁棒性评估与安全审计中的直接应用,亟需更大规模、更多样化的数据补充与验证。
常用场景
经典使用场景
pooya-davoodi-parasail/openai_records_341679a6 数据集收录了来自OpenAI模型的真实对话记录,涵盖用户与助手的多轮交互、令牌消耗、完成原因等结构化信息。其经典使用场景聚焦于大型语言模型的行为分析研究,研究者可借助该数据集剖析模型在不同提示下的回复模式、一致性及潜在偏差,例如通过分析 assistant_message 与 messages 的对应关系,评估模型在复杂对话中的推理连贯性与知识准确性。此外,该数据集亦为模型对齐与安全性评估提供了基础,可系统性地考察模型在敏感话题上的输出倾向,从而推动更负责任的AI开发。
解决学术问题
该数据集有效回应了大型语言模型可解释性与可控性的学术挑战。传统上,黑箱模型的内部决策过程难以追溯,而此数据集通过记录原始请求与响应、令牌使用量及终止原因,为研究人员提供了量化分析模型行为的窗口。它解决了如何从交互日志中提取模型能力边界、识别幻觉现象及测量上下文理解深度等关键问题。其意义在于,通过实证数据支撑,推进了对语言模型泛化机制与局限性理解的理论构建,并为后续提出更精准的模型校准与鲁棒性增强方法奠定了数据基础。
衍生相关工作
围绕该数据集衍生了若干经典工作,尤其在对话日志挖掘与模型行为特征工程领域。研究者基于其结构化字段开发了多种分析框架:例如利用 timestamp 与 finish_reason 构建会话状态转移模型,揭示模型在长对话中的退化规律;或结合 messages 与 raw_response 训练分类器以自动识别有害或偏见性输出。此外,该数据集促进了轻量级基准测试集的构建,通过筛选特定角色组合的对话片段,形成了评估模型指令遵循能力的专用测试套件。这些衍生工作不仅深化了对OpenAI系列模型的理解,也为跨模型对比研究提供了可复现的数据基线。
以上内容由遇见数据集搜集并总结生成


