
遇见数据集

SupraLabs/chat-titles-unfiltered-150K

收藏
Hugging Face2026-06-19 更新2026-06-21 收录
官方服务:

资源简介:

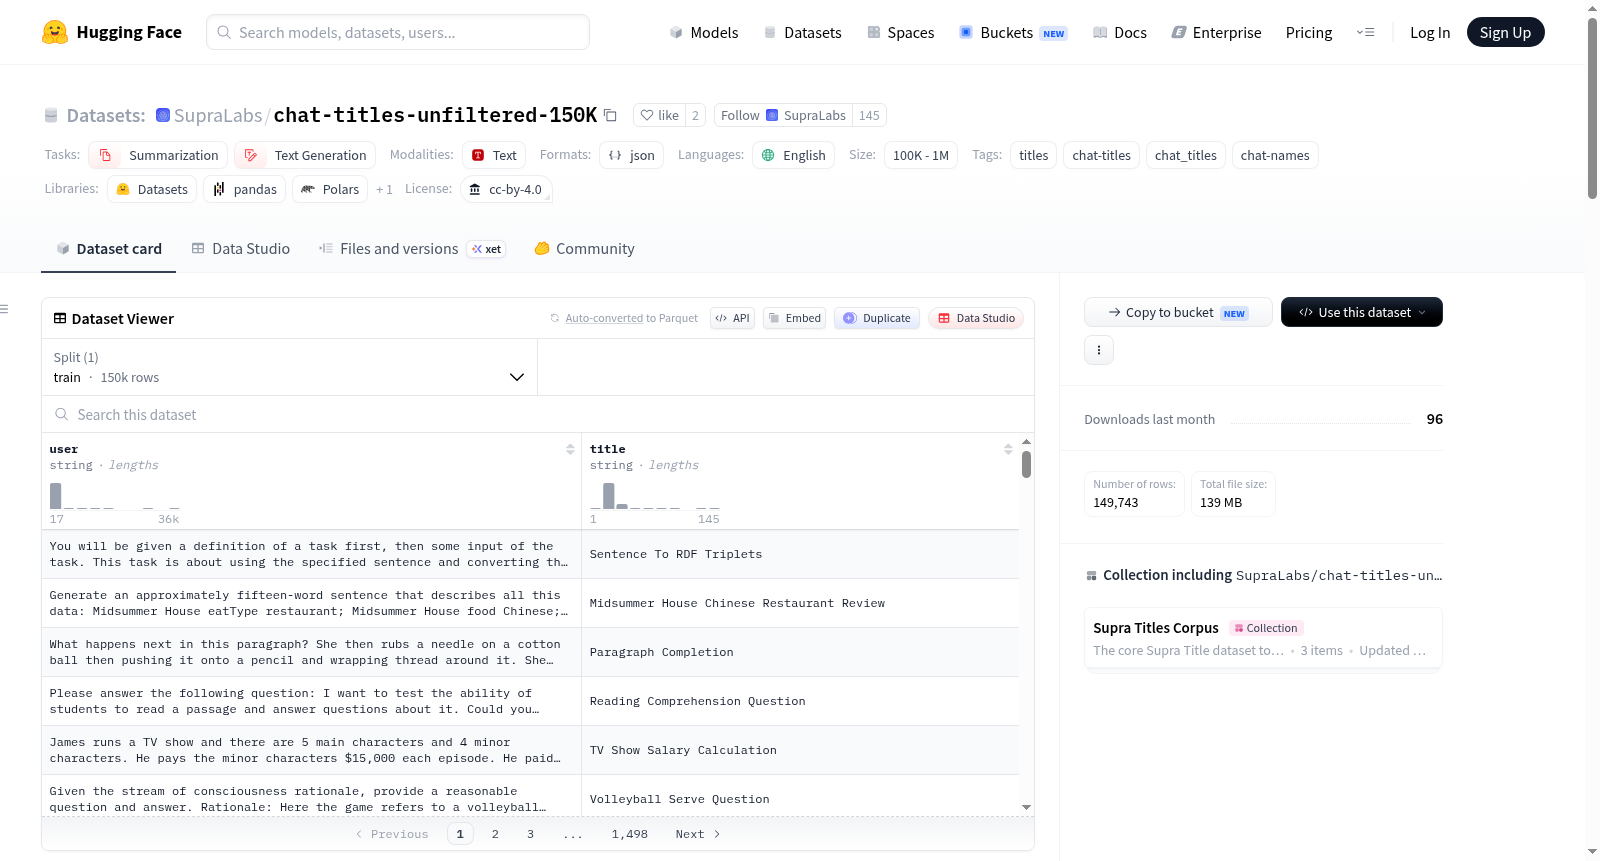
Supra Title 150K是一个大规模聊天标题生成数据集,源自Supra Title模型家族的训练流程。该数据集专门设计用于训练、微调和评估模型,以根据用户对话中的第一条消息生成简洁、描述性的标题。与一般的指令跟随数据集不同,Supra Title 150K专注于单一任务:将用户消息转换为高质量聊天标题,准确捕捉对话的意图、主题或上下文,同时保持简洁和可读性。数据集包含约150,000个样本,提供比小规模标题生成数据集更广泛的覆盖范围,并保留了真实的用户提示和对话场景。每个数据条目包含两个字段:user(从源数据集中提取并处理的用户消息)和title(描述用户消息的生成标题)。数据集创建过程包括数据提取、标题生成、清理和去重、质量审查等步骤,确保数据质量。

Supra Title 150K is a large-scale chat title generation dataset derived from the training pipeline used for the experimental Supra Title model family. The dataset is designed specifically for training, fine-tuning, and evaluating models that generate concise, descriptive titles from a users first message in a conversation. Unlike general instruction-following datasets, Supra Title 150K focuses on a single task: transforming a user message into a high-quality chat title that accurately captures the intent, topic, or context of the conversation while remaining concise and readable. Containing approximately 150,000 samples, the dataset provides significantly broader coverage than smaller title-generation datasets while preserving realistic user prompts and conversational scenarios. Each dataset entry contains two fields: user (the processed user message extracted from the source dataset) and title (a generated title describing the users message). The dataset creation process includes data extraction, title generation, cleaning and deduplication, and quality review steps to ensure data quality.
提供机构:
SupraLabs
搜集汇总
数据集介绍
SupraLabs/chat-titles-unfiltered-150K 数据集图片
构建方式
该数据集源自`sam-mosaic/orca-gpt4-chatml`数据集,通过提取用户消息并经过多阶段质量流水线构建而成。首先,从原始对话数据中抽取用户消息,剔除系统提示、助手回复、元数据及多余格式,仅保留面向用户的实质性内容。随后,利用Qwen3.6-35B-A3B模型为每条消息生成高质量标题,要求标题简洁、描述性强,并能准确反映用户意图。在此基础上,执行去重和清洗操作,移除低质量、格式错误或语义模糊的样本。最终,借助Qwen3.5-9B-Q8模型进行质量复审与验证,淘汰不合格条目,确保整个数据集在高一致性与多样性之间取得平衡。
特点
这一数据集囊括约150,000条样本,是目前公开可用的最大规模聊天标题生成数据集,专注于将用户首条消息转化为精准、可读且富有信息量的对话标题。其特点在于样本覆盖广泛,标题长度均超过8个字符,且经过严格的过滤与校验,保留了现实世界的用户语言风格与多样化的对话场景。每个样本包含`user`和`title`两个字段,前者是经过处理的用户消息,后者是由模型生成的对应标题,示例展示了对复杂技术问题的精炼概括能力,如将长串关于余弦相似度的询问凝练成“Cosine Similarity Explained”。
使用方法
该数据集主要适用于文本生成与摘要任务,可用于训练、微调或评估将用户消息转化为聊天标题的语言模型。使用时,模型需读取`user`字段中的原始消息,输出对应`title`字段的标题。数据集提供标准化的结构化格式,便于直接加载,用户可根据自身需求划分训练集与验证集,或结合其他对话数据集进行多任务学习。鉴于其单一任务聚焦性,该数据集特别适合应用于实时聊天系统、对话管理界面或无标题场景下的自动标题生成系统开发与评测。
背景与挑战
背景概述
在自然语言处理与对话系统的交叉领域中,自动生成高质量对话标题是一项具有挑战性的任务,其核心在于从用户的首条消息中精准提炼出对话的意图、主题与上下文。2026年,由SupraLabs(QyrouNnet-AI团队)创建的Chat-Titles-Unfiltered-150K数据集(亦称Supra Title 150K)应运而生,旨在填补大规模、专用化标题生成数据集的空白。该数据集包含约15万条样本,源于sam-mosaic/orca-gpt4-chatml对话数据,经过多阶段质量管道处理,包括用户消息提取、大模型生成标题(借助Qwen3.6-35B-A3B与Qwen3.5-9B-Q8)、去重与清洗,最终形成专注于将用户消息转化为简洁描述性标题的高质量资源。作为当前公开最大的聊天标题数据集,Supra Title 150K为对话摘要与生成模型的训练、微调及评估提供了坚实基础,推动了相关领域的研究进展。
当前挑战
该数据集所解决的领域问题在于:对话系统缺乏从碎片化、非结构化的用户首条消息中自动生成语义精准标题的能力,传统摘要方法往往忽略对话的即时性与上下文敏感性,导致生成标题冗余或偏离核心意图。构建过程中面临的挑战包括:其一,源数据(orca-gpt4-chatml)包含大量系统提示、助手回复及元数据,需精确提取用户消息并清除噪声;其二,标题生成需兼顾简洁性与描述力,依赖大模型在数万样本上保持高质量输出,同时避免重复和低质量条目;其三,去重与清洗阶段需处理格式不一致、歧义样本及语义冗余,人工审查与模型协作的平衡难度较高;其四,确保最终数据集在规模、多样性与一致性间取得最优,以支持真实对话场景的泛化能力。
常用场景
经典使用场景
在对话系统与智能交互领域,生成精准且富有概括性的对话标题是一项基础而关键的任务。Chat-Titles-Unfiltered-150K 数据集专为训练和评估从用户首条消息中提炼标题的模型而设计,其核心应用场景聚焦于将原始用户输入转化为高度浓缩、信息完备的聊天标题。该数据集包含约15万条样本,覆盖广泛且真实的用户提示与对话情境,为模型学习从自然语言片段中捕捉意图、主题与上下文提供了丰富的训练素材。研究者可基于此数据集构建标题生成模型,使系统能够自动为任意聊天会话赋予一个清晰、可读且紧密关联内容的标题,从而显著提升对话管理、检索与用户导航的效率。
实际应用
在实际应用层面,Chat-Titles-Unfiltered-150K 数据集直接服务于各类对话平台的智能化升级。在即时通讯、客服系统、在线教育及社区论坛等场景中,自动为每个对话线程生成描述性标题,可以帮助用户快速定位历史记录、把握讨论脉络,显著优化信息检索与交互体验。此外,该数据集还可用于增强知识管理工具的内容组织能力,驱动邮件客户端或项目管理软件中的会话摘要功能。鉴于其聚焦于真实用户消息,模型学得的标题生成能力更贴近实际使用需求,为部署于生产环境的对话型AI系统提供了可靠的数据支撑,降低了从研究原型到商业落地的迁移成本。
衍生相关工作
围绕 Chat-Titles-Unfiltered-150K 数据集,研究社区已衍生出若干富有启发性的工作。该数据集常被用作基础训练资源,在其之上微调语言模型以适配特定领域的对话标题生成,或将标题生成任务与对话状态追踪、情感分析等下游任务联合建模。部分学者基于其高质量标题对,探索了对比学习与检索增强生成在标题生成中的应用,验证了多任务学习框架下语义表示的迁移潜力。此外,该数据集也催生了针对标题生成质量自动评估方法的研究,例如设计无参考评价指标以替代人工判分。这些衍生工作不仅深化了对标题生成任务的理解,也为构建更智能、更具上下文感知能力的对话系统开辟了新路径。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

