world-cuisine-ingredient-overlap
收藏资源简介:
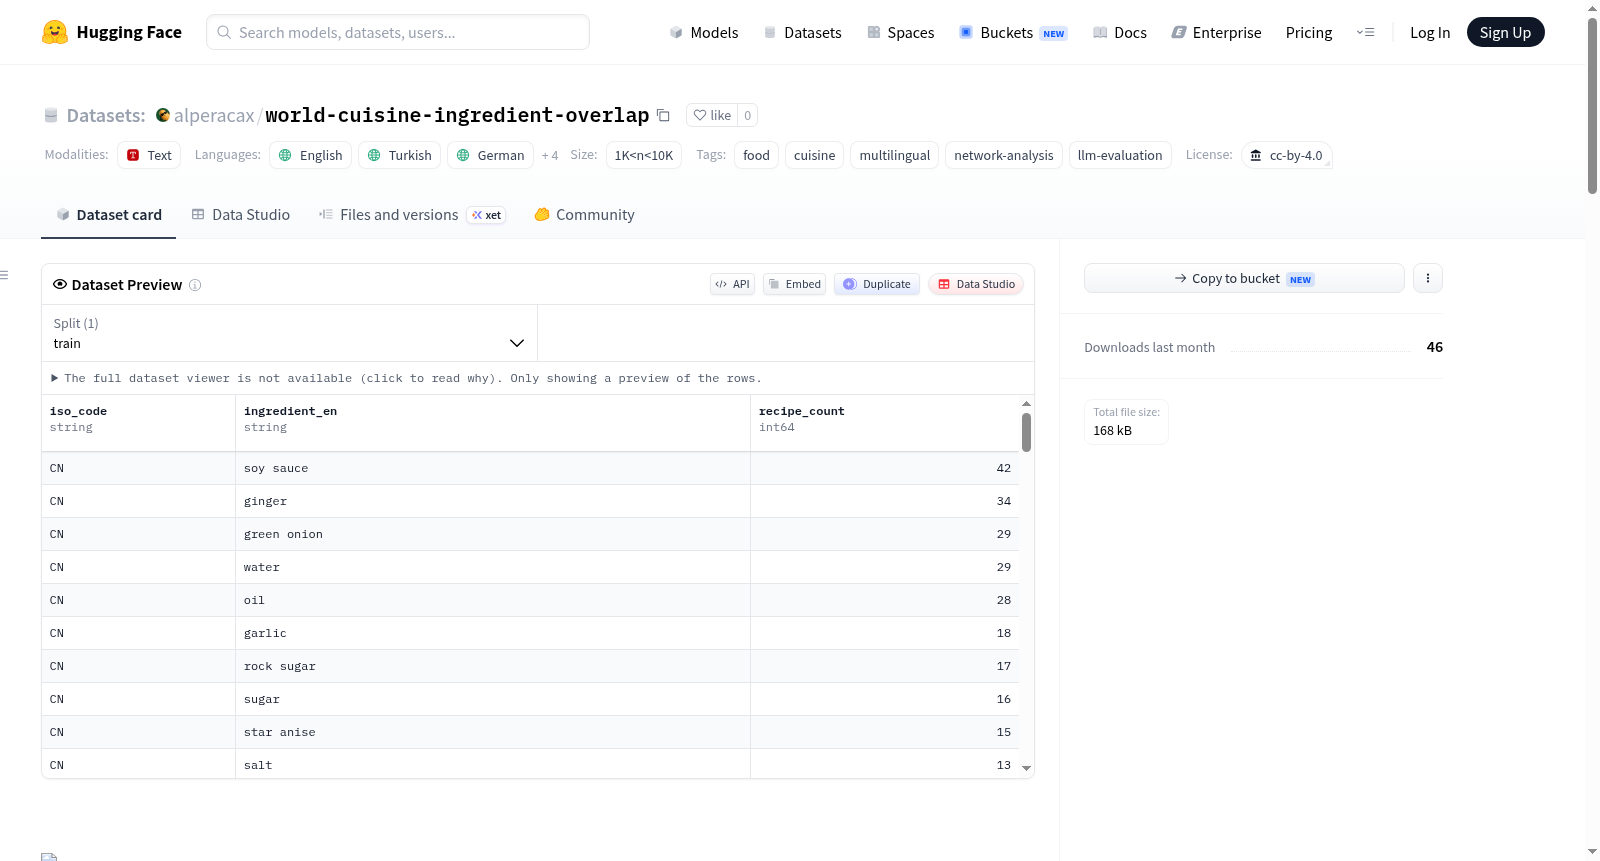
World Cuisine Ingredient Overlap (26 cuisines) 是一个多语言、多文化的成分重叠数据集,覆盖26个国家的1956道知名菜肴,每道菜肴以7种语言(英语、土耳其语、德语、法语、西班牙语、意大利语、希腊语)描述。数据集由大语言模型生成成分列表,并经二次模型验证,旨在衡量LLM对26种菜肴的表示及其成分共享模式,而非真实的人类烹饪记录。数据包含四个表格:cuisines.csv(26行,含ISO代码、菜肴数量、坐标)、ingredients.csv(958行,标准化成分及其多语言名称、出现次数)、cuisine_ingredient.csv(3164行,菜肴与成分的关联计数)、cuisine_pairs.csv(289行,成对菜肴的共享成分百分比、地理距离和是否共享陆地边界)。数据集适用于风味网络分析、跨文化比较研究、语言模型评估以及地理分布与成分重叠的相关性分析。注意:约7%的条目存在成分与菜肴不匹配;成分已规范化合并(如cherry tomatoes合为tomato);每道菜肴的原始成分列表未公开。
World Cuisine Ingredient Overlap (26 cuisines) is a multilingual, multicultural ingredient overlap dataset covering 1956 well-known dishes from 26 countries, each described in 7 languages (English, Turkish, German, French, Spanish, Italian, Greek). The ingredient lists are generated by a large language model and verified by a secondary model, aiming to measure LLM representations of these cuisines and their ingredient sharing patterns, rather than actual human cooking records. The dataset includes four tables: cuisines.csv (26 rows with ISO codes, number of dishes, coordinates), ingredients.csv (958 rows of standardized ingredients with multilingual names and occurrence counts), cuisine_ingredient.csv (3164 rows of dish-ingredient association counts), and cuisine_pairs.csv (289 rows of shared ingredient percentage, geographic distance, and land border sharing between cuisine pairs). It is suitable for flavor network analysis, cross-cultural comparative studies, language model evaluation, and correlation analysis between geographic distribution and ingredient overlap. Note: Approximately 7% of entries have ingredient-dish mismatches; ingredients are normalized and merged (e.g., cherry tomatoes merged into tomato); the original ingredient list per dish is not disclosed.
世界菜系食材重叠数据集(26种菜系,7种语言)
数据集概况
- 许可证:CC BY 4.0
- 语言:英语、土耳其语、德语、法语、西班牙语、意大利语、希腊语
- 规模:1K至10K行
- 数据版本:2026-09-09
- DOI:10.5281/zenodo.22272521
- 数据来源:https://www.eatmundo.com
- 同步发布平台:Kaggle、Zenodo
数据集核心内容
基于26个国家、1,956道知名菜肴(以7种语言描述)构建的食材重叠数据集,旨在衡量不同国家菜系在食材使用上的相似性。
⚠️ 重要构建说明
- 菜肴真实存在:每道菜均为该国菜系中的知名菜品
- 食材表由大语言模型编写,并经第二道模型核查;食材并非从食谱网站抓取或抄录
- 数据集衡量的是“语言模型对26种菜系的表示”,非真实烹饪方式的民族志记录
- 人工审查发现约**7%**的条目存在食材/菜品不匹配现象
- 每道菜被规范化为标准食材集合(如樱桃番茄与番茄、布尔格麦与小麦视为同一食材)
文件结构
1. cuisines.csv(26行)
| 列名 | 含义 |
|---|---|
iso_code |
ISO 3166-1 alpha-2代码 |
cuisine |
菜系标签(如Turkish) |
country_name_en |
国家名称(英文) |
latitude, longitude |
国家中心点坐标 |
dishes_food, dishes_dessert, dishes_drink, dishes_total |
各类菜肴数量 |
2. ingredients.csv(958行)
标准食材及其6种语言名称(tr, de, fr, es, it, el),含recipe_count和cuisine_count字段;空翻译表示该食材在语言中确实缺失,未做机器填补。
3. cuisine_ingredient.csv(3164行)
菜系→食材的二部图关系:每个食材在对应菜系多少道菜中被使用,是构建风味网络的基础数据表。
4. cuisine_pairs.csv(289行)
每一对菜系的组合数据,包含:
linked_dish_pairs(超过食材相似度阈值的菜肴配对数量)overlap_share_pct(重叠比例)centroid_distance_km(大圆距离,单位公里)shares_land_border(是否接壤)
快速使用示例
提供Python代码示例(使用pandas、seaborn、matplotlib),可加载cuisine_pairs.csv生成菜系食材重叠热力图,并分析地理距离与食材重叠率的相关性,以及接壤对重叠率的影响。
数据集适用范围与限制
- 仅发布聚合结果:单道菜的食材表、相似度阈值及评分权重未包含在数据集中
- 非真实烹饪记录:不应作为实际烹饪方式的参考依据
- 每菜系约75道菜,菜系中缺省的食材仅代表“该数据集中不存在”,非该菜系实际不使用
- 各菜系菜肴数量不同(42–131道),进行总数对比时需先做归一化
- 食材标准化合并了烹饪变体(如
pepper涵盖多种不同的胡椒属香料)
引用信息
提供了BibTeX格式引用条目,作者为Alper Acar,出版方为Zenodo,版本2026-09-09,许可证CC BY 4.0。