x86_64-freestanding-corpus
收藏资源简介:
x86_64-freestanding-corpus 是一个面向自由态(freestanding)、无 libc 的系统编程场景的 x86_64 代码样本数据集,共包含 74,463 条可编译、可执行的代码样本,总计约 787.8 万 token。该数据集专为现有代码模型设计,用于领域适应(domain-adaptation)和监督微调(SFT),而非从零预训练。其中 74,063 条(99.5%)经过验证,确保能以 -Werror 编译并通过执行后干净退出。数据集包含自然语言提示(prompt)、难度等级(easy/medium/hard)和基于标签的过滤功能。数据集分为五个子集:kernel_bypass(5,850 行)、syscall(20,619 行)、fundamentals(38,011 行)、advanced(4,600 行)、quirks(5,383 行)。模式包含字段:id、lang、scenario、code、build_cmd、verified_run、prompt、expected_stdout、assertions、difficulty、tags、tokens、n_lines、ub_risk、runtime。适用任务包括:继续预训练、指令微调、评估。数据集由 12 个 GLM-5.2 子代理生成,许可证为 MIT。
x86_64-freestanding-corpus is a dataset of x86_64 code samples for freestanding (no libc) system programming scenarios, containing 74,463 compilable and executable code samples with approximately 7.878 million tokens. It is designed for domain adaptation and supervised fine-tuning (SFT) of existing code models, not for pre-training from scratch. 74,063 samples (99.5%) are verified to compile with -Werror and exit cleanly after execution. The dataset includes natural language prompts, difficulty levels (easy/medium/hard), and tag-based filtering. It is divided into five subsets: kernel_bypass (5,850 lines), syscall (20,619 lines), fundamentals (38,011 lines), advanced (4,600 lines), and quirks (5,383 lines). The schema includes fields: id, lang, scenario, code, build_cmd, verified_run, prompt, expected_stdout, assertions, difficulty, tags, tokens, n_lines, ub_risk, and runtime. Suitable tasks include continued pre-training, supervised fine-tuning (SFT), and evaluation. The dataset was generated by 12 GLM-5.2 sub-agents and is licensed under MIT.
x86_64-freestanding-corpus 数据集详情
数据集概览
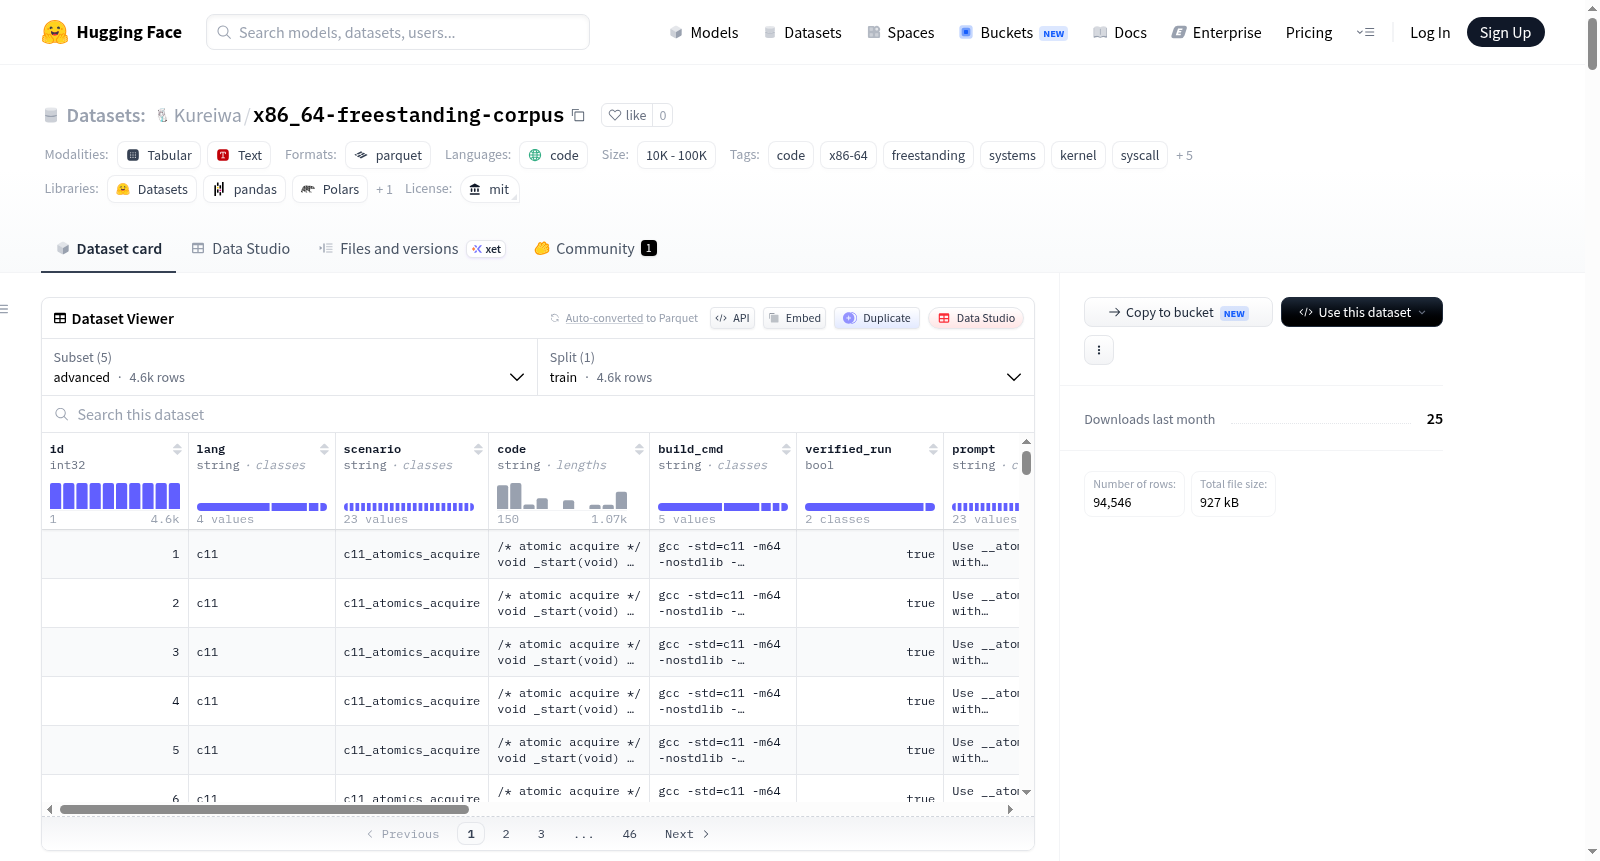
这是一个面向无libc的x86_64独立系统编程的领域适应与SFT数据集,包含94,546个可编译、可执行的x86_64代码样本。每个样本都配有自然语言提示、难度级别和基于标签的过滤功能。其中93,986行(99.4%)经过验证,可用-Werror标志编译,执行时能干净退出。总计约1,001.7万个token。
适用场景
该数据集适用于已有代码模型的领域适应和指令微调,而非从零预训练。主要用途包括:
- 持续预训练:可以5-15%的权重与通用代码语料库(如The Stack v2)混合使用
- 指令微调(SFT):使用
prompt列提供的自然语言指令与验证代码直接进行SFT - 评估:保留子集,针对
expected_stdout和assertions检查pass@k指标
子集构成
| 子集 | 行数 | 运行验证通过率 | 带提示 | 带断言 |
|---|---|---|---|---|
| kernel_bypass | 5,850 | 100.0% | 5,850 | 0 |
| syscall | 20,619 | 100.0% | 20,619 | 0 |
| fundamentals | 58,014 | 100.0% | 58,014 | 3,476 |
| advanced | 4,600 | 91.3% | 4,600 | 0 |
| quirks | 5,463 | 97.1% | 5,463 | 240 |
| 总计 | 94,546 | 99.4% |
- kernel_bypass:使用用户空间可访问的CPU指令(rdtsc、cpuid、rdpmc、原子操作、栅栏、fxsave、SSE等)绕过内核的Ring-3安全代码,涵盖20种场景
- syscall:使用x86_64 Linux ABI的原始
syscall指令,无libc依赖,涵盖20种系统调用场景 - fundamentals:基本的编程结构(打印、算术、数学、循环、排序、字符串、位操作、递归)的独立实现,涵盖20种场景
- advanced:栅栏、故障处理器、幽灵缓解、SIMD、UEFI、PIC、cpuid功耗,涵盖23种场景
- quirks:C/C++/ASM语言特性,如RAII、版本特性、ISA指令,涵盖70种场景
数据模式
数据集包含以下字段:
id(int32):子集内唯一标识lang(string):c89/c99/c11/c17/c23/cpp98..cpp23/asm_x86_64scenario(string):场景名称code(string):完整源代码build_cmd(string):确切的编译命令verified_run(bool):二进制是否干净退出prompt(string):自然语言指令expected_stdout(string):预期标准输出assertions(string):分号分隔的CHECK()表达式difficulty(string):easy / medium / hardtags(string):逗号分隔的标签tokens(int32):预估token数n_lines(int32):行数ub_risk(string):静态分析发现的UB风险runtime(string):linux / uefi
语言分布
支持12种语言变体,覆盖C和C++各版本以及x86_64汇编。其中asm_x86_64数量最多(25,474行),其次是c99(11,007行)。
构建验证
- 使用gcc 14.2.0、g++ 14.2.0、nasm 2.16.01、ld 2.44进行编译验证
- 每个可运行行均作为静态二进制执行并干净退出
- 仅UEFI场景(
runtime=uefi)需要UEFI固件执行,这些行已通过构建验证且代码正确
数据加载
可通过datasets库或pyarrow加载数据:
python
from datasets import load_dataset
ds = load_dataset("Kureiwa/x86_64-freestanding-corpus", "fundamentals")
或通过pyarrow读取parquet文件: python import pyarrow.parquet as pq t = pq.read_table("data/fundamentals.parquet")
构建命令
- C:
gcc -std=cNN -m64 -nostdlib -ffreestanding -static -no-pie -Werror file.c -o file - C++:
g++ -std=c++NN -m64 -nostdlib -ffreestanding -static -no-pie -fno-exceptions -fno-rtti -Werror file.cpp -o file - ASM:
nasm -f elf64 file.s -o file.o && ld -nostdlib -static file.o -o file
局限性
- 尚无组合示例:每行是单一隔离场景,计划添加多场景程序组合子集
- 输出验证不完整:大多数行的
expected_stdout为空,运行时断言仅覆盖约5%的行 - 入口点样板代码:大多数行使用
void _start(void),计划增加入口模式变化 - 无多文件示例:每行均为单文件,计划支持多文件
生成方法
由12个GLM-5.2子代理编写人工策划的种子模板,确定性扩展器生成变体。生成后每行均经过构建验证和运行验证,失败行被修复或过滤。kernel_bypass子集受EoSD(https://github.com/rui-727/eosd)启发,展示"内核绕过"是使用ring-3安全的用户空间指令,而非ring-0特权指令。
许可证
MIT许可证,由GLM-5.2(Z.ai)生成。