
遇见数据集

shanya/crd3

收藏
Hugging Face2022-10-25 更新2024-03-04 收录
官方服务:

资源简介:

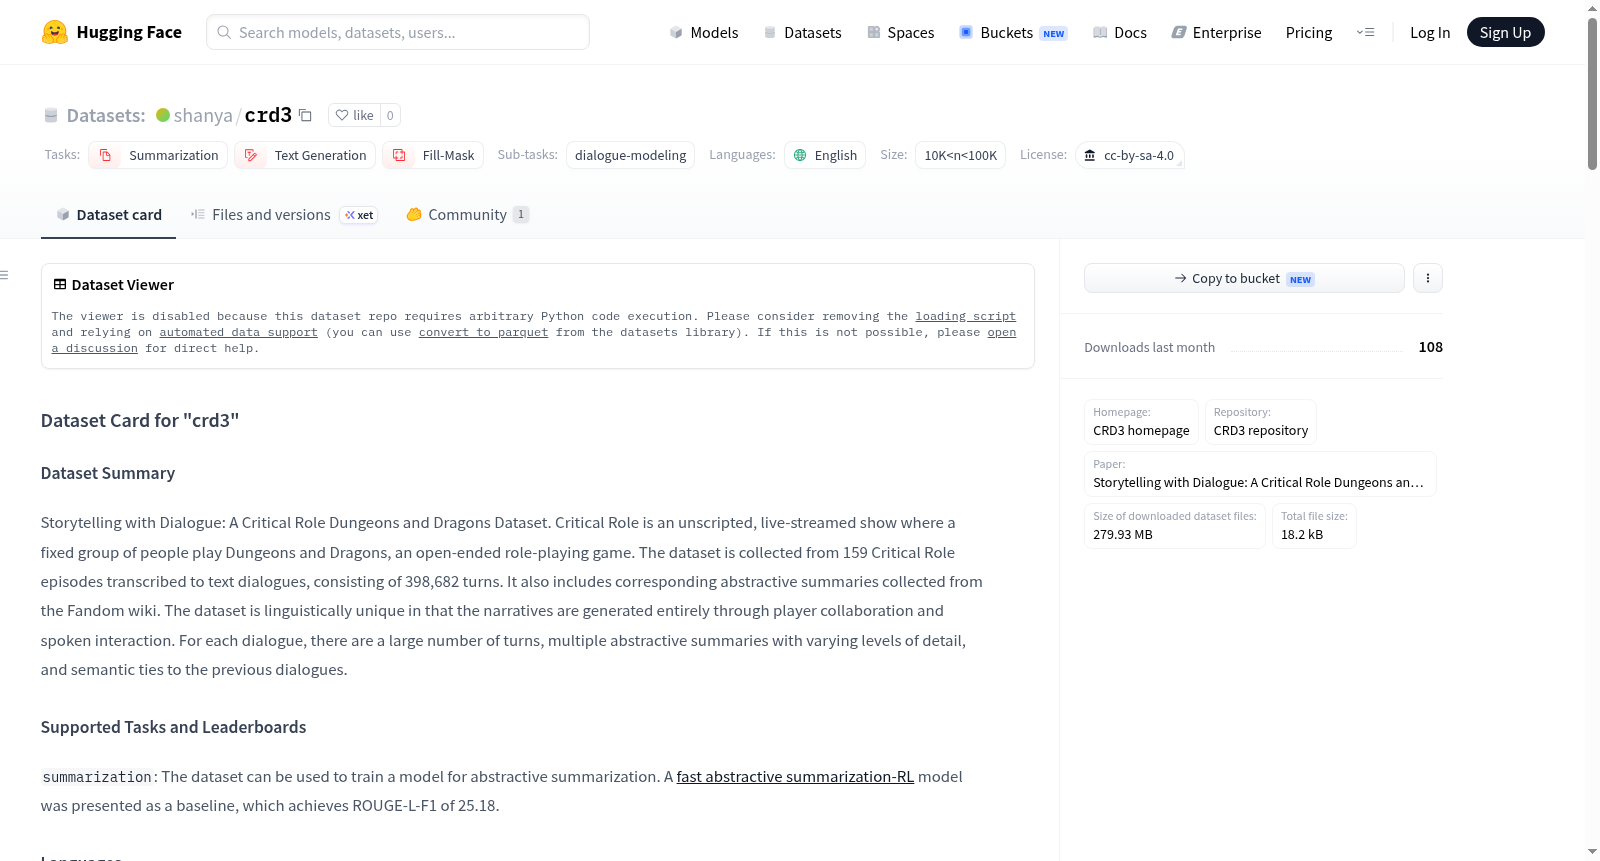
CRD3数据集,又称关键角色龙与地下城数据集,包含了159集Critical Role节目的转录对话,总计398,682个对话回合。该数据集还包含了来自Fandom wiki的相应摘要。数据集语言独特,完全通过玩家合作和口头互动生成叙述。每个对话包含大量回合、多个抽象摘要以及与先前对话的语义联系。该数据集适用于摘要、文本生成和填充掩码等任务,特别适用于对话建模。

CRD3 dataset, also referred to as the Critical Role Dungeons & Dragons Dataset, contains transcribed dialogues from 159 episodes of the Critical Role show, with a total of 398,682 dialogue turns. This dataset also includes corresponding summaries sourced from the Fandom wiki. The dataset features a unique linguistic style, where narratives are entirely generated through collaborative player engagement and verbal interactions. Each dialogue entry includes numerous conversational turns, multiple abstract summaries, and semantic links to prior conversations. This dataset is applicable to tasks such as text summarization, text generation, and mask filling, and is particularly suitable for dialogue modeling.

提供机构:
shanya
原始信息汇总

数据集概述

数据集名称

  • pretty_name: CRD3 (Critical Role Dungeons and Dragons Dataset)

语言和许可证

  • language: en
  • license: cc-by-sa-4.0

数据集来源和任务

  • source_datasets: original
  • task_categories: summarization, text-generation, fill-mask
  • task_ids: dialogue-modeling

数据集大小

  • size_categories: 10K<n<100K

数据集描述

数据集总结

  • 内容: 包含159集Critical Role节目的文本对话,总计398,682个对话轮次,以及从Fandom wiki收集的相应摘要。
  • 特点: 通过玩家协作和口头互动生成的叙事,每个对话包含大量轮次和多个摘要。

支持的任务和评估

语言

  • 语言: 英语

数据集结构

数据实例

  • 示例: 包含对话轮次、发言者名称和发言内容等。

数据字段

  • 字段: chunk, chunk_id, turn_start, turn_end, alignment_score, turn_num, turns (包含names和utterances)

数据分割

  • 分割: train (26,232), validation (3,470), test (4,541)

数据集创建

数据收集和标准化

  • 来源: 从Critical Role节目收集,包含159集的转录文本。
  • 摘要来源: 从Critical Role Fandom wiki收集。

语言生产者

  • 生产者: Critical Role节目的演员。

许可证和引用信息

许可证

  • 许可证: Creative Commons Attribution-ShareAlike 4.0 International License

引用信息

  • 引用格式:

@inproceedings{ title = {Storytelling with Dialogue: A Critical Role Dungeons and Dragons Dataset}, author = {Rameshkumar, Revanth and Bailey, Peter}, year = {2020}, publisher = {Association for Computational Linguistics}, conference = {ACL} }
搜集汇总
数据集介绍
shanya/crd3 数据集图片
构建方式
在自然语言处理领域,对话理解与抽象式摘要生成始终是极具挑战性的研究课题。CRD3数据集源自热门角色扮演直播节目《Critical Role》,其中159集未经剧本编排的《龙与地下城》游戏对话被转录为文本,共计398,682轮次。数据集的构建过程严谨而独特:首先,原始语音对话经由人工转录并规范拼写不一致之处;随后,从Fandom维基平台收集对应的高质量抽象式摘要作为参考标准。每个对话片段被切分为包含多轮交互的语义块,并配备对齐分数以衡量摘要与对话的匹配程度,最终形成训练集26,232例、验证集3,470例、测试集4,541例的结构化数据。
特点
该数据集在语言学层面展现出显著独特性——叙事内容完全通过玩家协作与口语互动即兴生成,突破了传统剧本式对话的局限。每个对话实例包含大量轮次,且对应多个抽象式摘要,这些摘要呈现出从简略到详尽的层次化细节覆盖。尤为特殊的是,对话间存在紧密的语义传承,前序情节与后续发展构成连贯的叙事链条,为长文本建模提供了丰富的上下文依赖关系。此外,数据集的众包来源确保了语言风格的多样性和自然性,使其成为研究开放式故事生成与对话摘要的理想基准。
使用方法
研究者可基于HuggingFace Datasets库直接加载该数据集,通过简单的API调用即可获取预设的对话块、轮次索引及对齐分数等字段。在摘要任务中,推荐采用基于强化学习的快速抽象式摘要模型作为基线,其ROUGE-L F1值可达25.18。数据集的标准化分割使训练、验证与测试流程清晰可控,支持从零开始训练或微调预训练语言模型。对于对话建模任务,可充分利用多轮交互结构进行上下文编码;而掩码填充任务则能借助对话块中的语义连贯性进行语言理解训练。所有数据采用CC-BY-SA 4.0许可协议,便于学术研究与成果共享。
背景与挑战
背景概述
在自然语言处理领域,对话理解与抽象式摘要生成始终是兼具重要性与挑战性的核心议题。CRD3(Critical Role Dungeons and Dragons Dataset)由Revanth Rameshkumar与Peter Bailey于2020年在ACL会议上提出,旨在探索基于多轮角色扮演对话的叙事性摘要任务。该数据集源自《Critical Role》这一即兴直播节目,采集了159集、共计398,682轮对话的转录文本,并辅以Fandom维基社区提供的抽象式摘要。其独特之处在于,叙事内容完全由玩家协作与口语互动即兴生成,语料兼具高轮次密度、多层次摘要以及跨集语义关联性,为长程对话建模与抽象式摘要研究提供了极具语言学价值的资源。
当前挑战
CRD3数据集所面临的挑战首先体现在领域问题层面:当前摘要模型在处理长程、叙事性对话时,在语义与语用捕获、内容选择、语义改写及评估指标上存在显著局限,传统ROUGE指标难以衡量生成摘要的叙事连贯性与角色动机表达。其次,在构建过程中,跨集对话的语义依赖关系需要手动对齐,不同集之间角色状态、情节推进的连续性给摘要生成带来额外难度;同时,159集转录文本中存在的拼写与说话人名称不一致问题虽经人工修正,但语料规模与标注一致性的平衡仍构成挑战。此外,抽象式摘要来自社区贡献,其质量与详细程度参差不齐,缺乏统一的评估标准,进一步增加了模型训练与性能验证的复杂性。
常用场景
经典使用场景
CRD3数据集以《关键角色》这一即兴角色扮演直播节目的对话转录为基础,结合粉丝维基的抽象摘要,构建了一个富含叙事性与协作性对话的语料库。其最经典的使用场景在于抽象摘要任务,研究者可借助该数据集训练模型,从冗长、多轮次的即兴对话中提炼出连贯且信息密集的叙事摘要。由于对话完全由玩家即兴生成,叙事结构松散且语义依赖上下文,CRD3为探索长对话中的内容选择、语义压缩与重写等挑战提供了独特且高质量的基准,推动了对话摘要领域的方法论演进。
解决学术问题
该数据集针对计算语言学中对话理解与抽象摘要的核心难题,尤其聚焦于传统模型在捕捉长叙事对话的语义、语用及内容选择上的不足。CRD3通过提供大规模、多摘要粒度的对话-摘要对,使研究者能够系统性地探索如何从复杂、非结构化的口语交互中提取关键事件与角色动机。它解决了现有数据集在叙事对话领域匮乏的问题,为评估模型在跨轮次依赖、情境推理及协作叙事生成方面的能力开辟了新路径,显著提升了对话摘要的语义保真度与可读性。
衍生相关工作
CRD3的发布催生了一系列后续研究,其中最具代表性的工作包括基于强化学习的快速抽象摘要模型(fast_abs_rl),该模型在CRD3上实现了ROUGE-L F1值25.18的基线性能,验证了数据集的有效性。此外,研究者还利用该数据集探索了多模态对话摘要、跨文档叙事对齐以及角色感知的生成模型。这些工作不仅深化了对即兴叙事对话结构的理解,还推动了将对话历史与外部知识融合的摘要框架,为后续如StoryGAN等叙事生成模型提供了重要的评测基准与训练资源。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

