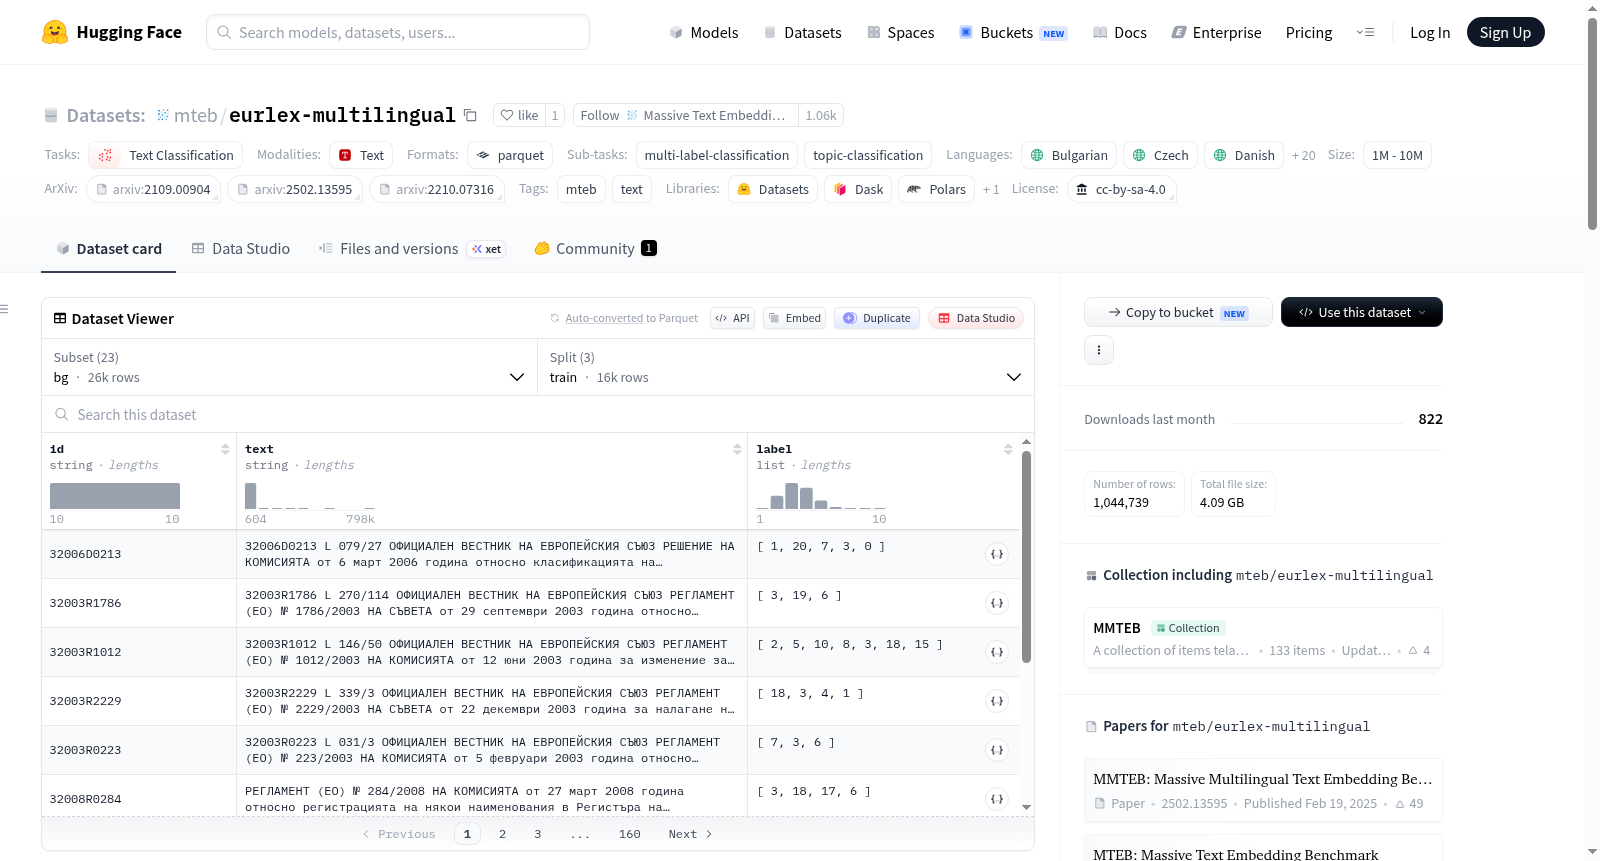
mteb/eurlex-multilingual
收藏资源简介:
这是一个多语言文本分类和主题分类数据集,由专家进行标注。数据集包含多种语言,包括保加利亚语、捷克语、丹麦语、德语、希腊语、英语、爱沙尼亚语、芬兰语、法语、克罗地亚语、匈牙利语、意大利语、拉脱维亚语、立陶宛语、马耳他语、荷兰语、波兰语、葡萄牙语、罗马尼亚语、斯洛伐克语、斯洛文尼亚语、西班牙语和瑞典语。每种语言都有自己的配置,具有相同的特征:id(字符串)、text(字符串)和label(类标签序列)。数据集分为训练集、测试集和验证集,每个集合的示例数量和文件大小都有指定。数据集遵循CC BY-SA 4.0许可证。
This is a multilingual dataset for text classification and topic classification tasks, annotated by experts. The dataset includes various languages such as Bulgarian, Czech, Danish, German, Greek, English, Estonian, Finnish, French, Croatian, Hungarian, Italian, Latvian, Lithuanian, Maltese, Dutch, Polish, Portuguese, Romanian, Slovak, Slovenian, Spanish, and Swedish. Each language has its own configuration with the same features: id (string), text (string), and label (sequence of class labels). The dataset is split into train, test, and validation sets, with specified number of examples and file sizes for each. The dataset is licensed under CC BY-SA 4.0.
数据集概述
数据集配置
- config_name: bg, cs, da, de, el, en, es, et, fi, fr, hr, hu, it, lt, lv, mt, nl, pl, pt, ro, sk, sl
- features:
- id: string
- text: string
- label: sequence with class labels
数据集分割
- splits:
- train: 训练集,包含不同数量的字节和示例数
- test: 测试集,包含不同数量的字节和示例数
- validation: 验证集,包含不同数量的字节和示例数
数据集大小
- download_size: 下载大小,不同配置下大小不同
- dataset_size: 数据集总大小,不同配置下大小不同
数据集详细信息
配置 bg
- features: id, text, label
- splits:
- train: 273160232 bytes, 15986 examples
- test: 109874757 bytes, 5000 examples
- validation: 76892269 bytes, 5000 examples
- download_size: 164279141 bytes
- dataset_size: 459927258 bytes
配置 cs
- features: id, text, label
- splits:
- train: 189826374 bytes, 23187 examples
- test: 60702802 bytes, 5000 examples
- validation: 42764231 bytes, 5000 examples
- download_size: 132410678 bytes
- dataset_size: 293293407 bytes
配置 da
- features: id, text, label
- splits:
- train: 395774705 bytes, 55000 examples
- test: 60343684 bytes, 5000 examples
- validation: 42366378 bytes, 5000 examples
- download_size: 215873874 bytes
- dataset_size: 498484767 bytes
配置 de
- features: id, text, label
- splits:
- train: 425489833 bytes, 55000 examples
- test: 65739062 bytes, 5000 examples
- validation: 46079562 bytes, 5000 examples
- download_size: 232088949 bytes
- dataset_size: 537308457 bytes
配置 el
- features: id, text, label
- splits:
- train: 768224671 bytes, 55000 examples
- test: 117209300 bytes, 5000 examples
- validation: 81923354 bytes, 5000 examples
- download_size: 364222506 bytes
- dataset_size: 967357325 bytes
配置 en
- features: id, text, label
- splits:
- train: 389250111 bytes, 55000 examples
- test: 58966951 bytes, 5000 examples
- validation: 41516153 bytes, 5000 examples
- download_size: 206929929 bytes
- dataset_size: 489733215 bytes
配置 es
- features: id, text, label
- splits:
- train: 433955311 bytes, 52785 examples
- test: 66884992 bytes, 5000 examples
- validation: 47178809 bytes, 5000 examples
- download_size: 231655673 bytes
- dataset_size: 548019112 bytes
配置 et
- features: id, text, label
- splits:
- train: 173878667 bytes, 23126 examples
- test: 56535275 bytes, 5000 examples
- validation: 39580854 bytes, 5000 examples
- download_size: 121905437 bytes
- dataset_size: 269994796 bytes
配置 fi
- features: id, text, label
- splits:
- train: 336145889 bytes, 42497 examples
- test: 63280908 bytes, 5000 examples
- validation: 44500028 bytes, 5000 examples
- download_size: 195677552 bytes
- dataset_size: 443926825 bytes
配置 fr
- features: id, text, label
- splits:
- train: 442358833 bytes, 55000 examples
- test: 68520115 bytes, 5000 examples
- validation: 48408926 bytes, 5000 examples
- download_size: 238411609 bytes
- dataset_size: 559287874 bytes
配置 hr
- features: id, text, label
- splits:
- train: 80808161 bytes, 7944 examples
- test: 56790818 bytes, 5000 examples
- validation: 23881820 bytes, 2500 examples
- download_size: 75125597 bytes
- dataset_size: 161480799 bytes
配置 hu
- features: id, text, label
- splits:
- train: 208805826 bytes, 22664 examples
- test: 68990654 bytes, 5000 examples
- validation: 48101011 bytes, 5000 examples
- download_size: 139218484 bytes
- dataset_size: 325897491 bytes
配置 it
- features: id, text, label
- splits:
- train: 429495741 bytes, 55000 examples
- test: 64731758 bytes, 5000 examples
- validation: 45886525 bytes, 5000 examples
- download_size: 234660000 bytes
- dataset_size: 540114024 bytes
配置 lt
- features: id, text, label
- splits:
- train: 185211655 bytes, 23188 examples
- test: 59484699 bytes, 5000 examples
- validation: 41841012 bytes, 5000 examples
- download_size: 129472683 bytes
- dataset_size: 286537366 bytes
配置 lv
- features: id, text, label
- splits:
- train: 186396216 bytes, 23208 examples
- test: 59814081 bytes, 5000 examples
- validation: 42002715 bytes, 5000 examples
- download_size: 128328277 bytes
- dataset_size: 288213012 bytes
配置 mt
- features: id, text, label
- splits:
- train: 179866757 bytes, 17521 examples
- test: 65831218 bytes, 5000 examples
- validation: 46737902 bytes, 5000 examples
- download_size: 124555157 bytes
- dataset_size: 292435877 bytes
配置 nl
- features: id, text, label
- splits:
- train: 430232711 bytes, 55000 examples
- test: 64728022 bytes, 5000 examples
- validation: 45452538 bytes, 5000 examples
- download_size: 230198155 bytes
- dataset_size: 540413271 bytes
配置 pl
- features: id, text, label
- splits:
- train: 202211442 bytes, 23197 examples
- test: 64654967 bytes, 5000 examples
- validation: 45545505 bytes, 5000 examples
- download_size: 139057595 bytes
- dataset_size: 312411914 bytes
配置 pt
- features: id, text, label
- splits:
- train: 419281855 bytes, 52370 examples
- test: 64771235 bytes, 5000 examples
- validation: 45897219 bytes, 5000 examples
- download_size: 227523733 bytes
- dataset_size: 529950309 bytes
配置 ro
- features: id, text, label
- splits:
- train: 164966652 bytes, 15921 examples
- test: 67248460 bytes, 5000 examples
- validation: 46968058 bytes, 5000 examples
- download_size: 118725499 bytes
- dataset_size: 279183170 bytes
配置 sk
- features: id, text, label
- splits:
- train: 188126733 bytes, 22971 examples
- test: 60922674 bytes, 5000 examples
- validation: 42786781 bytes, 5000 examples
- download_size: 134874710 bytes
- dataset_size: 291836188 bytes
配置 sl
- features: id, text, label
- splits:
- train: 数据未提供
- test: 数据未提供
- validation: 数据未提供
- download_size: 数据未提供
- dataset_size: 数据未提供