
遇见数据集

namakoo/idfu-cpython-bytecode-specialty

收藏
Hugging Face2026-04-30 更新2026-05-03 收录
官方服务:

资源简介:

IDFU CPython字节码专业包是一个专注于CPython字节码操作和分析的Python失败数据集,设计为IDFU代码失败数据集家族的低成本入口点。数据集包含100个样本,主要用于Python内部/解释器黑客,包括错误检测、DPO拒绝侧训练数据、代码审查模型微调等用途。数据集经过严格的质量验证,包括AST规范化、静态lint门控、容器化Python执行等。此外,数据集还提供了10个免费样本供预览。

The IDFU CPython Bytecode Specialty Pack is a single-domain Python failure dataset focused on CPython_Bytecode_Manipulation_and_Analysis, designed as a low-cost entry point to the IDFU Code Failure Dataset family. It contains 100 samples and is intended for Python internals / interpreter hackers, including use cases such as error detection for Python tooling / interpreter code, DPO rejected-side data for code generators that produce bytecode-manipulating Python, and benchmark augmentation for Python internals research. The dataset undergoes rigorous quality assurance, including α-normalized AST canonical-hash deduplication, static lint gates, containerized Python execution, and a proprietary internal QA pipeline. A free preview of 10 samples is also available.
提供机构:
namakoo
搜集汇总
数据集介绍
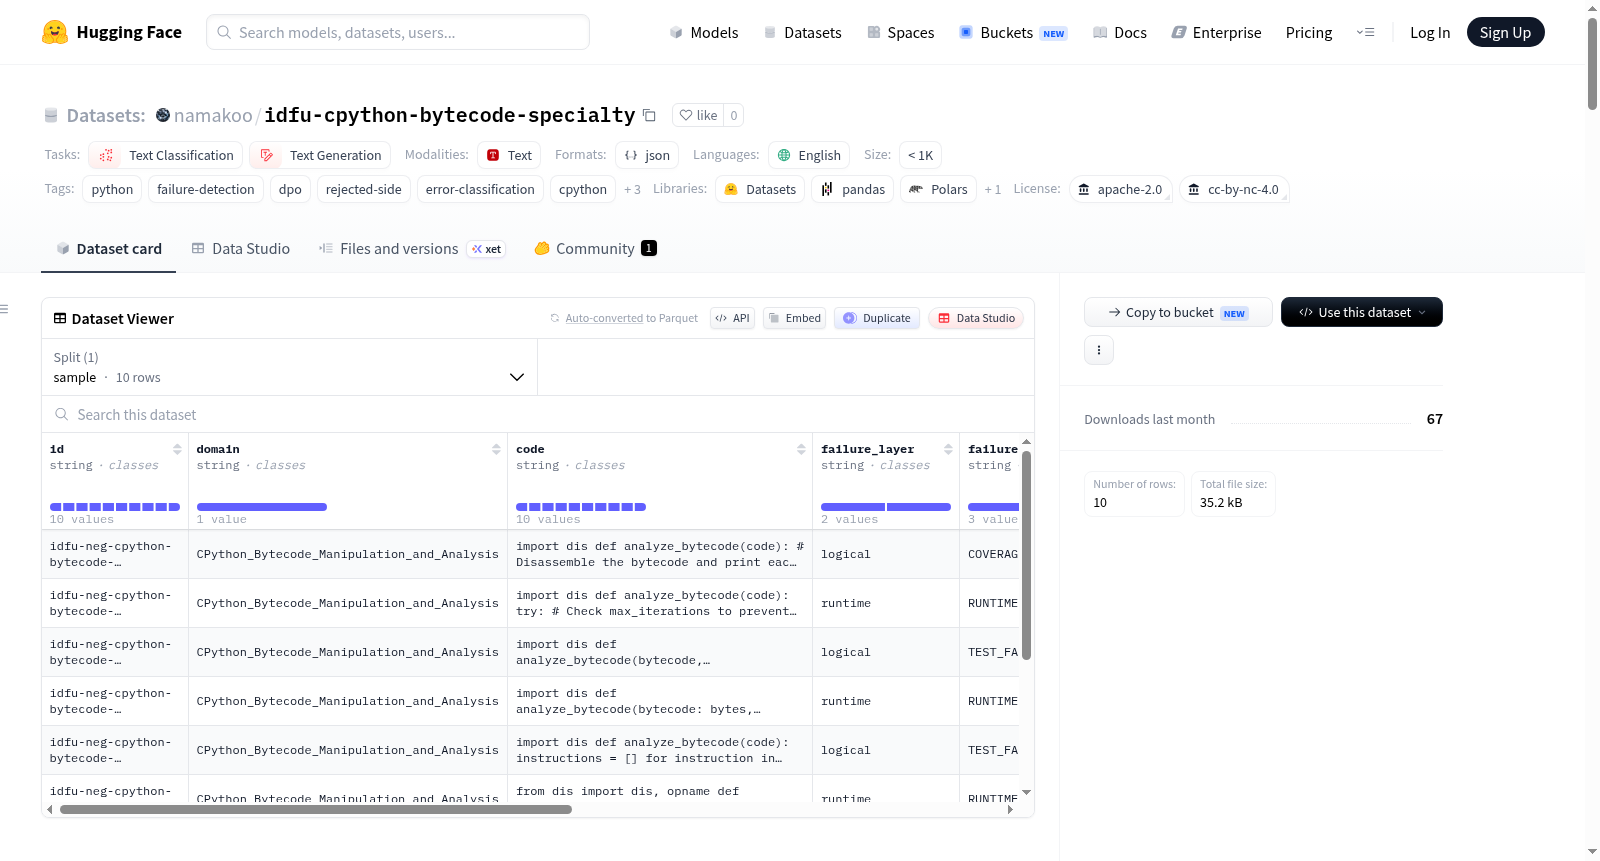
namakoo/idfu-cpython-bytecode-specialty 数据集图片
构建方式
IDFU CPython Bytecode Specialty Pack 是一个专注于 CPython 字节码操作与分析领域的单领域代码故障数据集,作为 IDFU 代码故障数据集家族的入门级产品而设计。该数据集包含 100 个样本,每个样本均经过严格的验证管线处理。构建流程包括:通过 α-归一化 AST 规范哈希进行去重以消除仅存在语法差异的重复项;执行静态代码检查以过滤死函数、未使用导入等问题;在容器化环境中运行 Python 代码并结合 pytest 测试工具捕获实际执行失败信息;同时经过指令质量过滤,剔除内容不达标或存在占位符的样本。每个样本包含代码、故障层级(如语法、运行时、逻辑等)、故障类别、错误日志以及原始任务指令等字段,确保数据来源真实、结构完整。
特点
该数据集的核心优势在于其高度的领域专注性和严格的质量保障。所有样本均围绕 CPython 字节码的操控与解析,覆盖了 dis 模块误用、字节码迭代深度限制错误以及堆栈语义分析中的边界情况等真实故障模式。每个样本均源自实际 pytest 执行跟踪,而非由大语言模型虚构的代码缺陷,具备训练级信号价值。数据集采用 v3.0 证书模式,与售价 49 美元的主版本共享同一验证管线,且所有样本的规范哈希均不与先前发布的任何 IDFU 版本重复,确保购买后数据严格扩充而非重叠。同时提供 10 个免费预览样本,便于用户在购买前评估数据质量与适配性。
使用方法
该数据集适用于多种下游任务场景,例如训练面向 Python 工具与解释器代码的错误检测模型、作为 DPO 训练中 rejected 侧数据以提升字节码操作相关代码生成器的表现,以及用于 Python 内部机制研究的基准增强。用户可通过 Hugging Face 仓库获取免费的 10 样本预览文件 data_sample.jsonl,以快速检查数据格式和内容。完整 100 样本包可通过 Stripe 购买,交付内容包含 data.jsonl 与 data.parquet 文件、质量证书、许可证及元数据文档。数据加载支持 Python 3.10 以上环境,可使用 pandas 或 datasets 库读取 JSONL 或 Parquet 格式,方便集成至现有训练流程。需要注意的是,该数据集仅供 rejected 侧训练使用,建议与用户自身的正向数据搭配以完成完整训练。
背景与挑战
背景概述
IDFU CPython Bytecode Specialty Pack是由IDFU团队开发的单领域Python代码失效数据集,创建于2024年,专注于CPython字节码操作与分析这一特定子领域。该数据集隶属于IDFU Code Failure Dataset系列,由研究团队namakoo主导构建,旨在为Python解释器内部机制研究者、工具链开发者以及代码生成模型训练者提供高质量的错误检测训练资源。核心研究问题围绕如何通过真实执行失败样本提升代码模型在字节码操作场景下的故障识别与修复能力。该数据集以100样本的试装包形式发布(定价9美元),并附带10样本免费预览,为后续扩展到19领域、2000样本的主发行版本提供了低成本入门途径。其对相关领域的影响力体现在为DPO训练中的rejected侧数据提供了精准的领域内失效模式,并在基于Qwen2.5-Coder-3B-Instruct的HumanEval基准上取得了+3.46个百分点的pass@1提升,验证了验证管线的有效性。
当前挑战
该数据集所解决的领域问题核心挑战在于Python字节码操作与分析的代码生成与故障检测。字节码层面的错误种类繁多且隐蔽,例如dis模块误用导致的TypeError、字节码迭代深度限制引发的越界错误、以及栈语义分析中的操作码解码与跳转目标解析难题,这些在通用代码数据集中鲜有覆盖。构建过程中面临的挑战包括:确保每一条样本都来自真实的pytest执行失败轨迹,而非由大模型人工合成;通过α归一化AST哈希去重消除表面重复样本,维持数据新鲜度;设计包含语法错误、运行时错误、逻辑错误、语义错误、公理错误及代码规范错误在内六层失效分类体系;以及严格的含代码审查指令质量过滤和容器化执行验证,最终保证样本的领域一致性(100%聚焦字节码)和不重复性(所有哈希值均未出现在先前版本中)。
常用场景
经典使用场景
在Python内部机制与字节码操控研究领域,该数据集的核心应用场景聚焦于训练面向CPython解释器代码的缺陷探测器。具体而言,它可用于构建能够识别`dis`模块误用、字节码迭代深度越界以及栈语义分析边缘情况的分类器。数据集中的每个样本均包含经过验证的失败代码片段及其对应的原始指令,这使得它成为训练代码生成模型时作为DPO训练中rejected侧数据的理想选择,尤其适用于那些需要生成涉及字节码内省或装饰器高阶用法的Python代码的场景。
解决学术问题
该数据集精准地解决了Python内部机制研究中一个长期存在的难题:缺乏经过严格验证的、领域聚焦的失败样本集合。学术研究常因无法获得真实且多样化的字节码操作错误数据而受限,难以系统性地评估和提升代码模型在此细分场景下的错误检测与修复能力。通过提供100个经过AST去重、容器化执行与pytest测试套件验证的失败样本,该数据集为量化分析字节码操控中的常见错误模式(如类型错误、递归守卫失效)提供了可靠的实验基础,从而推动相关学术问题的深入探索。
衍生相关工作
该数据集作为IDFU代码失败数据集家族中专精于CPython字节码领域的小型试用包,其设计与构建流程直接催生了更高层次的衍生工作。最为典型的范例是,其数据验证管道与v3.0证书模式已被成功复用于跨越19个领域的主版本发布(v1、v2、v3),每个版本均包含2000个样本。此外,基于相同管道生成的Monte Carlo领域数据集已在DPO基准测试中证明了其训练信号的有效性,使得主流代码模型(如Qwen2.5-Coder-3B-Instruct)在HumanEval上的通过率提升了约3.46个百分点,这一成果为后续将失败数据注入模型偏好对齐训练的研究提供了方法论支撑。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

