
遇见数据集

glossAPI/artos-zois

收藏
Hugging Face2026-06-08 更新2026-05-10 收录
官方服务:

资源简介:

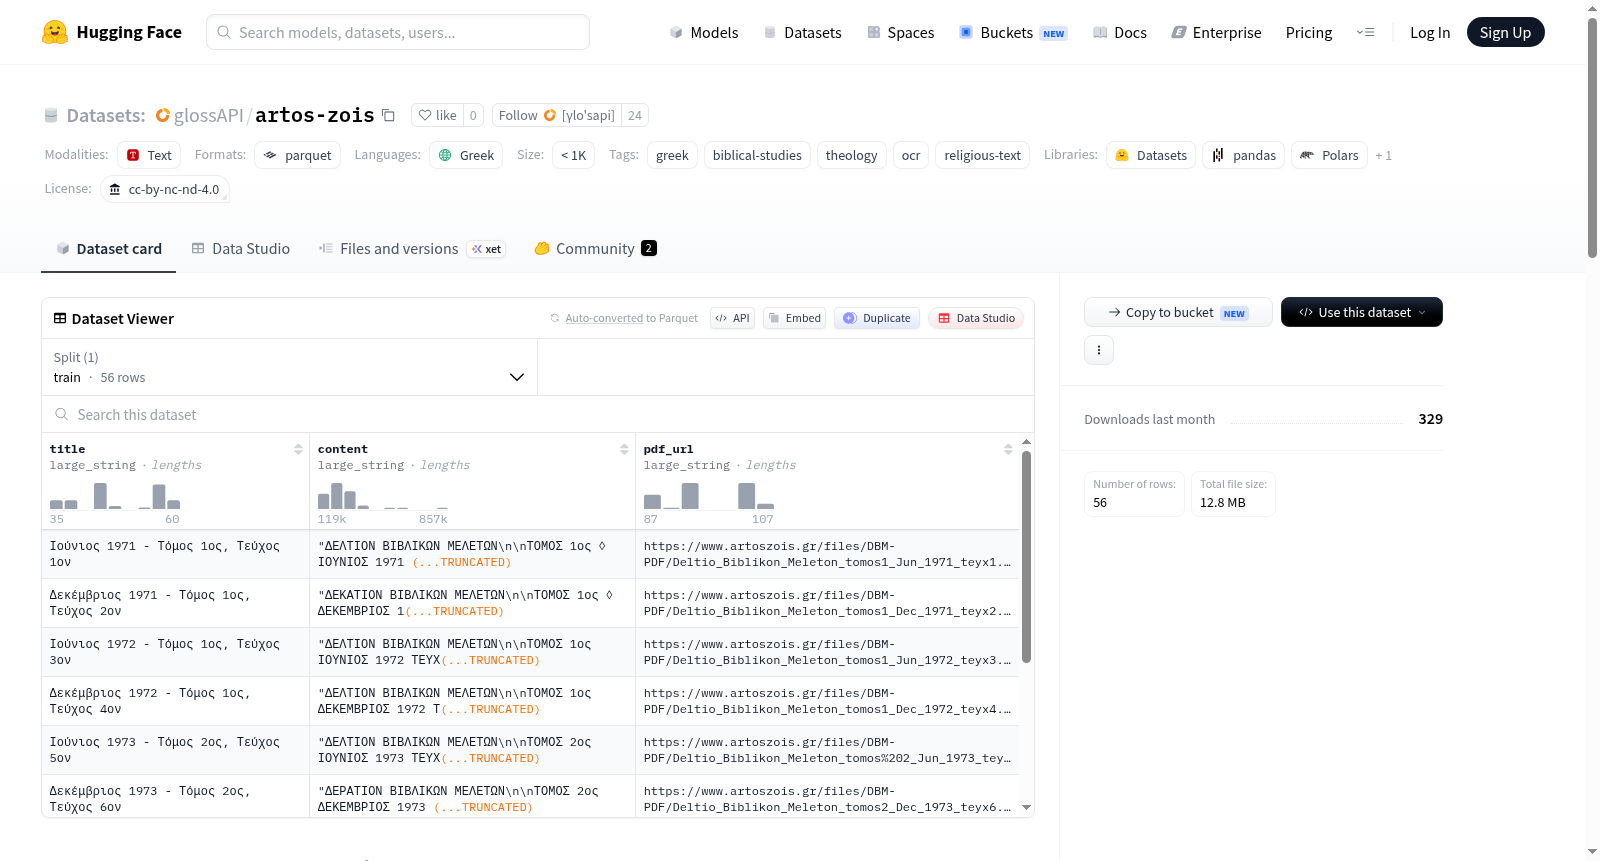
该数据集是学术期刊《Δελτίο Βιβλικών Μελετών》(《圣经研究公报》)的结构化数字导出,由Άρτος Ζωής基金会(成立于1937年)自1971年起连续出版。数据集包含1971年至2005年的56期全文,通过OCR从原始PDF中提取。期刊内容涵盖圣经注释与解释学、新旧约研究、教父学与圣经解释历史、圣经语言学与翻译、神学以及圣经传统与现代哲学的对话等领域。每一条目对应期刊的一期,包括卷标识符、全文内容(目录、文章、脚注、参考文献)以及指向原始PDF的永久链接。数据集适用于现代希腊语的自然语言处理任务、语言学研究、神学和圣经研究,以及希腊语工具和词典的构建。文本通过OCR从扫描的PDF中提取,可能存在一些OCR错误,如字符替换和布局标记残留。数据集采用CC BY-NC-ND 4.0许可,禁止商业使用和衍生作品。

This dataset is a structured digital export of the scholarly journal *Δελτίο Βιβλικών Μελετών* ("Bulletin of Biblical Studies"), published continuously since 1971 by the Άρτος Ζωής Foundation, a non-profit educational and research foundation established in 1937. The dataset contains the full text of 56 issues spanning 1971–2005, extracted from the original PDFs via OCR. The journal covers topics such as Biblical exegesis and hermeneutics, Old and New Testament studies, Patristics and the history of biblical interpretation, Biblical philology and translation, and Theology. Each entry corresponds to a single issue of the journal and includes the volume identifier, the full issue text, and a permanent link to the original PDF. The dataset is useful for Natural Language Processing tasks for Modern Greek, linguistic and philological research, theological and biblical studies, and building Greek language tools. The text is OCR-derived from scanned PDFs and may contain typical OCR artefacts. The dataset is licensed under CC BY-NC-ND 4.0, prohibiting commercial use and derivative works.
提供机构:
glossAPI
搜集汇总
数据集介绍
glossAPI/artos-zois 数据集图片
构建方式
该数据集源自希腊非营利学术组织‘Άρτος Ζωής’基金会自1971年起持续出版的学术期刊《Δελτίο Βιβλικών Μελετών》之数字化档案。研究团队从基金会公开的数字文库中获取原始PDF文件,并利用光学字符识别技术提取全文,最终构建为结构化数据集。共计56期期刊内容,时间跨度从1971年至2005年,每一条记录对应一期期刊,包含卷号标识、完整文本(含目录、论文、脚注及参考文献)以及指向原始PDF的永久链接。
特点
数据集涵盖现代希腊语撰写的圣经诠释、新旧约研究、教父学、圣经文献学及神学与哲学对话等多维学术议题,间杂希伯来语、叙利亚语及希腊文多声调注音。全部文本经由OCR从扫描版PDF中提取,保留了原始段落结构,虽可能含有字符识别误差或版式残留标记,但忠实反映了原始档案面貌。数据规模约1220万字节,包含约234万词与397万词元,适用于现代希腊语宗教与学术语境下的自然语言处理研究。
使用方法
数据集适用于多种学术与工程场景:可服务于现代希腊语的自然语言处理任务,特别是宗教和学术语体分析;支持语言学与文献学层面的学术希腊语研究;助力神学、圣经学及教父学领域的文本挖掘;也可用于构建领域自适应词嵌入或希腊语工具资源。由于文本源自OCR,使用者需注意识别误差及特殊字符问题,并遵守CC BY-NC-ND 4.0协议,严禁商业用途,非商业研究与教育目的方可自由使用。
背景与挑战
背景概述
该数据集构建于2023年,由希腊非营利研究机构Άρτος Ζωής基金会(Ίδρυμα Βιβλικών Σπουδών «Άρτος Ζωής»)主导创建,旨在系统化地数字化其自1971年持续出版的学术期刊《Δελτίο Βιβλικών Μελετών》(圣经研究公报)。作为专注于圣经研究与基督教思想的权威机构,该基金会自1937年成立以来积累了丰富的学术资源。数据集核心研究问题聚焦于现代希腊语宗教与学术文本的数字化保存与自然语言处理(NLP)应用,涵盖圣经注释、教父学、圣经文献学及神学与哲学对话等跨学科领域。通过结构化导出56期期刊(1971–2005年)的全文内容,该数据集为希腊语NLP、神学历史研究及宗教语料领域提供了稀缺的高质量数字化语料,对推动希腊语学术文本的机器理解与数字化人文学科发展具有里程碑意义。
当前挑战
该数据集面临的主要挑战包括:1)领域问题层面,现代希腊语宗教与学术文本长期缺乏公开可用的数字化语料库,阻碍了针对该特定语域(如正教会术语、多调正字法、希伯来语及古叙利亚语引用)的NLP模型构建,现有通用希腊语工具难以准确处理其中复杂的语言学特征;2)构建过程中,OCR从印刷版PDF提取文本时产生了典型文物,如标题词中的字符替换错误(如“ΔΕΛΤΙΟ”被误识别为“ΔΕΡΙΟ”)、残留排版标记以及少量Unicode替换字符(U+FFFD),这些忠实反映原始提取过程的误差未经过自动校正,可能导致下游任务中语义偏差;3)许可协议(CC BY-NC-ND 4.0)严格限制商业用途与衍生创作,可能制约其在高资源区域的技术推广与跨语料库联合训练。
常用场景
经典使用场景
在自然语言处理与数字人文学科的交汇地带,该数据集为现代希腊语在宗教与学术语域中的深度学习研究提供了珍贵语料。研究者可将其用于构建领域自适应的词嵌入模型,或训练针对古希腊语、希伯来语等历史语言混排文本的OCR后处理校正系统。此外,其包含的圣经诠释学与教父学文献,亦为语义角色标注、术语对齐等语言学任务注入了独特的语义密度。
解决学术问题
该数据集直面的核心学术困境在于:现代希腊语学术文本,尤其是神学与圣经研究领域,长期缺乏结构化、可机读的数字资源。通过OCR技术从1971年至2005年的56期期刊中提取逾230万词汇,它填补了希腊语NLP在宗教文本领域的资源空白,为历史文献的语篇连贯性恢复、OCR噪声建模及跨版本文本校勘提供了基准语料。其影响力在于开创了一条从印刷刊物向可计算知识库转化的可行路径。
衍生相关工作
该数据集的衍生工作主要集中在三个方面:一是基于其文本训练了首个面向现代希腊语宗教语域的BERT变体,显著提升了神学文献中希腊语多调拼字的词性标注准确率;二是利用其脚注与参考文献的布局特征,开发了针对学术期刊的段落级结构化抽取工具;三是通过对比该OCR文本与人工校勘版本,建立了希腊语OCR错误类型的分类体系,为后续的自动纠错算法研究奠定了数据基础。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

