
遇见数据集

FairJob

收藏
arXiv2025-09-30 收录
官方服务:

资源简介:

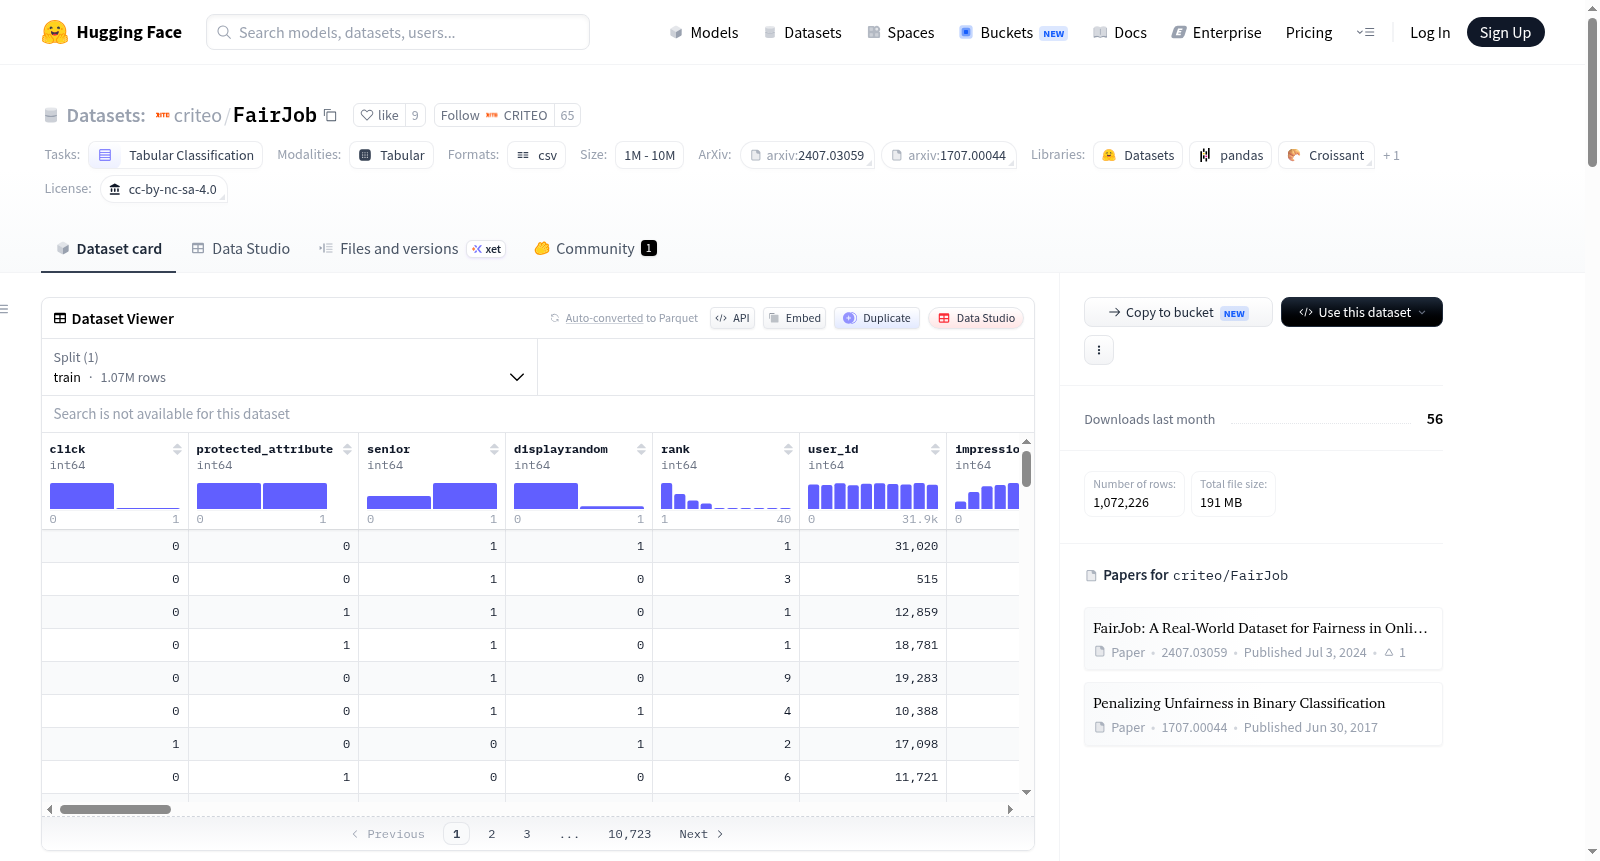
该数据集是一个注重算法公平性的求职推荐广告数据集,旨在推动有关算法公平性的研究。该数据集记录了求职广告推荐在性别偏见方面的表现,包含20个分类特征和39个数值特征,以及一个二进制的点击标签和用户性别的代理变量。它捕捉了在一场针对性的求职活动期间,用户在5个月内的互动情况。该数据集规模为1,072,226行,任务是对求职推荐进行评估,并在点击预测中考察偏见。

This dataset is a job recommendation advertisement dataset that prioritizes algorithmic fairness, designed to advance research on algorithm fairness. It records the performance of job advertisement recommendations regarding gender bias. The dataset contains 20 categorical features, 39 numerical features, a binary click label, and a proxy variable for user gender. It captures user interactions over a 5-month period during a targeted job recruitment campaign. With a total of 1,072,226 rows, the dataset is intended for the task of evaluating job recommendations and investigating bias in click prediction.
提供机构:
Criteo
搜集汇总
数据集介绍
FairJob 数据集图片
构建方式
FairJob数据集源自Criteo广告技术公司为期五个月的真实职位定向广告活动,经过严格的隐私保护处理。数据采集遵循GDPR规范,对用户标识符进行假名化处理,并通过随机投影技术对特征名称和数值进行匿名化,在保留预测能力的同时彻底阻断原始特征与用户身份的关联。数据集包含1,072,226条记录,每条对应一次广告展示,涵盖20个类别特征、39个数值特征、点击标签以及一个基于用户交互行为推断的性别代理变量。为符合商业保密要求,数据经过非均匀子采样以隐藏业务指标。
特点
该数据集的核心特色在于其真实性与挑战性兼备。它捕捉了在线广告系统中从受众选择到实时竞价再到广告推荐的全链条潜在偏差,尤其聚焦于就业机会这一高敏感领域。数据集呈现了强类别不平衡(正样本比例低于0.7%)、长尾分布和流行度偏差等现实难题。通过提供性别代理变量而非真实敏感属性,它模拟了工业环境中受隐私法规限制而无法获取受保护属性的典型困境。此外,数据集包含展示位置排名和随机化标识,支持对位置偏差的控制与公平性评估。
使用方法
研究者可利用该数据集训练点击预测模型,并通过比较不同训练策略(如公平性无感知、公平性惩罚正则化)下的预测分布差异来评估算法公平性。论文提供了基于反事实公平框架的评估指标,包括考虑选择偏差的修正效用度量。建议在随机化展示子集上计算点击排名效用以避免位置干扰。该数据集还可用于探索隐私保护技术、混合型表格数据的嵌入学习,以及面向不平衡数据的鲁棒建模方法。所有实验代码和超参数调优流程均已开源以保障可复现性。
背景与挑战
背景概述
在算法公平性研究领域,在线广告系统因其对用户隐私的敏感性和对就业机会等宝贵资源的分配影响,成为亟待深入探索的高风险场景。然而,现有公开数据集中缺乏能够真实反映在线广告系统中算法偏差的规模化资源,这限制了公平性研究的可复现性与实践指导价值。为弥补这一空白,Criteo AI Lab的Mariia Vladimirova、Eustache Diemert与巴黎多芬大学的Federico Pavone于2024年共同推出了FairJob数据集。该数据集基于为期五个月的职位定向广告活动收集,包含超过100万条用户与产品交互记录,并创新性地通过用户行为代理变量近似性别等受保护属性,在遵守隐私法规的前提下,为研究者提供了探究推荐系统公平性与效用权衡的真实基准。
当前挑战
FairJob数据集所面临的挑战首先体现在其解决的领域问题层面:在线广告中的职位推荐需在高度不平衡的数据(正样本比例低于0.7%)中实现公平性,同时应对选择偏差、市场偏差及推荐位置偏差等多重偏差源,这些偏差可能放大历史不平等并导致对特定用户群体的歧视性展示。其次,在数据集构建过程中,最大的挑战在于缺乏对用户受保护属性(如性别)的直接访问权限,研究团队不得不设计基于产品交互行为的代理变量,但代理变量的准确性和因果关联难以验证;此外,为满足商业机密与隐私法规要求,特征名称需匿名化且数值需随机投影,这既保留了预测能力,又增加了从数据中恢复原始用户上下文的难度,使得偏差检测与缓解方法的评估更加复杂。
常用场景
经典使用场景
在在线广告与求职推荐系统的交叉领域,FairJob数据集为研究算法公平性提供了真实世界的基准测试平台。其核心应用场景聚焦于评估和缓解广告投放过程中的性别偏见,尤其是在高风险的招聘广告领域。研究者利用该数据集训练点击预测模型,并通过其提供的受保护属性代理变量(如性别代理),量化模型在不同用户群体间的预测偏差,从而检验公平性感知算法(如公平性正则化)在真实业务数据上的有效性。
实际应用
在实际应用中,FairJob数据集被用于审计和优化招聘广告投放系统的公平性,确保不同性别的用户能平等地获得就业机会。广告技术公司可借助该数据集训练公平性增强的推荐模型,避免因历史数据偏见导致的管理岗位广告过多展示给男性用户,从而降低法律合规风险(如AI法案、公平住房法)。此外,它还能帮助平台在保护用户隐私(不直接收集敏感属性)的前提下,通过代理变量实现公平性监控。
衍生相关工作
该数据集催生了多项衍生工作:在方法层面,推动了面向表格数据的公平性深度学习模型(如ResNet、Transformer)的评估基准建立;在隐私领域,启发了基于差分隐私或联邦学习的去偏技术研究;在度量层面,其提出的选择偏差校正效用函数被后续工作用于广告系统的公平性审计。此外,该数据集还促进了非均衡分类场景下公平性算法的开发,以及跨领域(如金融、医疗)公平性数据集的标注与发布范式探索。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

