
Next Steps Core dataset
收藏资源简介:
Next Steps Core数据集是由伦敦大学学院纵向研究中心创建的纵向队列研究数据集,旨在为健康和社会科学研究提供经过清洗、可直接用于分析的标准化数据。该数据集源自英国'Next Steps'纵向研究,涵盖从14岁至32岁多个波次的调查数据,包含102个衍生变量,涉及人口统计、教育、健康和社会经济等多个领域,数据经过专业研究人员处理并独立验证。数据集通过整合多波次原始调查变量构建而成,采用'宽格式'存储,既包含随时间变化的动态指标,也涵盖固定特征。该数据集主要用于评估大型语言模型在敏感数据治理受限环境下的数据准备能力,为解决纵向研究中的数据清洗、变量构建和多数据集合并等瓶颈问题提供基准测试框架。
The Next Steps Core Dataset is a longitudinal cohort study dataset developed by the Centre for Longitudinal Studies, University College London, designed to provide cleaned, analysis-ready standardized data for health and social science research. Derived from the UK's 'Next Steps' longitudinal study, this dataset covers multi-wave survey data collected from participants aged 14 to 32, and includes 102 derived variables spanning demographics, education, health, socioeconomics and other domains. The data has been processed and independently validated by professional researchers. Constructed by integrating multi-wave original survey variables, the dataset is stored in 'wide format', incorporating both time-varying dynamic indicators and fixed participant characteristics. This dataset is primarily intended to evaluate the data preparation capabilities of Large Language Models (LLMs) in environments with restricted sensitive data governance, and provides a benchmark framework for addressing bottleneck issues in longitudinal research such as data cleaning, variable construction, and multi-dataset merging.
数据集名称
Next Steps Longitudinal Dataset(纵向追踪数据集)
数据集概览
- 提供机构:伦敦大学学院纵向研究中心(Centre for Longitudinal Studies, UCL)
- 当前状态:工作进展中(Work in Progress)
- 核心目的:通过R脚本将Next Steps研究的多轮次数据整合为一个清洗后的单一数据集,方便研究者直接开展分析,无需重复编码。
变量域及示例
| 变量域 | 示例变量 |
|---|---|
| 人口学信息 | 性别、民族、语言、性取向、伴侣关系、所在地区 |
| 教育 | 学历、父母学历 |
| 社会经济 | 个人经济活动状况、父母经济活动状况、个人社会经济分类(NSSEC)、父母社会经济分类(NSSEC)、住房所有权、家庭收入、多重剥夺指数(IMD) |
| 身心健康 | 心理困扰、生活满意度、自残、焦虑、抑郁、孤独感、长期疾病、自评健康 |
| 人体测量 | 体重、身高、身体质量指数(BMI) |
| 行为 | 吸烟、饮酒、药物使用、锻炼、缺课、与警方接触、遭受欺凌 |
数据来源
- 原始数据集可通过英国数据服务(UK Data Service)下载(Next Steps系列,ID: 2000030)。
- 本仓库衍生的变量数据集完成后将另行存放。
使用方式
- 准备原始数据:从UK Data Service下载Next Steps研究(Study 5545,最终用户许可版本)的Stata格式(.dta)文件,解压后将文件夹或文件放置于
data/UKDA-5545-stata/.../safeguarded_eul/路径下。 - 运行完整流程:在项目根目录运行
build-core-dataset.R脚本,即可生成衍生数据集并输出至data/derived/文件夹。 - 查看特定变量:可单独查看
R/文件夹下的领域脚本(如R/02-education.R对应教育变量),但运行前需先执行R/00-load-raw-data.R加载原始数据。
版本控制
- 代码基于 R v4.5.2 运行,R包版本通过
renv管理。 - 若需以相同包版本重现代码,需先安装
renv包,并在项目根目录运行renv::restore()。
仓库结构
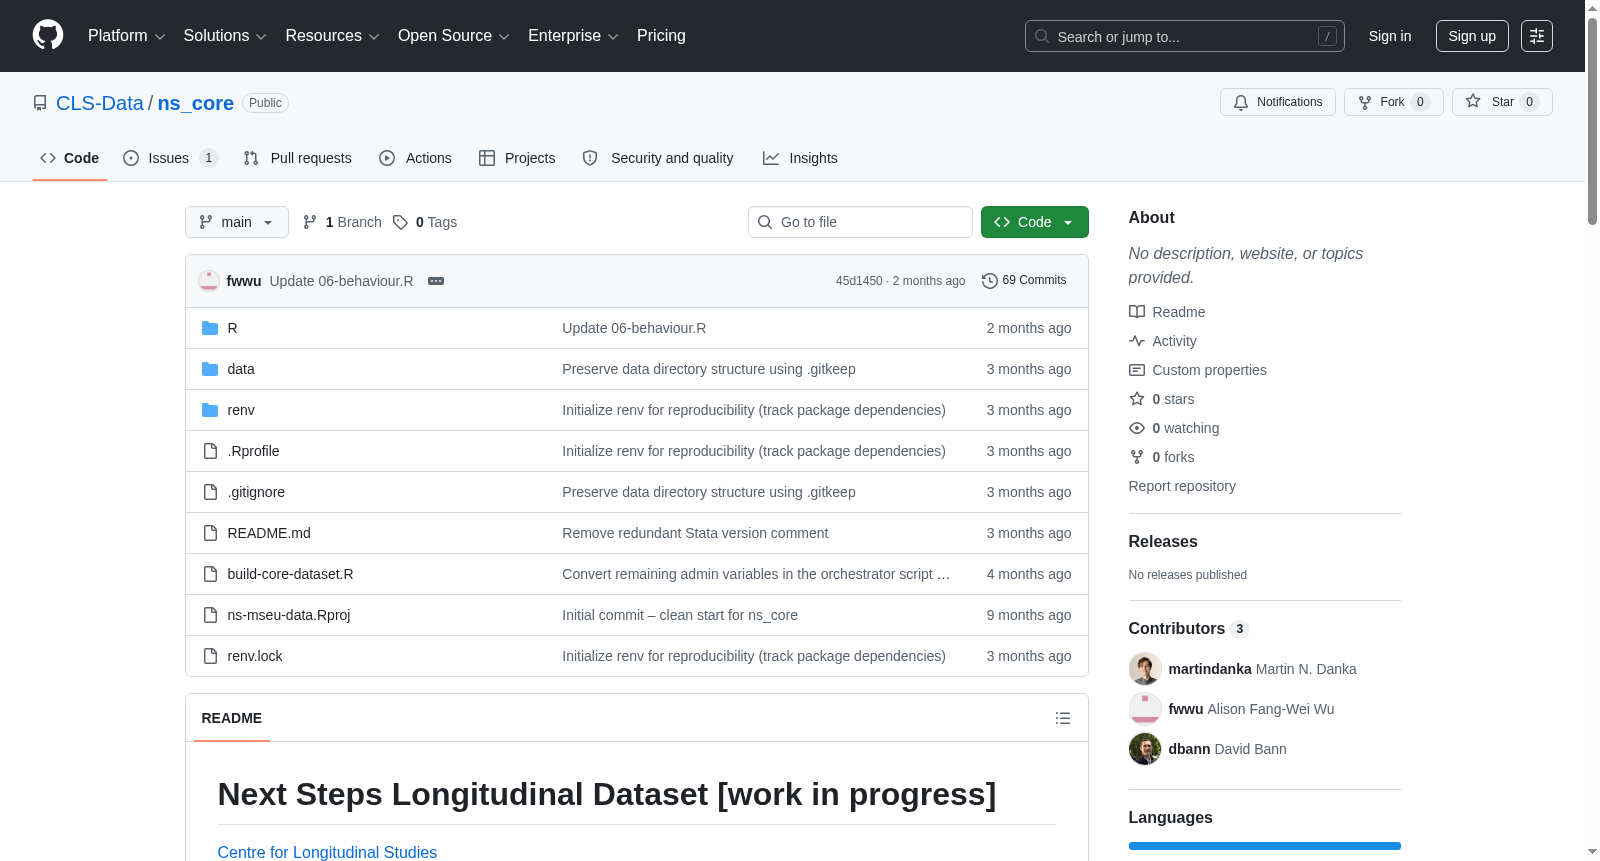
. ├── build-core-dataset.R # 主脚本:从原始数据生成衍生数据集 ├── R/ # 领域专用脚本,由主脚本调用 │ ├── 00-load-raw-data.R # 加载原始.dta文件 │ ├── 01-demographic.R │ ├── 02-education.R │ ├── 03-socioeconomic.R │ ├── 04-health.R │ ├── 05-anthropometric.R │ ├── 06-behaviour.R │ └── helpers.R # 共享的重新编码辅助函数 ├── data/ │ ├── UKDA-5545-stata/.../safeguarded_eul/ # 放置原始.dta文件 │ └── derived/ # 输出衍生数据集 ├── renv.lock # R包版本锁定文件 └── .Rprofile # 会话启动时自动激活renv
许可与反馈
- 代码许可:MIT许可(详见仓库中的
LICENSE文件)。 - 数据许可:衍生数据集使用仍需遵守Next Steps的最终用户许可条款。
- 反馈与未来计划:欢迎用户反馈,计划在未来版本中扩展数据集。联系邮箱:clsdata@ucl.ac.uk。
- 1Agentic coding without the cloud: evaluating open-weight large language models on longitudinal data preparation tasks伦敦大学学院·高级计算研究中心; 伦敦大学学院·纵向研究中心; 布里斯托大学·英国纵向链接合作组织 · 2026年


