
遇见数据集

surrey-nlp/S3D-v2

收藏
Hugging Face2022-12-17 更新2024-03-04 收录
官方服务:

资源简介:

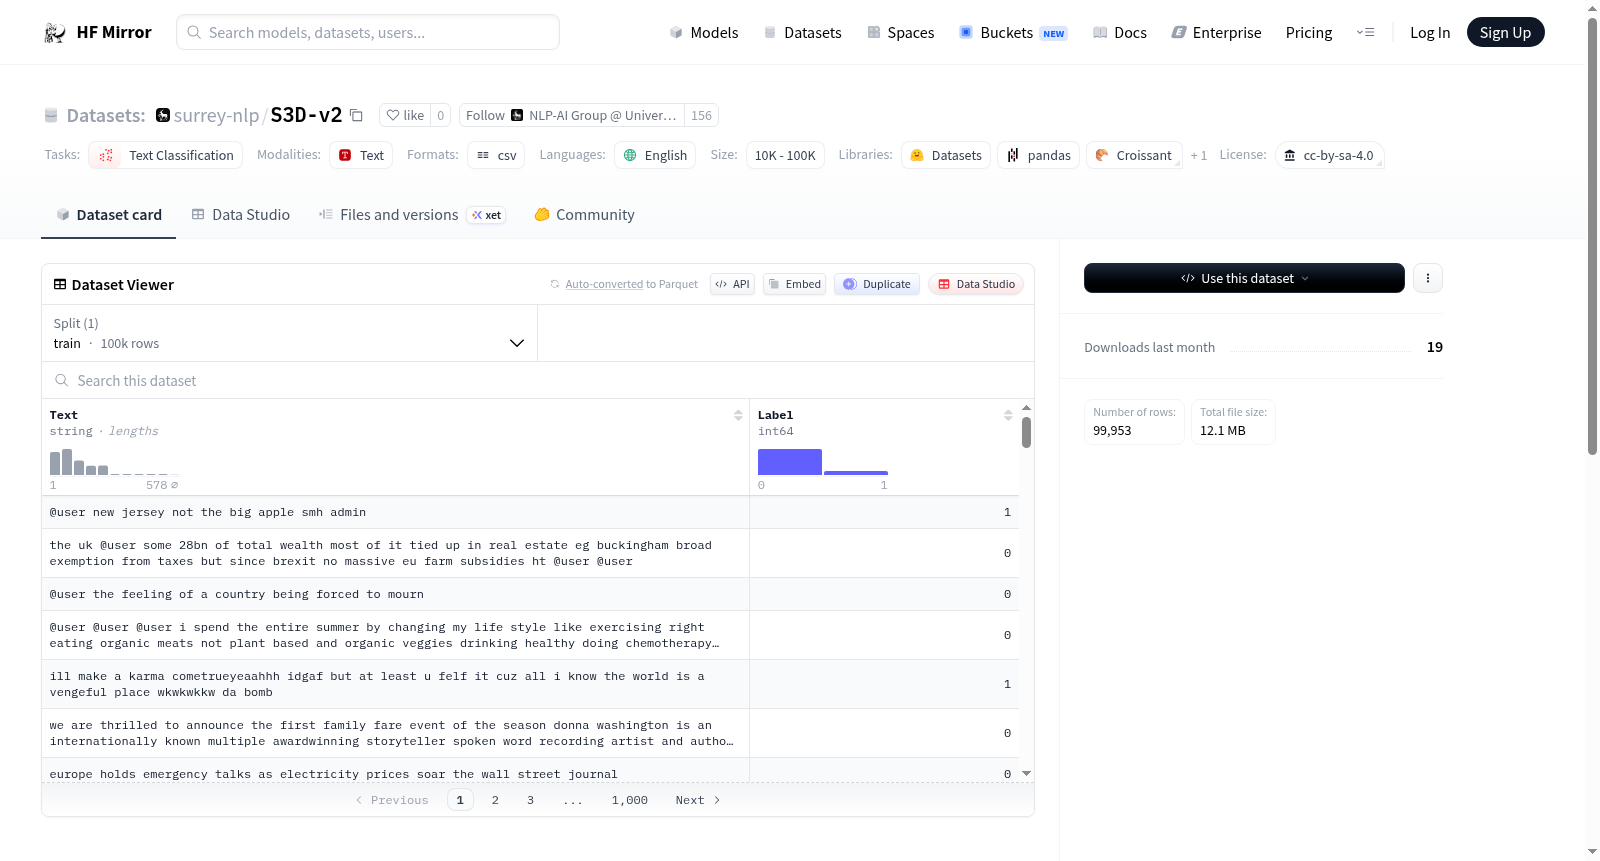
S3D数据集是一个用于构建讽刺检测模型的数据集,由Jordan Painter和Diptesh Kanojia创建。该数据集包含10万条推文,其中13,016条被标记为讽刺,86,904条标记为非讽刺。数据集使用弱监督方法进行标注,通过多数投票系统利用三个微调的讽刺检测模型进行标注。数据集分为训练集(70,000条)、验证集(15,000条)和测试集(15,000条),所有内容均为英文,并根据CC-BY-SA-4.0许可证发布。

The S3D Dataset is a dataset for constructing sarcasm detection models, created by Jordan Painter and Diptesh Kanojia. It contains 100,000 Tweets, among which 13,016 are labeled as sarcastic and 86,904 are labeled as non-sarcastic. The dataset is annotated using a weak supervision approach, which leverages three fine-tuned sarcasm detection models via a majority voting system. It is split into the training set (70,000 instances), validation set (15,000 instances) and test set (15,000 instances). All content is in English, and the dataset is released under the CC-BY-SA-4.0 license.

提供机构:
surrey-nlp
原始信息汇总

数据集概述

基本信息

  • 名称: S3D
  • 别名: Utilising Weak Supervision to create S3D
  • 语言: 英语
  • 许可: cc-by-sa-4.0
  • 多语言性: 单语种
  • 大小: 100K<n<1M
  • 来源: 原始数据
  • 任务类别: 文本分类

详细描述

  • 创建者: Jordan Painter, Diptesh Kanojia
  • 目的: 构建讽刺检测模型
  • 数据构成: 包含13,016条标为讽刺的推文和86,904条标为非讽刺的推文
  • 数据字段:
    • Text: 预处理的推文内容
    • Label: 表示推文是否为讽刺的标签
  • 数据分割:
    • 训练集: 70,000条
    • 验证集: 15,000条
    • 测试集: 15,000条

版本信息

  • S3D-v2: 使用弱监督方法,通过多数投票系统对100,000条推文进行讽刺标注,使用的模型包括roberta-large-finetuned-SARC-combined-DS, bertweet-base-finetuned-SARC-DS, 和 bertweet-base-finetuned-SARC-combined-DS。
搜集汇总
数据集介绍
surrey-nlp/S3D-v2 数据集图片
构建方式
在社交媒体文本分析领域,讽刺检测是一项极具挑战性的任务,因其往往依赖于上下文与隐含语义。S3D-v2数据集正是为攻克这一难题而构建,其规模达十万条推文,采用弱监督学习范式进行标注。具体而言,研究团队利用三个经过微调的讽刺检测模型——包括基于RoBERTa与BERTweet架构的变体——通过多数投票系统对原始推文进行自动标注,从而生成银标准标签。这种融合多模型共识的策略有效提升了标注的鲁棒性,最终数据集包含13,016条讽刺推文与86,904条非讽刺推文,为后续模型训练提供了可靠的监督信号。
特点
S3D-v2数据集的核心特点在于其弱监督驱动的规模化标注机制与高质量标签的平衡。相较于传统人工标注的昂贵与低效,该数据集通过集成多个强基准模型的输出,以投票方式自动生成标签,既保证了标注效率,又通过模型多样性降低了单一模型的偏差风险。此外,数据集规模达到十万级别,其中讽刺与非讽刺样本的比例约为1:6.7,这一分布更贴近真实社交媒体场景中的讽刺使用频率,有助于训练模型在长尾分布下的泛化能力。数据集还明确划分为训练集(70,000条)、验证集(15,000条)与测试集(15,000条),便于研究者进行标准化评估。
使用方法
该数据集专为文本分类任务设计,尤其适用于讽刺检测模型的训练与评估。使用者可直接通过Hugging Face Datasets库加载数据集,每条样本包含预处理后的推文文本(Text字段)与二分类标签(Label字段),其中1代表讽刺、0代表非讽刺。在模型开发中,建议以训练集为基础进行微调,利用验证集调整超参数,最终在测试集上报告性能指标,如准确率、F1分数等。鉴于数据来源于社交媒体,使用时需注意文本中的俚语、错别字及隐含文化背景,可结合上下文嵌入或预训练语言模型以捕捉复杂语义模式。
背景与挑战
背景概述
讽刺检测作为自然语言处理领域一项极具挑战性的任务,其核心在于捕捉文本中隐含的讽刺性表达,这种表达往往依赖于语境、语调及社会文化背景的微妙交织。在此背景下,萨里大学的研究人员Jordan Painter与Diptesh Kanojia于2022年在EMNLP会议上发布了S3D-v2数据集,旨在为讽刺检测模型的训练与评估提供大规模、高质量的标注资源。该数据集源自Twitter平台,通过弱监督策略集成多个微调后的讽刺检测模型(包括基于RoBERTa和BERTweet的变体),以多数投票机制生成10万条推文的银标准标签,其中包含13,016条讽刺样本与86,904条非讽刺样本。S3D-v2的发布不仅弥补了现有讽刺数据集规模不足的缺陷,还为弱监督方法在复杂语义任务中的应用提供了实证参考,推动了讽刺检测技术向更鲁棒、更泛化的方向发展。
当前挑战
S3D-v2数据集所面临的挑战首先体现在讽刺检测领域固有的复杂性:讽刺表达常依赖非字面含义、反讽语气及文化特定隐喻,这使得模型难以从纯粹文本特征中准确判别,尤其当语境信息缺失时,误判率显著上升。其次,数据集的构建过程本身也充满技术难题:弱监督策略虽能高效生成大规模标注,但依赖多个预训练模型的投票机制可能引入系统性偏差,例如模型间对特定讽刺模式的一致性偏好或对罕见表达的集体误判。此外,Twitter文本的噪声特性(如拼写错误、缩写及表情符号)增加了预处理与特征提取的难度,而银标准标签相较于人工标注的准确性折衷,也限制了数据集在需要高精度判决场景下的适用性。这些挑战共同指向如何平衡数据规模与标注质量,以及如何设计更鲁棒的弱监督框架以捕捉讽刺的语境敏感性。
常用场景
经典使用场景
在社交媒体文本分析领域,S3D-v2数据集作为一项大规模的弱监督标注资源,为讽刺检测任务提供了坚实的基准。该数据集包含十万条经过预处理的推文,通过多数投票机制融合多个微调模型的预测结果,确保了标注的可靠性。其经典使用场景聚焦于训练和评估文本分类模型,以精准识别推文中蕴含的讽刺性表达,推动自然语言处理技术在细微情感与隐含意图捕捉方面的发展。
解决学术问题
讽刺检测长期以来受限于高质量标注数据的匮乏,尤其是在社交媒体语境下,传统人工标注成本高昂且难以覆盖大规模样本。S3D-v2通过弱监督策略,有效解决了这一学术瓶颈,为研究者提供了兼具规模与标注一致性的数据集。它使得模型能够在复杂语境中学习讽刺的微妙特征,从而提升情感分析、观点挖掘等任务的鲁棒性,为理解非字面意义的语言现象奠定了数据基础。
衍生相关工作
基于S3D-v2数据集,研究者已衍生出一系列经典工作,包括将其作为预训练语料微调RoBERTa、BERTweet等先进模型,验证弱监督信号在讽刺检测中的迁移能力。相关工作还探索了多任务学习框架,将讽刺检测与情感分类、立场检测联合优化,进一步挖掘数据集的潜在价值。这些工作不仅证实了S3D-v2的可靠性,还推动了弱监督学习在细粒度文本分析领域的范式创新。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

