MentalAgora/TherapyTalk
收藏资源简介:
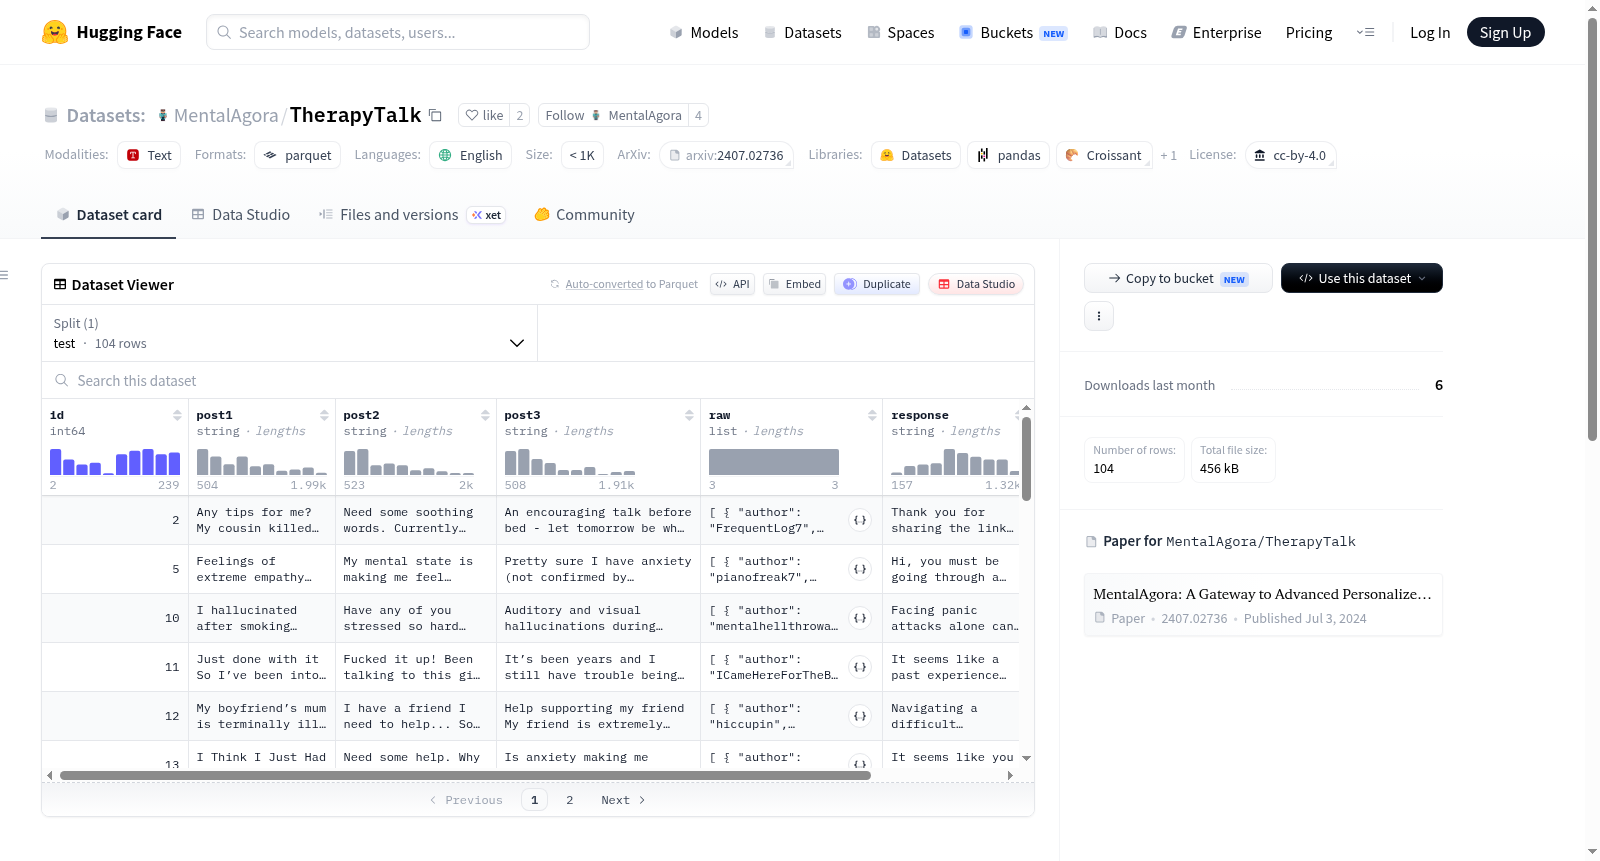
--- dataset_info: features: - name: id dtype: int64 - name: post1 dtype: string - name: post2 dtype: string - name: post3 dtype: string - name: raw list: - name: author dtype: string - name: date dtype: timestamp[s] - name: post dtype: string - name: subreddit dtype: string - name: response dtype: string - name: annotator dtype: string splits: - name: test num_bytes: 703605 num_examples: 104 download_size: 451979 dataset_size: 703605 configs: - config_name: default data_files: - split: test path: data/test-* language: - en size_categories: - n<1K license: cc-by-4.0 --- # TherapyTalk Dataset This dataset was built as part of our study [MentalAgora: A Gateway to Advanced Personalized Care in Mental Health through Multi-Agent Debating and Attribute Control](https://arxiv.org/abs/2407.02736). The dataset was sourced from mental health-related posts in [Reddit Mental Health Dataset](https://zenodo.org/records/3941387) and tagged with responses from mental health professionals to selected posts. For more details on building the dataset, please see the paper. ## License For posts included in this dataset, please follow the license stated in the source, Reddit Mental Health Dataset. The responses included in this dataset are licensed under CC-BY 4.0. ## Citation ```bibtex @misc{lee2024mentalagoragatewayadvancedpersonalized, title={MentalAgora: A Gateway to Advanced Personalized Care in Mental Health through Multi-Agent Debating and Attribute Control}, author={Yeonji Lee and Sangjun Park and Kyunghyun Cho and JinYeong Bak}, year={2024}, eprint={2407.02736}, archivePrefix={arXiv}, primaryClass={cs.CL}, url={https://arxiv.org/abs/2407.02736}, } ```
--- dataset_info: 数据集信息: 特征字段: - 名称:id,数据类型:int64 - 名称:帖子1(post1),数据类型:字符串(string) - 名称:帖子2(post2),数据类型:字符串(string) - 名称:帖子3(post3),数据类型:字符串(string) - 名称:原始数据(raw),数据类型:列表,其内部字段包括: - 名称:作者(author),数据类型:字符串(string) - 名称:日期(date),数据类型:秒级时间戳(timestamp[s]) - 名称:帖子内容(post),数据类型:字符串(string) - 名称:子版块(subreddit),数据类型:字符串(string) - 名称:回复(response),数据类型:字符串(string) - 名称:标注者(annotator),数据类型:字符串(string) 划分集: - 名称:测试集(test),字节数:703605,示例数量:104 下载大小:451979,数据集总大小:703605 配置项: - 配置名称:默认(default),数据文件: - 划分集:测试集(test),路径:data/test-* 语言: - 英语(en) 规模分类: - 样本数少于1000(n<1K) 许可证:CC-BY 4.0 --- # TherapyTalk 数据集 本数据集系本团队研究《MentalAgora:依托多智能体辩论与属性控制实现心理健康领域高级个性化护理的门户》(https://arxiv.org/abs/2407.02736)的配套成果。 本数据集源自[Reddit心理健康数据集(Reddit Mental Health Dataset)](https://zenodo.org/records/3941387)中的心理健康相关帖子,并针对筛选出的帖子标注了心理健康专业人士的回复。有关本数据集的构建细节,请参阅对应研究论文。 ## 许可证 对于本数据集收录的帖子,请遵循其来源数据集Reddit心理健康数据集所规定的许可证条款。本数据集收录的回复采用CC-BY 4.0许可证进行授权。 ## 引用 bibtex @misc{lee2024mentalagoragatewayadvancedpersonalized, title={MentalAgora: A Gateway to Advanced Personalized Care in Mental Health through Multi-Agent Debating and Attribute Control}, author={Yeonji Lee and Sangjun Park and Kyunghyun Cho and JinYeong Bak}, year={2024}, eprint={2407.02736}, archivePrefix={arXiv}, primaryClass={cs.CL}, url={https://arxiv.org/abs/2407.02736}, }