
遇见数据集

eval-laion_seqnorm-tis-shaped-40-8B_DCAgent2_terminal_bench_2-traces

收藏
Hugging Face2026-06-17 更新2026-06-18 收录
官方服务:

资源简介:

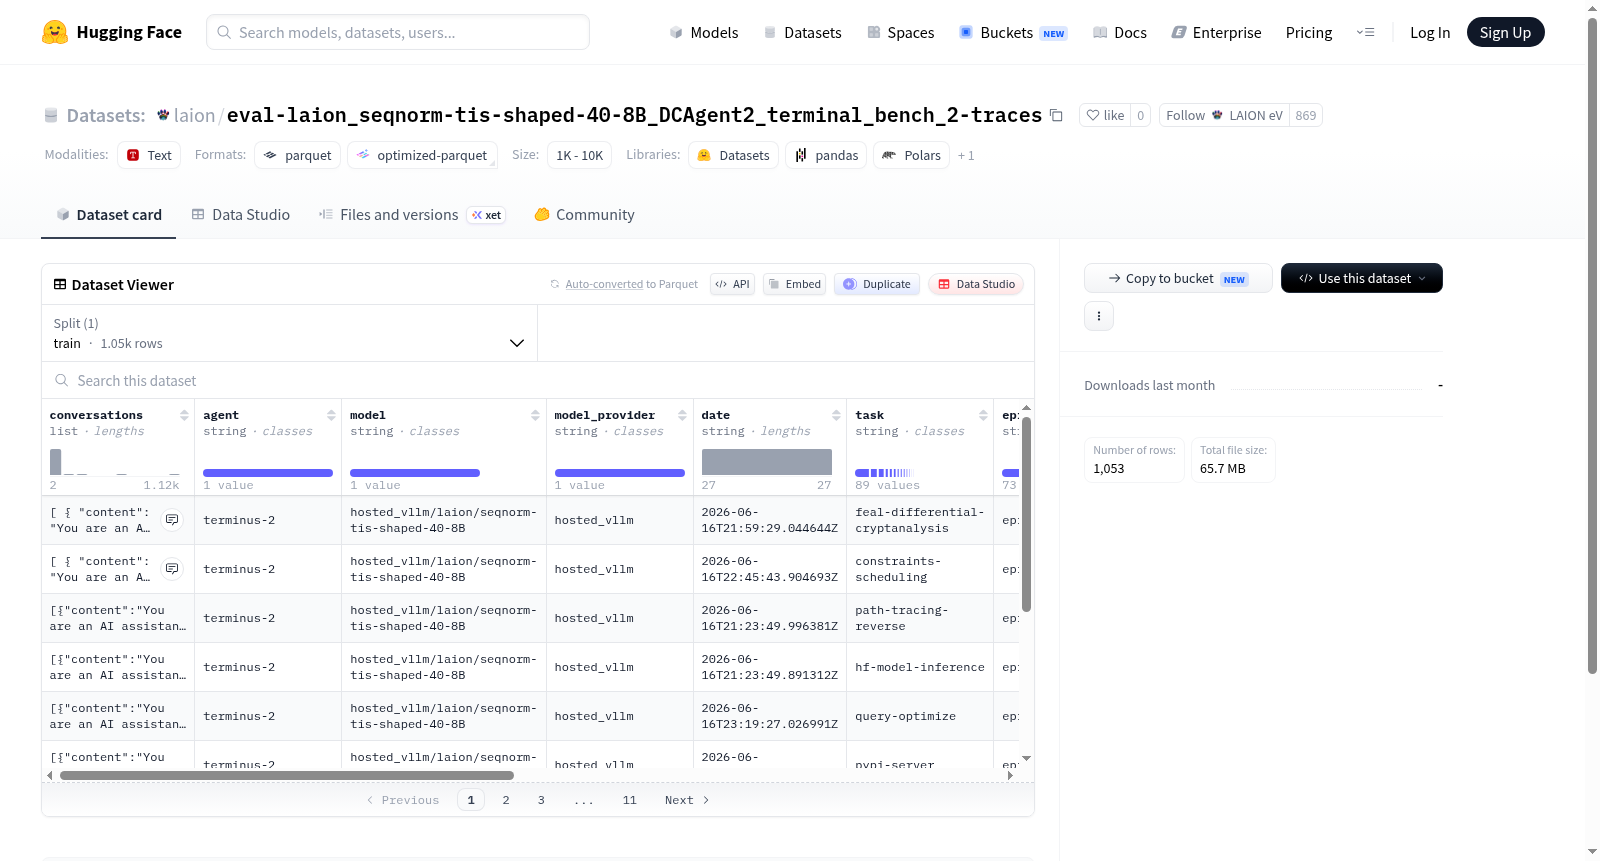
该数据集包含1053个对话交互样本,主要用于任务导向的对话系统评估或智能代理测试。每个样本记录完整的对话过程(conversations字段,包含content和role),并附带丰富的元数据:包括使用的代理类型(agent)、模型名称(model)及提供商(model_provider)、任务类型(task)、交互轮次(episode)、运行标识(run_id)、试验名称(trial_name)、任务结果(result)、验证器输出(verifier_output)以及数据来源追踪(trace_source)。数据还包含时间戳(date)信息。数据集结构表明其适用于分析多轮对话性能、评估不同模型/代理在特定任务上的表现,以及研究对话系统的可追溯性。

This dataset contains 1053 dialogue interaction samples, primarily used for task-oriented dialogue system evaluation or intelligent agent testing. Each sample records the complete dialogue process (conversations field, including content and role) and is accompanied by rich metadata: including the agent type used (agent), model name (model) and provider (model_provider), task type (task), interaction rounds (episode), run identifier (run_id), trial name (trial_name), task result (result), verifier output (verifier_output), and data source tracking (trace_source). The data also includes timestamp (date) information. The dataset structure indicates its suitability for analyzing multi-turn dialogue performance, evaluating the performance of different models/agents on specific tasks, and studying the traceability of dialogue systems.

提供机构:
LAION eV
创建时间:
2026-06-17
原始信息汇总
  • 名称: eval-laion_seqnorm-tis-shaped-40-8B_DCAgent2_terminal_bench_2-traces
  • 地址: https://huggingface.co/datasets/laion/eval-laion_seqnorm-tis-shaped-40-8B_DCAgent2_terminal_bench_2-traces
  • 数据类型: 包含对话、代理、模型、日期、任务、回合、运行ID、试验名称、结果、验证器输出和轨迹来源等字段。
  • 特征:
    • conversations: 由多个消息构成的列表,每个消息包含 content(文本内容)和 role(角色)字段。
    • agent: 字符串,记录代理名称。
    • model: 字符串,记录模型名称。
    • model_provider: 字符串,记录模型提供者。
    • date: 字符串,记录日期。
    • task: 字符串,记录任务名称。
    • episode: 字符串,记录回合信息。
    • run_id: 字符串,记录运行标识。
    • trial_name: 字符串,记录试验名称。
    • result: 字符串,记录结果。
    • verifier_output: 字符串,记录验证器输出。
    • trace_source: 字符串,记录轨迹来源。
  • 数据划分:
    • 训练集(train):包含 1053 条样本,占用 81,801,268 字节。
  • 下载大小: 65,669,642 字节
  • 数据集总大小: 81,801,268 字节
  • 配置文件: 默认配置(default),数据文件路径为 data/train-*。
搜集汇总
数据集介绍
eval-laion_seqnorm-tis-shaped-40-8B_DCAgent2_terminal_bench_2-traces 数据集图片
构建方式
该数据集基于LAION序列标准化与TIS(任务指令筛选)流程构建,聚焦于终端智能体交互场景。通过从DCAgent2任务基准中采集1053条完整轨迹,每条轨迹包含多轮对话、智能体标识、模型来源、执行时间戳及验证器输出等结构化字段。数据构建采用任务导向的轨迹切片技术,将智能体在终端环境中的交互历史按episode和run_id进行组织,并通过verifier_output字段记录任务完成度的自动化评估结果,从而形成可复现的智能体行为分析基准。
特点
数据集具备多维标注特性,涵盖agent、model及task等元数据标签,便于细粒度分析不同模型在终端任务中的表现差异。每个样本包含完整对话链,保留用户与智能体的多轮交互上下文,同时记录trace_source字段以溯源数据生成管道。结果字段与验证器输出的并存设计,既提供任务成功率的硬性指标,又保留自动化验证的中间过程,支持从执行效率到策略合理性的全方位评估。
使用方法
适用于训练或评估终端任务驱动的对话智能体,可直接加载为HuggingFace Dataset对象使用。通过conversations字段提取多轮交互序列,结合result与verifier_output字段作为监督信号,可构建基于轨迹模仿学习的训练管线。模型开发者可利用agent和model字段筛选特定智能体的行为数据,或通过task字段按任务类型进行分层采样,支持对比分析和跨模型泛化能力测试。
背景与挑战
背景概述
该数据集由LAION团队与DCAgent项目合作创建,发布于2024年,旨在评估和优化基于大型语言模型(LLM)的智能体在终端环境中的行为轨迹。核心研究问题聚焦于如何通过序列归一化技术提升LLM智能体在复杂命令行交互任务中的表现。数据集包含1053条交互轨迹,每条轨迹记录了智能体(如GPT-4、Claude等)在特定任务中的对话、行动结果及验证器输出。作为终端智能体评估基准,它为研究LLM在真实操作环境中的推理、决策与容错能力提供了标准化测试床,推动了自主计算机操作领域的发展。
当前挑战
该数据集面临多重挑战:首先,领域问题方面,如何确保LLM智能体在终端环境中执行任务(如文件操作、系统配置)时的准确性与鲁棒性,克服命令执行错误、路径歧义及权限不足等常见故障。其次,构建过程中需处理轨迹数据的异构性,包括不同模型生成的多类型输出格式、动作日志的时序对齐以及验证器对结果的主观评判差异。此外,数据规模有限(仅1053条),难以覆盖全部终端用例,且真实环境中的错误回滚与探索性行为难以被标准化捕捉,限制了模型的泛化能力。
常用场景
经典使用场景
eval-laion_seqnorm-tis-shaped-40-8B_DCAgent2_terminal_bench_2-traces 数据集源自大规模语言模型在终端交互环境中的行为轨迹记录。其经典使用场景集中于多轮对话智能体的行为分析与优化,通过捕捉智能体在完成终端任务时的完整交互序列,研究者可深入剖析模型在复杂指令遵循、错误恢复与多步推理中的表现。该数据集以结构化对话记录为核心,涵盖任务描述、模型响应及验证结果,为评估和训练具备终端操作能力的对话智能体提供了标准化基准。
实际应用
在产业实践中,该数据集主要服务于自动化运维助手、软件开发工具及命令行接口的智能代理系统开发。基于这些终端交互轨迹,企业可训练模型实现自动化的服务器配置、日志分析与错误修复,显著提升IT运维效率。同时,该数据集也为智能客服系统在复杂技术场景下的多轮对话优化提供了真实数据支撑,助力实现从简单问答到任务导向型自主操作的能力跃迁。
衍生相关工作
基于该数据集衍生的经典工作包括终端智能体的行为克隆与强化学习微调方法,以及针对长序列任务中记忆衰减问题的改进算法。研究者利用其轨迹结构开发了任务层级奖励塑形技术和多步推理链的显式学习框架。此外,该数据集还催生了基于验证器反馈的自我对弈训练范式,使智能体能够在模拟环境中通过试错积累经验,显著提升了零样本场景下的任务完成成功率。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

