huggingartists/katy-perry
收藏资源简介:
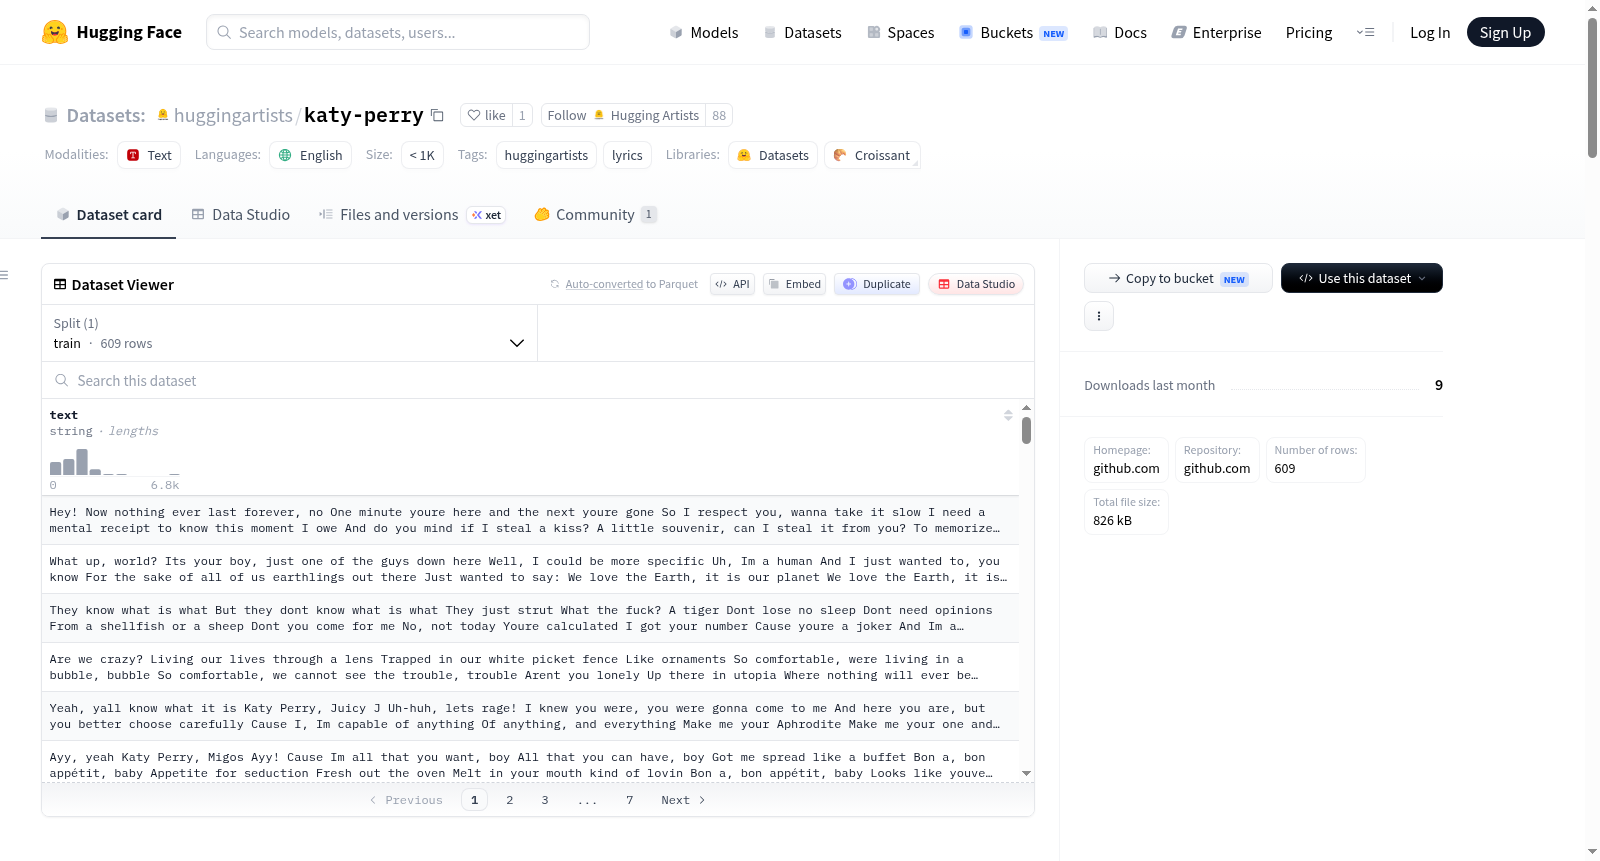
该数据集名为huggingartists/katy-perry,是一个从Genius解析的歌词数据集,专为使用HuggingArtists模型生成歌词而设计。数据集内容为英文,包含一个名为text的字符串特征。数据集结构包括一个名为train的分割,包含609个条目。数据集的创建者是Aleksey Korshuk,提供了许可证和引用信息,但关于数据集的精选理由、源数据、注释和个人敏感信息等方面的详细信息尚未提供。
This dataset is named huggingartists/katy-perry. It is a lyrics dataset parsed from Genius, specifically developed for lyric generation using the HuggingArtists model. All content in this dataset is in English, and it includes a string feature named "text". The dataset structure includes a training split named "train" that contains 609 entries. The dataset was created by Aleksey Korshuk, and license and citation information are provided. However, detailed information such as the dataset's selection rationale, source data, annotations, and personal sensitive information has not been provided.
数据集概述
数据集名称
- 名称: huggingartists/katy-perry
数据集描述
- 描述: 该数据集包含从Genius解析的歌词数据,旨在用于HuggingArtists模型生成歌词。
支持的任务和排行榜
- 任务: 信息待补充
语言
- 语言: en
数据集使用
- 加载方式: python from datasets import load_dataset dataset = load_dataset("huggingartists/katy-perry")
数据集结构
数据字段
- 字段:
text(字符串类型)
数据分割
- 分割情况:
train validation test 609 - -
数据分割示例
-
分割代码: python from datasets import load_dataset, Dataset, DatasetDict import numpy as np
datasets = load_dataset("huggingartists/katy-perry")
train_percentage = 0.9 validation_percentage = 0.07 test_percentage = 0.03
train, validation, test = np.split(datasets[train][text], [int(len(datasets[train][text])train_percentage), int(len(datasets[train][text])(train_percentage + validation_percentage))])
datasets = DatasetDict( { train: Dataset.from_dict({text: list(train)}), validation: Dataset.from_dict({text: list(validation)}), test: Dataset.from_dict({text: list(test)}) } )
数据集创建
数据集来源
- 来源: 信息待补充
注释信息
- 注释过程: 信息待补充
个人和敏感信息
- 处理情况: 信息待补充
数据集使用考虑
社会影响
- 影响: 信息待补充
偏见讨论
- 偏见: 信息待补充
其他已知限制
- 限制: 信息待补充
附加信息
数据集管理者
- 管理者: 信息待补充
许可信息
- 许可: 信息待补充
引用信息
-
引用:
@InProceedings{huggingartists, author={Aleksey Korshuk} year=2021 }