
disi-unibo-nlp/SciLay
收藏官方服务:
资源简介:
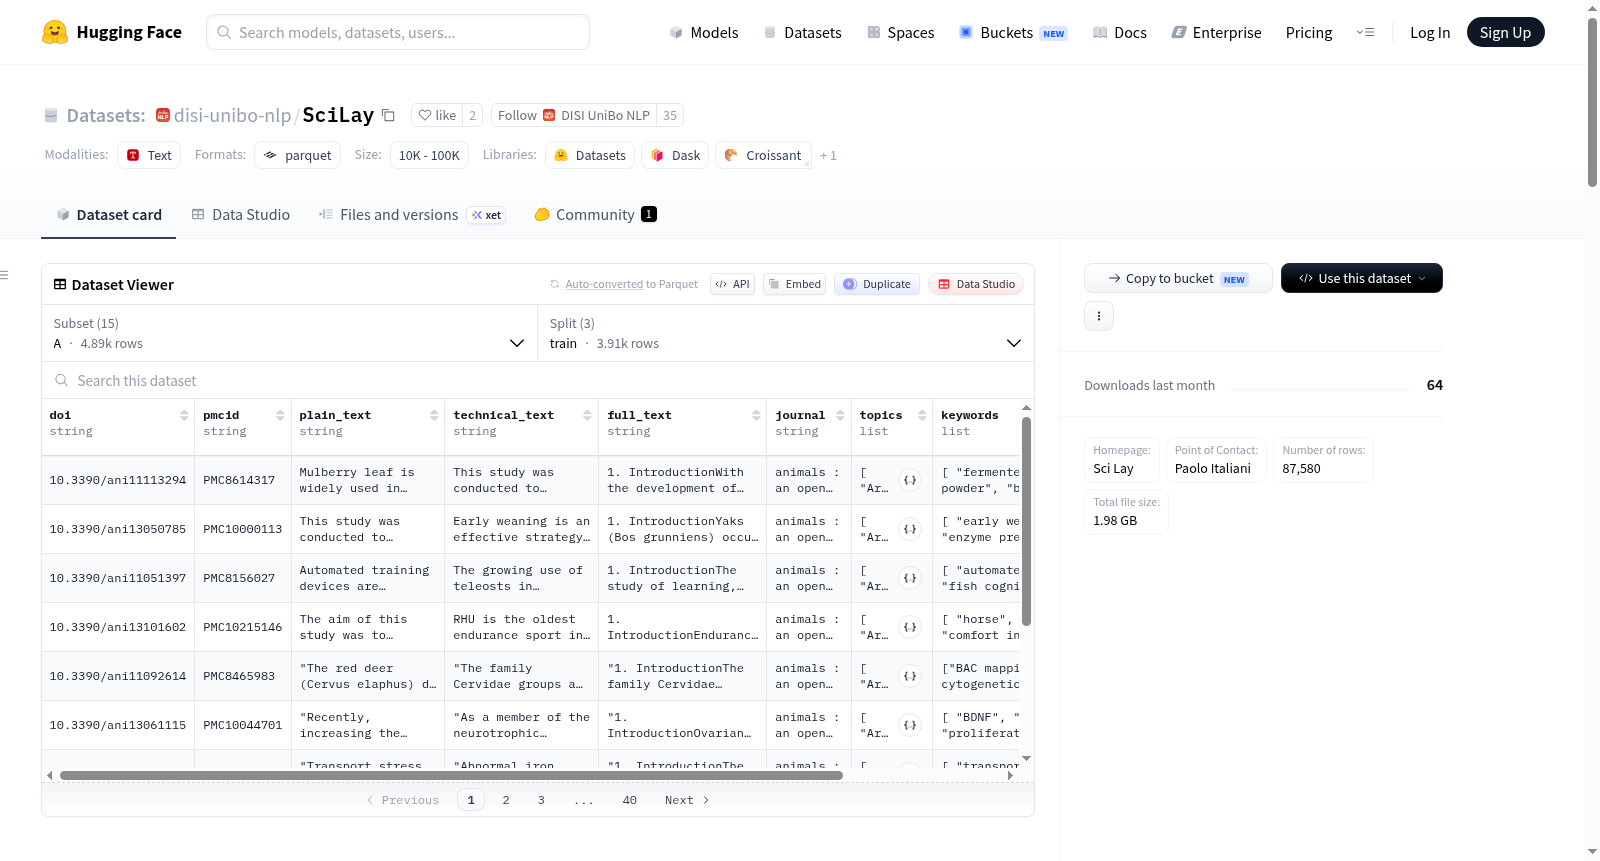
SciLay数据集包含43,790个实例,每个实例代表生物医学领域的一篇科学文章。每个实例包括简化的plain_text、技术性的technical_text和完整的full_text,以及相关的元数据如DOI、PMCID、期刊、主题和关键词。数据集旨在支持开发能够有效简化复杂科学语言同时保留关键信息的文本摘要模型。数据集涵盖了15种不同的期刊来源,如Nature Communications、Animals等,并提供了不同配置的数据分割。
SciLay数据集包含43,790个实例,每个实例代表生物医学领域的一篇科学文章。每个实例包括简化的plain_text、技术性的technical_text和完整的full_text,以及相关的元数据如DOI、PMCID、期刊、主题和关键词。数据集旨在支持开发能够有效简化复杂科学语言同时保留关键信息的文本摘要模型。数据集涵盖了15种不同的期刊来源,如Nature Communications、Animals等,并提供了不同配置的数据分割。
提供机构:
disi-unibo-nlp原始信息汇总
数据集概述
数据集配置
-
配置A
- 特征:
- doi: 字符串
- pmcid: 字符串
- plain_text: 字符串
- technical_text: 字符串
- full_text: 字符串
- journal: 字符串
- topics: 字符串序列
- keywords: 字符串序列
- 数据分割:
- 训练: 3909个样本, 128936951字节
- 验证: 489个样本, 15912431字节
- 测试: 489个样本, 16235251字节
- 下载大小: 83830061字节
- 数据集大小: 161084633字节
- 特征:
-
配置B
- 特征: 同配置A
- 数据分割:
- 训练: 1617个样本, 57956055字节
- 验证: 202个样本, 6860452字节
- 测试: 203个样本, 7422716字节
- 下载大小: 37654668字节
- 数据集大小: 72239223字节
-
配置C
- 特征: 同配置A
- 数据分割:
- 训练: 6782个样本, 242721690字节
- 验证: 848个样本, 30735056字节
- 测试: 848个样本, 31018214字节
- 下载大小: 158704561字节
- 数据集大小: 304474960字节
-
配置CB
- 特征: 同配置A
- 数据分割:
- 训练: 867个样本, 43533134字节
- 验证: 108个样本, 5664682字节
- 测试: 109个样本, 5455500字节
- 下载大小: 27189215字节
- 数据集大小: 54653316字节
-
配置I
- 特征: 同配置A
- 数据分割:
- 训练: 1181个样本, 37682107字节
- 验证: 148个样本, 4967810字节
- 测试: 148个样本, 4945533字节
- 下载大小: 24754627字节
- 数据集大小: 47595450字节
-
配置MBIO
- 特征: 同配置A
- 数据分割:
- 训练: 607个样本, 30528726字节
- 验证: 76个样本, 3905117字节
- 测试: 76个样本, 3830514字节
- 下载大小: 18844836字节
- 数据集大小: 38264357字节
-
配置NC
- 特征: 同配置A
- 数据分割:
- 训练: 5549个样本, 286453072字节
- 验证: 694个样本, 35652636字节
- 测试: 694个样本, 35869803字节
- 下载大小: 174664205字节
- 数据集大小: 357975511字节
-
配置OTHER
- 特征: 同配置A
- 数据分割:
- 训练: 2008个样本, 89884204字节
- 验证: 251个样本, 11198113字节
- 测试: 251个样本, 11665218字节
- 下载大小: 56488155字节
- 数据集大小: 112747535字节
-
配置PLB
- 特征: 同配置A
- 数据分割:
- 训练: 896个样本, 54106804字节
- 验证: 112个样本, 6575630字节
- 测试: 113个样本, 6563666字节
- 下载大小: 33228217字节
- 数据集大小: 67246100字节
-
配置PLCB
- 特征: 同配置A
- 数据分割:
- 训练: 2589个样本, 149165851字节
- 验证: 324个样本, 18844485字节
- 测试: 324个样本, 18926571字节
- 下载大小: 90880208字节
- 数据集大小: 186936907字节
-
配置PLGEN
- 特征: 同配置A
- 数据分割:
- 训练: 3087个样本, 176933946字节
- 验证: 386个样本, 21857559字节
- 测试: 386个样本, 21226953字节
- 下载大小: 108531011字节
- 数据集大小: 220018458字节
-
配置PLNTD
- 特征: 同配置A
- 数据分割:
- 训练: 2289个样本, 90159685字节
- 验证: 286个样本, 11227802字节
- 测试: 287个样本, 11587156字节
- 下载大小: 57806998字节
- 数据集大小: 112974643字节
-
配置PLPAT
- 特征: 同配置A
- 数据分割:
- 训练: 2920个样本, 167781149字节
- 验证: 365个样本, 20760947字节
- 测试: 365个样本, 21113922字节
- 下载大小: 102858284字节
- 数据集大小: 209656018字节
-
配置SD
- 特征: 同配置A
- 数据分割:
- 训练: 725个样本, 23671697字节
- 验证: 91个样本, 3033467字节
- 测试: 91个样本, 2972947字节
- 下载大小: 15082066字节
- 数据集大小: 29678111字节
-
配置all
- 特征: 同配置A
- 数据分割:
- 训练: 35026个样本, 1579515071字节
- 验证: 4380个样本, 197196187字节
- 测试: 4384个样本, 198833964字节
- 下载大小: 990169794字节
- 数据集大小: 1975545222字节
数据集特征
- doi: 字符串,数字对象标识符,非所有实例都有。
- pmcid: 字符串,PubMed Central标识符,非所有实例都有。
- plain_text: 字符串,文章的简明英语摘要。
- technical_text: 字符串,文章的摘要。
- full_text: 字符串,完整的文章文本。
- journal: 字符串,发表文章的期刊名称。
- topics: 字符串序列,文章分类的类型,非所有实例都有。
- keywords: 字符串序列,文章的关键词,非所有实例都有。
数据分割
| 配置 | 训练样本 | 验证样本 | 测试样本 |
|---|---|---|---|
| all | 35026 | 4380 | 4384 |
| NC | 5549 | 694 | 694 |
| A | 3909 | 489 | 489 |
| PLGEN | 3087 | 386 | 386 |
| PLPAT | 2920 | 365 | 365 |
| PLCB | 2589 | 324 | 324 |
| PLNTD | 2289 | 286 | 287 |
| B | 1617 | 202 | 203 |
| I | 1181 | 148 | 148 |
| PLB | 896 | 112 | 113 |
| CB | 867 | 108 | 109 |
| SD | 725 | 91 | 91 |
| MBIO | 607 | 76 | 76 |
| C | 6782 | 848 | 848 |
| OTHER | 2008 | 251 | 251 |
以上信息概述了SciLay数据集的配置、特征和数据分割情况。
搜集汇总
数据集介绍
构建方式
SciLay数据集面向生物医学领域的科学文献,通过从PubMed Central等开放获取资源库中抓取XML与HTML格式的文章,系统性地提取并构建而成。每个数据实例均包含三个核心文本层次:面向大众的简明语言摘要(plain_text)、体现专业深度的技术性摘要(technical_text)以及完整的全文内容(full_text)。此外,数据集还收录了每篇文章的数字对象标识符(DOI)、PubMed Central标识符(PMCID)、发表期刊、主题分类及关键词等元数据。样本来源涵盖Nature Communications、PLOS系列期刊等15个出版源,按期刊名称划分为不同配置(config),并整合为统一的'all'配置,总计包含43,790条实例。
使用方法
使用Hugging Face的datasets库可便捷加载SciLay数据集。默认配置为'all',将加载全部15个期刊来源的合并数据。研究者亦可指定单一期刊配置,例如load_dataset('disi-unibo-nlp/SciLay', 'NC')仅加载Nature Communications的文章。更灵活的用法是通过journals参数选择多个期刊,如load_dataset('disi-unibo-nlp/SciLay', journals=['NC', 'A'])。数据集已按8:1:1的比例划分为训练集、验证集和测试集,便于直接用于模型训练与评估。典型的应用场景包括训练从technical_text或full_text生成plain_text的文本简化模型,或利用三层文本结构进行跨风格文本对齐研究。
背景与挑战
背景概述
在科学传播与自然语言处理交叉领域,如何弥合专业学术语言与公众认知之间的鸿沟,已成为亟待攻克的关键课题。由意大利博洛尼亚大学计算机科学与工程系(DISI)的Paolo Italiani等人于近期构建的SciLay数据集,正是针对这一核心研究问题而生。该数据集汇聚了43,790篇生物医学领域的科研论文,每篇均包含专业摘要、完整正文以及对应的通俗语言摘要,并附有期刊来源、关键词与唯一标识符等元数据。其问世为文本简化与科学摘要生成任务提供了规模化的标准基准,有力推动了将复杂科学知识转化为可被广泛理解内容的研究进程。
当前挑战
SciLay数据集所面临的挑战首先体现在领域问题的复杂性上:生物医学文本充斥着高度专业化的术语、复杂的逻辑推理与密集的信息结构,模型需在保留关键科学事实的前提下,实现语义层面的深度简化,这对抽象式摘要生成技术提出了严苛要求。在数据集构建过程中,挑战则集中于多源异构数据的规模化采集与清洗,需从PubMed Central等海量文献库中精准提取并对齐摘要、全文与通俗摘要三要素,同时确保跨14个不同期刊来源(如Nature Communications、PLOS系列)的数据格式与质量的一致性。此外,通俗摘要与专业文本之间的语义映射关系存在显著的非对称性,为监督学习范式下的自动评估与对齐带来了额外困难。
常用场景
经典使用场景
在自然语言处理与科学传播交叉领域中,SciLay数据集被广泛用于训练和评估面向生物医学文献的文本简化与摘要生成模型。其核心设计在于提供同一篇论文的三种文本形态:面向公众的通俗语言摘要、面向同行的专业学术摘要以及完整全文。研究者通常利用该数据集构建序列到序列模型,学习从技术性文本到通俗化表述的映射关系,从而推动自动化科学传播技术的发展。此外,该数据集按期刊来源划分为多个子集,使得领域自适应与跨期刊泛化能力的研究成为可能,为文本简化任务的标准化评测提供了坚实的数据基础。
解决学术问题
SciLay数据集旨在破解生物医学领域学术文本可读性鸿沟这一长期困扰科学传播的难题。传统上,专业论文的抽象语言与术语壁垒阻碍了公众、政策制定者乃至跨学科研究者对前沿成果的理解。该数据集通过提供平行对照的通俗摘要与专业摘要,使得研究者能够系统性地探索如何将高密度的技术语言转化为易于理解的表达。这一资源直接推动了文本简化、抽象式摘要、可控文本生成等方向的研究进展,为量化评估简化质量、保留关键信息、维持科学准确性等核心学术问题提供了标准化的评测基准,显著促进了科学信息无障碍传播的理论与实践发展。
实际应用
在实际应用中,SciLay数据集赋能了多种面向公众的科学传播工具与服务平台。基于该数据集训练的模型可被集成到学术搜索引擎、科学新闻聚合平台或开放获取知识库中,自动为每篇科研论文生成通俗易懂的概要,帮助非专业读者快速把握研究要点。医疗机构与公共健康部门亦可利用此类技术,将复杂的医学研究发现转化为患者教育材料或公共卫生指南。此外,科学资助机构与科普媒体能够借助自动摘要工具,高效筛选并解读前沿成果,从而加速科学知识从实验室走向社会应用的转化过程,提升全民科学素养。
数据集最近研究
最新研究方向
在生物医学文本挖掘的前沿领域,SciLay数据集的问世为科学文献的自动简化与可读性增强开辟了全新路径。该数据集聚焦于将复杂的科研论文转化为通俗易懂的平实语言摘要,这一研究方向与当前公众科学素养提升及开放科学运动的热潮紧密相连。随着科研成果的爆炸式增长,如何弥合专家与非专业读者之间的信息鸿沟成为关键议题。SciLay通过提供涵盖15种顶级期刊、包含技术性摘要与平实语言对照的大规模语料,为训练能够精准保留核心信息并降低语言壁垒的文本简化模型奠定了坚实基础。其多期刊、多主题的精细划分不仅促进了跨领域通用简化模型的研发,还推动了针对特定生物学子领域的专业化模型探索,对加速科学知识传播、促进跨学科协作及提升公众对生物医学研究的理解具有深远意义。
以上内容由遇见数据集搜集并总结生成


