energy-eval-filtered_responses_multichoice_cemig-rl-releases_energy-gp_459ced03_v3
收藏资源简介:
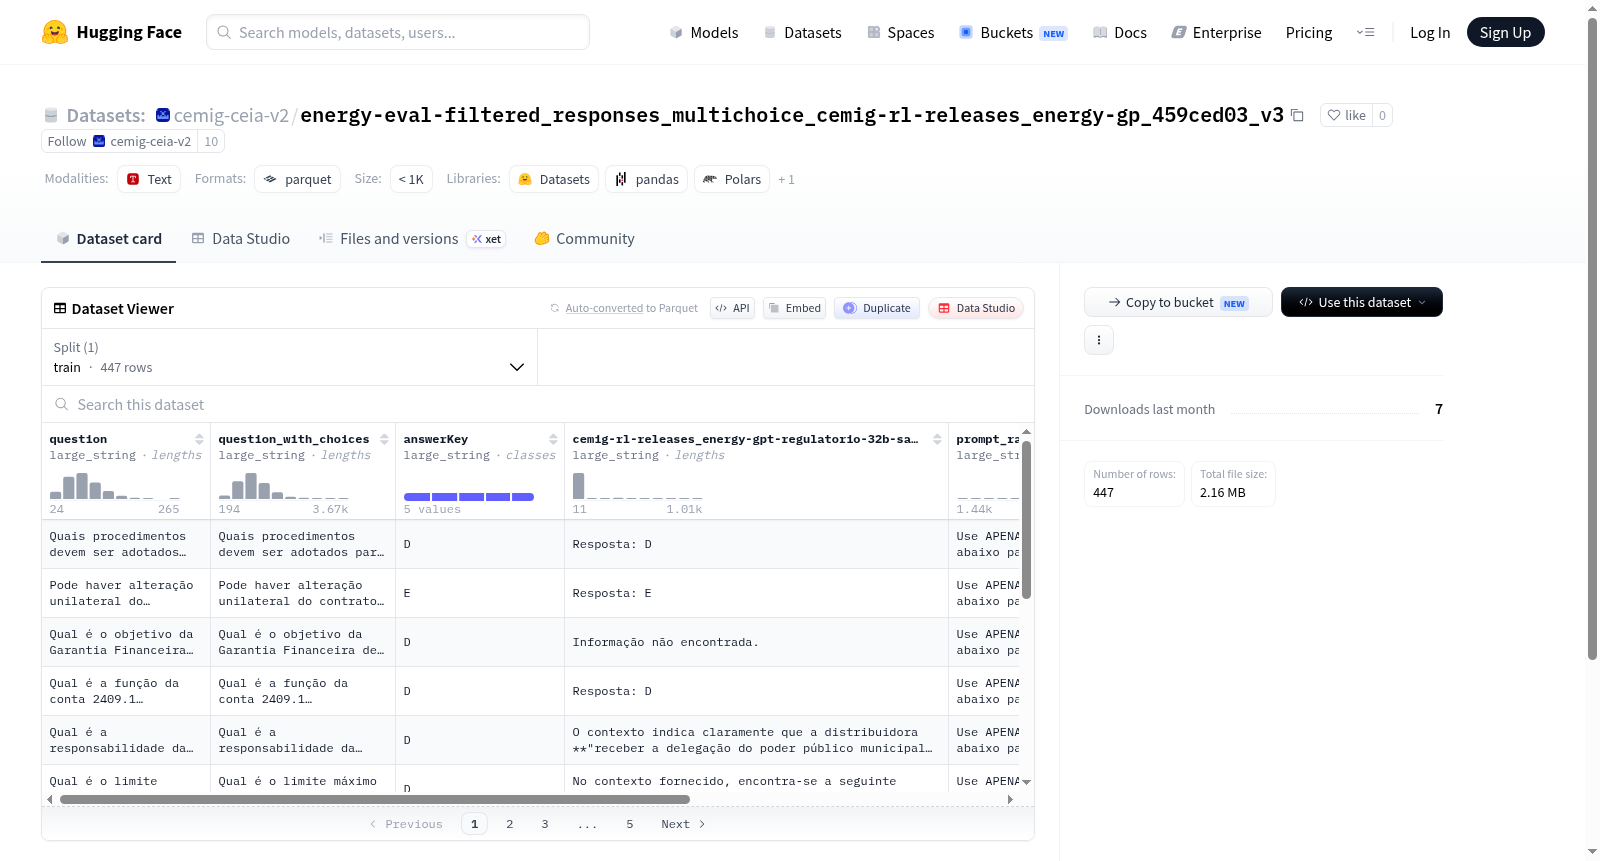
该数据集是一个结构化问答数据集,专为检索增强生成(RAG)系统设计,包含447个训练样本。数据集中包含6个主要字段:问题原文(question)、带选项的问题(question_with_choices)、答案键(answerKey)、基于特定RAG系统的生成答案(cemig-rl-releases_energy-gpt-regulatorio-32b-safe-v2_RAG-TRUE_ENC-cemig-nlp-releases_multilingual-e5-large-ft-v2_RR-cemig-nlp-releases_bge-reranker-v2-m3-ft-v2)、RAG提示词(prompt_rag)以及RAG上下文(cemig-rl-releases_energy-gpt-regulatorio-32b-safe-v2_RAG-TRUE_ENC-cemig-nlp-releases_multilingual-e5-large-ft-v2_RR-cemig-nlp-releases_bge-reranker-v2-m3-ft-v2_context)。从字段命名和结构推断,该数据集可能用于评估或训练问答模型,特别是涉及多语言嵌入(如multilingual-e5-large-ft-v2)和重排序模型(如bge-reranker-v2-m3-ft-v2)的RAG流水线。数据集仅提供训练分割,总大小约5.8MB。
This dataset is a structured question-answering dataset designed for Retrieval-Augmented Generation (RAG) systems, containing 447 training samples. It includes six main fields: original question (question), question with options (question_with_choices), answer key (answerKey), generated answer based on a specific RAG system (cemig-rl-releases_energy-gpt-regulatorio-32b-safe-v2_RAG-TRUE_ENC-cemig-nlp-releases_multilingual-e5-large-ft-v2_RR-cemig-nlp-releases_bge-reranker-v2-m3-ft-v2), RAG prompt (prompt_rag), and RAG context (cemig-rl-releases_energy-gpt-regulatorio-32b-safe-v2_RAG-TRUE_ENC-cemig-nlp-releases_multilingual-e5-large-ft-v2_RR-cemig-nlp-releases_bge-reranker-v2-m3-ft-v2_context). Based on the field naming and structure, the dataset is likely intended for evaluating or training question-answering models, particularly in RAG pipelines involving multilingual embeddings (e.g., multilingual-e5-large-ft-v2) and reranking models (e.g., bge-reranker-v2-m3-ft-v2). The dataset only provides a training split, with a total size of approximately 5.8MB.
数据集概述:energy-eval-filtered_responses_multichoice_cemig-rl-releases_energy-gp_459ced03_v3
基本信息
- 数据集名称: energy-eval-filtered_responses_multichoice_cemig-rl-releases_energy-gp_459ced03_v3
- 数据集地址: https://huggingface.co/datasets/cemig-ceia-v2/energy-eval-filtered_responses_multichoice_cemig-rl-releases_energy-gp_459ced03_v3
数据特征
该数据集包含以下列:
- question: 问题文本(大字符串类型)
- question_with_choices: 带有选项的问题文本(大字符串类型)
- answerKey: 答案键(大字符串类型)
- cemig-rl-releases_energy-gpt-regulatorio-32b-safe-v2_RAG-TRUE_ENC-cemig-nlp-releases_multilingual-e5-large-ft-v2_RR-cemig-nlp-releases_bge-reranker-v2-m3-ft-v2: 模型输出(大字符串类型)
- prompt_rag: RAG提示(大字符串类型)
- cemig-rl-releases_energy-gpt-regulatorio-32b-safe-v2_RAG-TRUE_ENC-cemig-nlp-releases_multilingual-e5-large-ft-v2_RR-cemig-nlp-releases_bge-reranker-v2-m3-ft-v2_context: 模型输出使用的上下文(大字符串类型)
数据集划分
- 训练集 (train):
- 样本数量: 447
- 数据大小: 5,844,757 字节
文件配置
- 配置名称: default
- 数据文件路径: data/train-*
- 下载大小: 2,152,535 字节
数据用途
该数据集主要用于评估多选问答场景下的模型性能,特别是使用RAG(检索增强生成)方法,结合特定嵌入模型(multilingual-e5-large-ft-v2)和重排序模型(bge-reranker-v2-m3-ft-v2)的能源领域GPT(energy-gpt-regulatorio-32b-safe-v2)模型。