
遇见数据集

agentlans/rombodawg-Everything_Instruct

收藏
Hugging Face2025-12-16 更新2025-12-20 收录
官方服务:

资源简介:

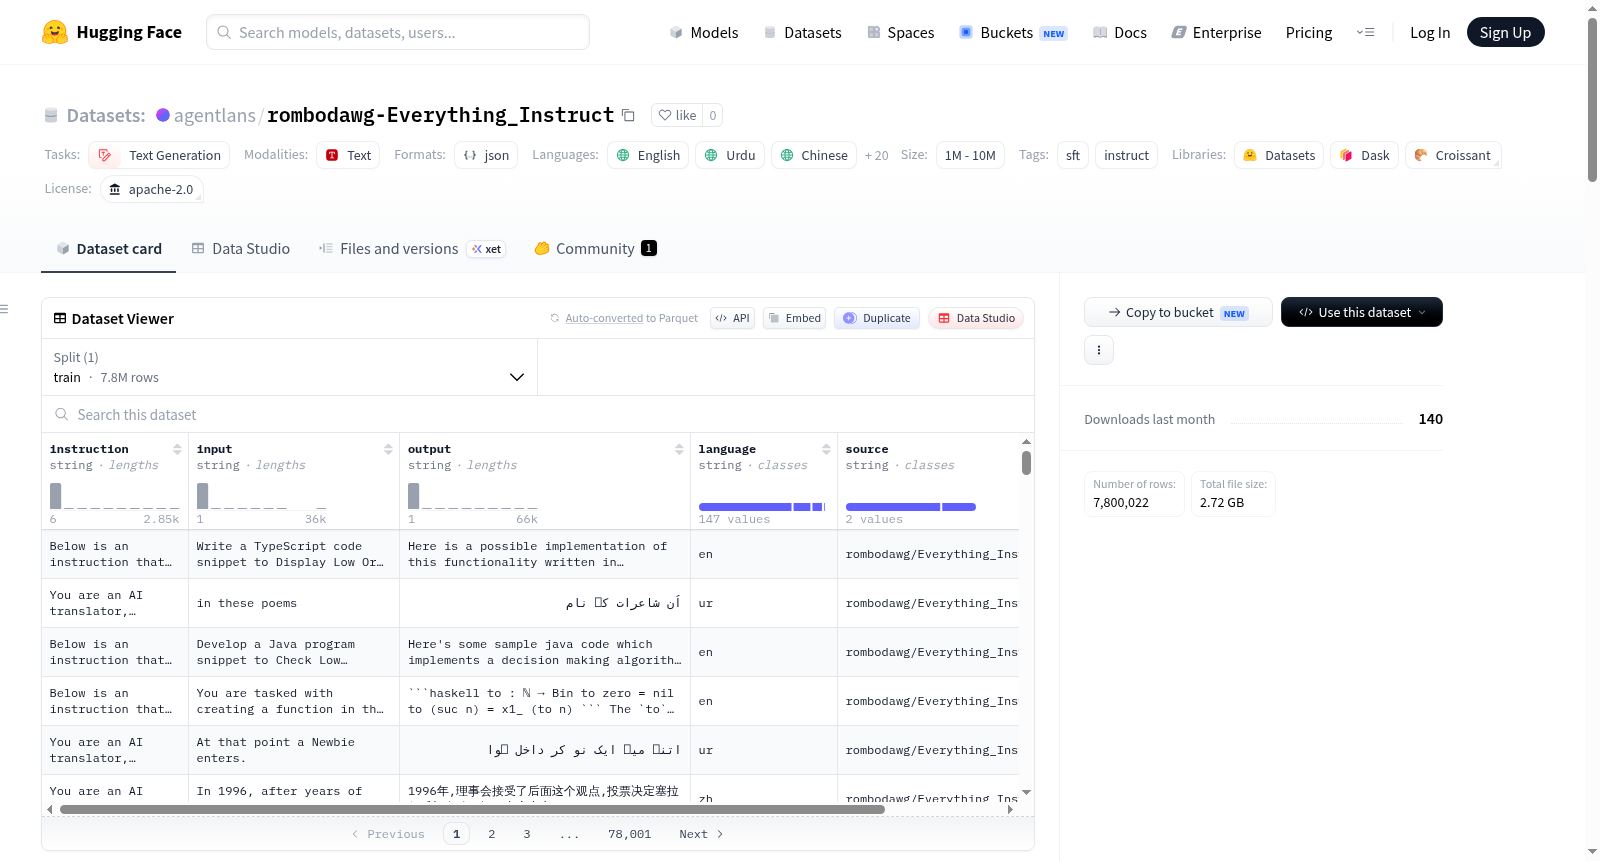
该数据集名为Everything-Instruct: Supervised Finetuning Dataset,是一个用于监督微调大型语言模型的数据集,包含超过7,000,000个指令-响应对。它结合了两个源数据集,适用于代码生成和调试、创意写作增强、提高指令跟随能力等多种任务,并支持包括英语、乌尔都语、中文、韩语、拉丁语、俄语、法语、西班牙语、德语、意大利语、日语、葡萄牙语、土耳其语、罗马尼亚语、芬兰语、捷克语、波斯语、阿拉伯语、乌克兰语、荷兰语、波兰语、塞尔维亚-克罗地亚语和加泰罗尼亚语在内的多种语言。数据集经过去重、敏感数据过滤、Unicode标准化和语言标注等处理步骤。各语言的数据行数分布不均,其中英语数据最多,乌尔都语次之。数据集存在一些局限性,如预处理导致的代码混乱、格式不规则、缺乏多轮对话等,且大多数指令和输入以英语为主。数据集遵循Apache 2.0许可证。

This dataset, named Everything-Instruct: Supervised Finetuning Dataset, is designed for supervised fine-tuning of large language models and contains over 7,000,000 instruction-response pairs. It combines two source datasets and is suitable for various tasks such as code generation and debugging, enhancing creative writing, and improving instruction-following capabilities. It supports multiple languages including English, Urdu, Chinese, Korean, Latin, Russian, French, Spanish, German, Italian, Japanese, Portuguese, Turkish, Romanian, Finnish, Czech, Persian, Arabic, Ukrainian, Dutch, Polish, Serbo-Croatian, and Catalan. The dataset has undergone processing steps including deduplication, sensitive data redaction, Unicode normalization, and language annotation. The distribution of rows across languages is uneven, with English having the most rows followed by Urdu. The dataset has some limitations, such as occasional mangled code due to preprocessing, irregular formatting, lack of multi-turn conversations, and a focus on English for most instructions and inputs. The dataset is licensed under Apache 2.0.
提供机构:
agentlans
搜集汇总
数据集介绍
agentlans/rombodawg-Everything_Instruct 数据集图片
构建方式
该数据集以大规模监督微调为核心理念,融合了来自rombodawg的Everything_Instruct及其多语言版本两大源数据集,经过精细的预处理流程构建而成。构建过程中,首先通过去重操作消除两个源数据集间的冗余重叠,继而借助Trufflehog工具与定制正则表达式对敏感信息(如URL、电子邮件及电话号码)进行脱敏处理。随后实施Unicode标准化以确保文本一致性,并利用Python的fasttext包为每条数据标注语言类别,最终汇聚成包含逾七百万条指令-响应对的庞大规模语料库。
特点
该数据集在语言覆盖与任务多样性上展现出显著特色,横跨英语、乌尔都语、中文、韩语等二十余种语言,其中英语样本占据主导地位,但亦包含大量乌尔都语与拉丁语条目,呈现出别具一格的语言分布格局。其核心应用场景聚焦于代码生成与调试、创意写作增强及通用指令遵循能力的提升,尤其适合单轮对话场景下的指令微调任务。然而,受限于原始数据来源,数据集在多轮对话支持、内容多样性以及指令与输入的语言一致性方面存在一定局限性。
使用方法
该数据集以Apache 2.0许可协议开源,可直接用于大语言模型的监督微调训练。使用者可通过HuggingFace平台加载数据集,并依据语言标签筛选特定语种的子集,或按需进一步拆分以适配不同训练目标。鉴于预处理过程中可能出现代码格式异常及原始数据中的不规则排版,建议在应用前进行必要的清洗与格式规范化。对于多语言场景,可结合fasttext语言检测结果优化数据配比,以平衡各语种在训练中的代表性。
背景与挑战
背景概述
在大语言模型领域,监督式微调(Supervised Fine-Tuning, SFT)是赋予模型遵循指令能力的关键环节,而高质量、大规模且覆盖多语言的指令数据集则是这一过程的基石。由研究团队于近期构建并发布的Everything-Instruct数据集,汇集了超过700万条指令-响应对,整合了rombodawg/Everything_Instruct及其多语言扩展版本,旨在提升模型在代码生成与调试、创意写作以及通用指令遵循等多方面的表现。该数据集不仅涵盖英语,还广泛涉及乌尔都语、中文、韩语等二十余种语言,为多语言大模型的训练提供了丰富的资源。其创建过程通过去重、敏感信息脱敏、Unicode标准化及语言标注等精细处理,显著增强了数据质量,对推动多语言指令微调的研究与实践具有重要影响。
当前挑战
Everything-Instruct数据集所面临的挑战多元且深刻。在领域问题层面,尽管其旨在提升模型的指令遵循能力,但数据来源的单一性(主要聚焦于编码与翻译任务)可能导致微调后的模型在多样化对话场景中泛化能力不足,且缺乏多轮对话数据限制了模型对复杂交互的理解。在构建过程中,预处理环节虽致力于去重与清洗,但偶尔出现的代码损坏、不规则格式与间距问题仍会干扰模型学习质量。更关键的是,语言分布极不均衡,乌尔都语和拉丁语条目异常庞大,而许多其他语言样本稀少,这种偏差可能引入训练偏见。此外,原始数据集未提供提示与答案的来源,使得数据溯源与质量验证变得困难,进一步加剧了模型在真实应用中的鲁棒性与可靠性风险。
常用场景
经典使用场景
在自然语言处理与大型语言模型微调的研究领域中,Everything-Instruct数据集以其庞大的体量与多语言特性,成为监督式微调(SFT)任务中的标杆性资源。该数据集汇聚了超过七百万条指令-响应对,整合了通用指令数据集与多语言扩展版本,适用于代码生成与调试、创意写作增强以及通用指令遵循能力的提升。研究者常利用其丰富的英语样本及涵盖乌尔都语、中文、拉丁语等二十余种语言的语料,进行跨语言模型能力的训练与评估,从而探索语言模型在多语言环境下的泛化表现与指令理解深度。
解决学术问题
该数据集有效解决了大规模指令数据稀缺与多语言覆盖不足的学术难题。传统微调数据集往往局限于单一语言或特定任务,难以支撑模型在多样化场景下的指令遵循能力研究。Everything-Instruct通过整合去重、敏感信息脱敏及语言标注等预处理流程,提供了高质量、结构化的多语言训练资源,使研究者能够系统性地探究模型在代码逻辑、创造性表达及跨语言迁移中的表现。其意义在于为监督式微调提供了可复现的基准,推动了语言模型在通用指令理解与多语言适应性的理论突破,并为后续数据增强与模型评估方法的发展奠定了坚实基础。
衍生相关工作
该数据集的诞生催生了多项经典研究工作,例如基于其语料库的多语言指令微调框架,旨在探索语言模型在低资源语言上的性能提升策略。此外,研究者利用该数据集对模型进行知识蒸馏与数据筛选实验,开发出更高效的微调方法,如动态样本权重分配与指令复杂度评估算法。在模型评估领域,该数据集被用作基准测试的一部分,衍生出针对多语言指令遵循能力的标准化评测体系,推动了诸如跨语言泛化分析、指令多样性对模型鲁棒性影响等方向的研究,形成了从数据构建到模型优化的完整学术链条。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

