Zouhir-Amazigh-Subtitles
收藏资源简介:
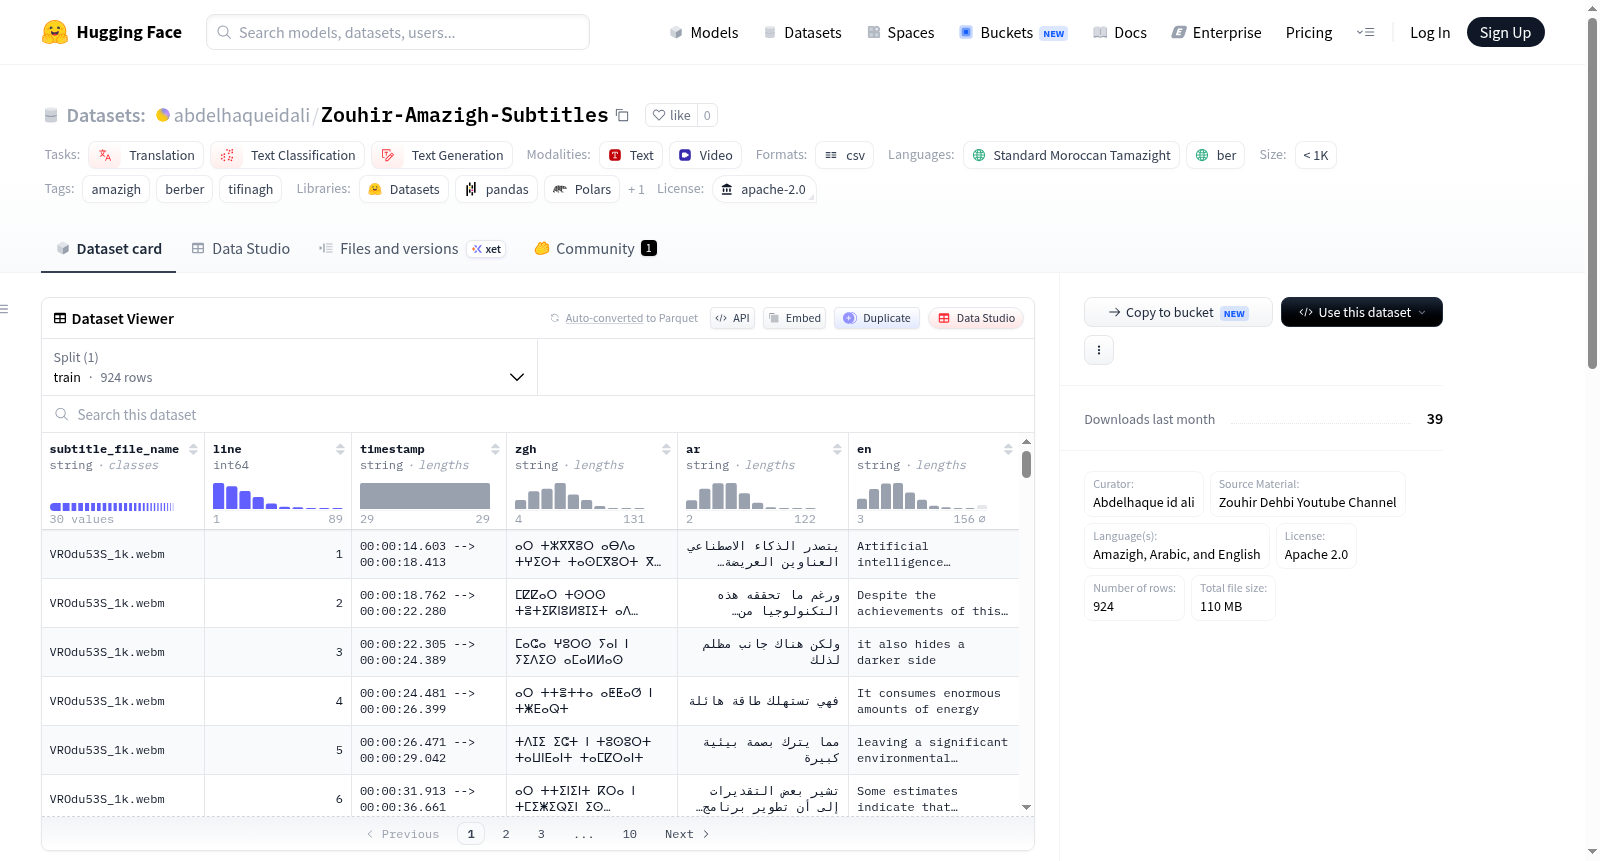
Zouhir-Amazigh-Subtitles 数据集是从 YouTube 频道“Zouhir Amazigh”中提取的平行句子级翻译和精确音频时间戳的集合。该数据集旨在支持 Amazigh(柏柏尔)语言的自动语音识别、机器翻译和文本生成任务,特别针对低资源语言场景。数据内容包含从视频字幕中抓取的对齐语音片段、文本时间戳以及句子级平行语料,覆盖 Amazigh、阿拉伯语和英语三种语言。数据集源自 Zouhir Dehbi 创建的高质量 Amazigh 字幕视频,用于解决低资源语言语音对齐数据短缺的问题,适用于训练语音到文本模型、跨语言翻译系统、语言建模和文本分类等应用。数据集采用 Apache 2.0 许可证发布。
The Zouhir-Amazigh-Subtitles dataset is a collection of parallel sentence-level translations and precise audio timestamps extracted from the YouTube channel Zouhir Amazigh. It aims to support automatic speech recognition, machine translation, and text generation tasks for the Amazigh (Berber) language, particularly in low-resource language scenarios. The data includes aligned speech segments, text timestamps, and sentence-level parallel corpora captured from video subtitles, covering three languages: Amazigh, Arabic, and English. Derived from high-quality Amazigh subtitled videos created by Zouhir Dehbi, the dataset addresses the shortage of speech alignment data for low-resource languages and is suitable for training speech-to-text models, cross-language translation systems, language modeling, and text classification applications. The dataset is released under the Apache 2.0 license.
数据集卡片:Zouhir-Amazigh-Subtitles
该数据集提供从 YouTube 频道 Zouhir Amazigh 提取的平行句级翻译和精确音频时间戳,旨在支持 Amazigh 语言的自动语音识别(ASR)、机器翻译和文本生成任务。
数据集详情
- 策展人: Abdelhaque id ali
- 素材来源: Zouhir Dehbi YouTube 频道
- 语言: Amazigh、阿拉伯语、英语
- 许可证: Apache 2.0
数据集摘要
数据集包含对齐的语音片段、文本时间戳以及从 Zouhir Amazigh 频道视频字幕中抓取的句级平行数据,作为微调语音转文本模型和低资源翻译系统的本地化资源。
支持的任务
- 翻译: 训练平行模型在 Amazigh 与目标语言之间进行转换。
- 文本生成: 语言建模和转录优化。
- 文本分类: 对话、主题或句法结构分类。
数据集结构
数据集包含以下配置:
- 配置名称:
default - 数据文件:
- 分割:
train - 路径:
aligned_subtitles_by_order final.csv
- 分割:
数据创建
策展理由: 为解决低资源语言语音对齐数据集短缺的问题,该存储库提供结构化、高质量的人工字幕数据,适用于将口语音频映射到文本。
源数据:
- 数据来源: 从
@zouhiramazigh138YouTube 频道抓取的字幕。 - 致谢: 特别感谢 Zouhir Dehbi 在其视频内容中致力于创建高质量 Amazigh 字幕的努力,这为该数据集奠定了基础。