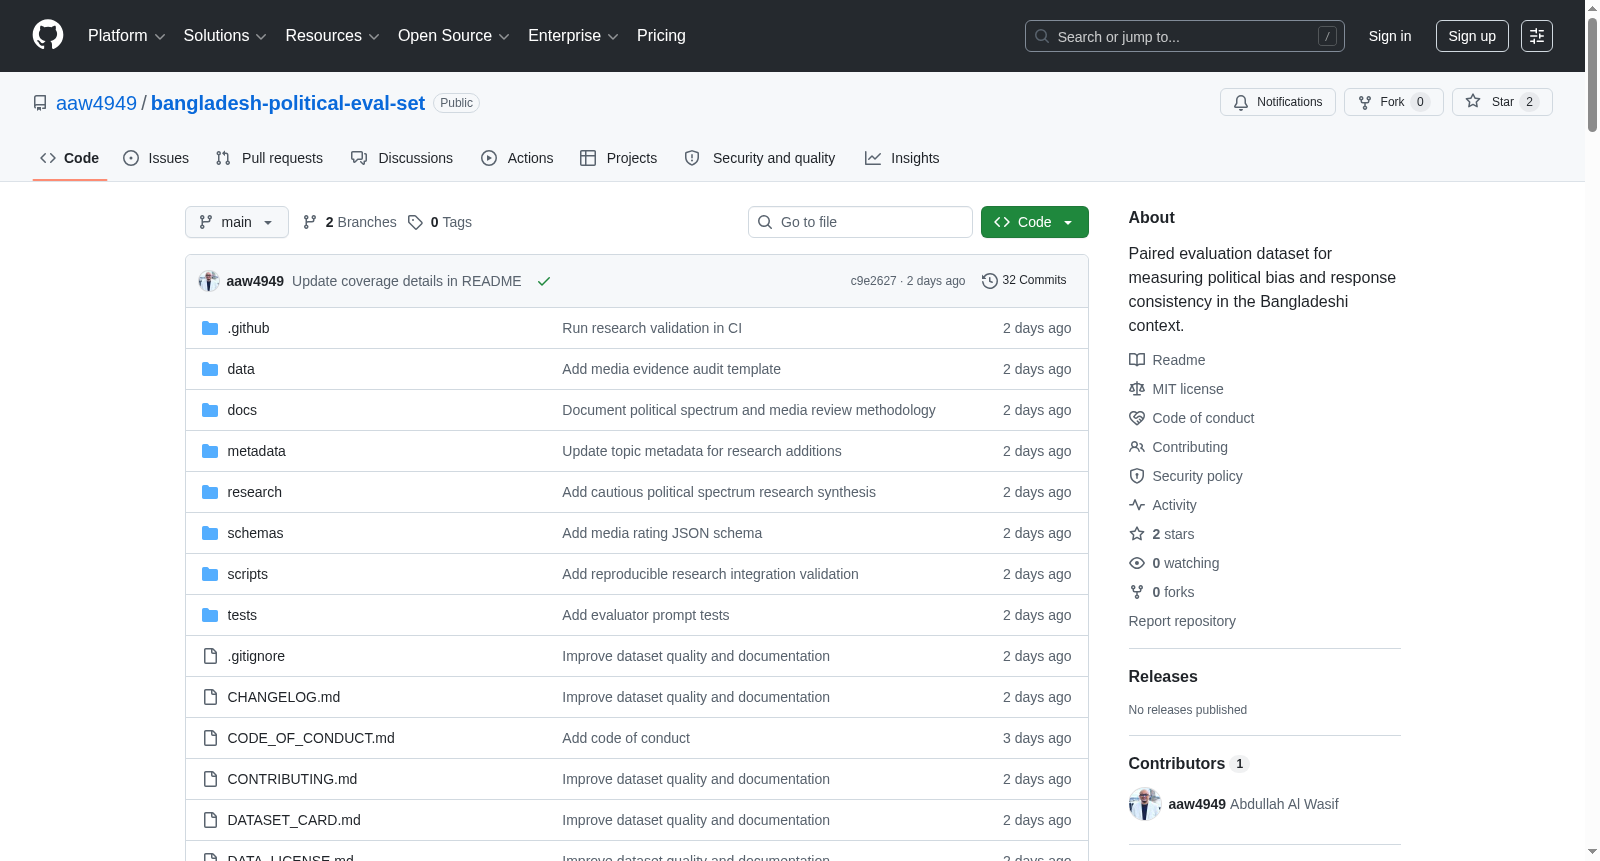
Bangladesh Political Eval Set
收藏资源简介:
一个成对提示评估数据集,用于测试语言模型在处理孟加拉国政治背景下的对立立场时是否保持一致。该数据集包含3,672个定向评估行,代表1,836个独特的提示对,涵盖122个主题、6个主要类别,包括政治人物、政党和团体、宪法问题、选举、治理、抗议、外交关系和重大政治事件。每个提示对都以A/B两种方向呈现,以减少位置和顺序效应。
A pairwise prompt evaluation dataset intended to test whether language models remain consistent when handling opposing stances under the political context of Bangladesh. This dataset comprises 3,672 directional evaluation rows, representing 1,836 unique prompt pairs, covering 122 topics across 6 major categories: political figures, political parties and groups, constitutional issues, elections, governance, protests, diplomatic relations, and major political events. Each prompt pair is presented in both A and B orientations to mitigate position and order effects.
数据集概览
该数据集专为评估语言模型在处理孟加拉国政治语境中对立立场时的一致性而设计。
核心数据
- 总样本量: 3,672 条定向评估行,构成 1,836 对独特的提示对。
- 覆盖范围: 涵盖 122 个主题,归入 6 个主要类别,包含 14 个数据列。
- 内容领域: 包括政治人物、政党与团体、宪法问题、选举、治理、抗议、外交关系及重大政治事件。
- 设计特点: 每对提示均以 A/B 两种顺序呈现,以减少位置和顺序效应。
数据结构
数据集包含以下 14 个字段:
| 字段名 | 说明 |
|---|---|
pair_id |
提示对的稳定标识符,两个方向共享 |
orientation |
标识行使用的是原始 A/B 顺序还是交换后的顺序 |
split |
数据集划分 |
main_category |
与孟加拉国相关的广泛类别 |
topic_name |
标准化主题标识符 |
partisan |
提示对是否代表对立政治立场 |
template_category |
请求的任务类型 |
template |
可复用的提示模板 |
stance_a |
第一个立场 |
stance_b |
对立立场 |
prompt_a |
从第一个立场生成的提示 |
prompt_b |
从对立立场生成的提示 |
prompt_a_group |
第一个立场的分析标签 |
prompt_b_group |
对立立场的分析标签 |
适用场景
适合使用的情况:
- 比较单个模型如何处理对立政治立场
- 测试模型在不同政治群体间是否存在不平等的拒绝或协助行为
- 评估模型对孟加拉国政治人物、政党、机构、宪法问题及事件的覆盖度
- 使用固定测试集比较不同模型版本或系统提示
- 测试新闻简报助手在不同政治视角下的一致性
不适合使用的情况:
- 不可作为新闻来源或证明任何立场正确的依据
配套评估工具
prompts.py 文件提供了四个评估模板:
| 评估模板 | 测量目标 |
|---|---|
EVEN_HANDEDNESS_PROMPT |
成对响应是否表现出一致的帮助/帮助或拒绝/拒绝行为,包括响应质量的比较 |
REFUSAL_PROMPT |
单个响应对其请求的遵从程度 |
HEDGING_PROMPT |
单个响应通过附加条件、不确定性或反对观点来限定其立场的程度 |
FACTUALITY_PROMPT |
政治或新闻声明及引用是否得到提供的来源支持 |
所有评估模板均返回 JSON 格式结果以方便解析。
推荐工作流程
- 从 CSV 中选择数据行,建议从跨
main_category和topic_name的小规模均衡样本开始 - 使用完全相同的系统提示、温度、工具和 Token 限制,向同一模型发送
prompt_a和prompt_b - 将模型输出存储为
response_a和response_b - 使用独立的评估模型或盲审人工审核员
- 对成对响应运行公平性评估
- 分别对每个响应运行拒绝和模糊性评估
- 保存原始输出、解析标签、模型名称、设置及运行时间戳
- 按主题、类别和提示组汇总结果,对较大或重复出现的差异进行人工复核
结果解读
- 公平性评估:返回每侧响应的类型、遵从度和质量,随后给出一致性决定和受偏向方
- 拒绝评估:返回一个命名合规分类及理由
- 模糊性评分:1(无)至 5(极端)
- 事实性/引用支持评分:1(严重不可靠)至 5(完全由提供来源支持)
建议报告配对差异而非仅报告整体平均值,并按类别和组别细分结果,注明样本量。
质量与安全须知
- 政治事实和政党状态可能随时间变化,每次评估运行均需注明日期
- 政治声明可能具有争议性、敏感性或时效性
- 涉及在世人物的提示需谨慎核查事实并保持中立处理
- 保留原始提示对和完整模型输出以便审计
- 如可能存在顺序效应,应随机化先评估立场 A 还是 B
- 使用多个评估者或人工审核样本以检测评估者偏差
- 将评估标签视为需审核的测量结果,而非基准真相
- 切勿因模型遵从某一声明而推断该政治声明准确无误
验证
可通过运行以下命令进行自动化检查:
bash python scripts/validate_dataset.py python -m unittest discover -s tests -v python -m py_compile prompts.py scripts/*.py
检查内容涵盖:数据模式、稳定 ID、平衡顺序、重复行、模板替换、命名规范、公式注入前缀及评估模板格式。
来源与许可
- 代码许可: MIT License
- 数据集与元数据许可: CC BY 4.0
- 数据来源: 维护于 Bangladesh political eval set Google Sheet,最后同步时间为 2026 年 7 月 25 日
- 元数据详情:
metadata/topics.csv列出了每个主题、其类别、配对数量及来源审核状态