
deadbits/vigil-gandalf-instruction-bypass-ada-002
收藏官方服务:
资源简介:
Vigil是一个用于评估大型语言模型提示的Python框架和REST API,专注于检测提示注入、越狱和其他潜在风险输入。该数据集包含text-embedding-ada-002嵌入,用于Lakera Gandalf 忽略指令数据集,所有提示在嵌入前已被转换为小写。数据集格式为JSON,包含文本、嵌入和模型信息。
Vigil是一个用于评估大型语言模型提示的Python框架和REST API,专注于检测提示注入、越狱和其他潜在风险输入。该数据集包含text-embedding-ada-002嵌入,用于Lakera Gandalf 忽略指令数据集,所有提示在嵌入前已被转换为小写。数据集格式为JSON,包含文本、嵌入和模型信息。
提供机构:
deadbits原始信息汇总
Vigil: LLM Gandalf Instruction Bypass text-embedding-ada-002
概述
Vigil 是一个用于评估大型语言模型(LLM)提示的Python框架和REST API,旨在检测提示注入、越狱和其他潜在风险输入。
数据集
- 数据集名称: text-embedding-ada-002
- 原始数据集: Lakera Gandalf "Ignore Instructions" dataset
- 处理方式: 所有原始数据集中的提示在嵌入之前已转换为小写。
格式
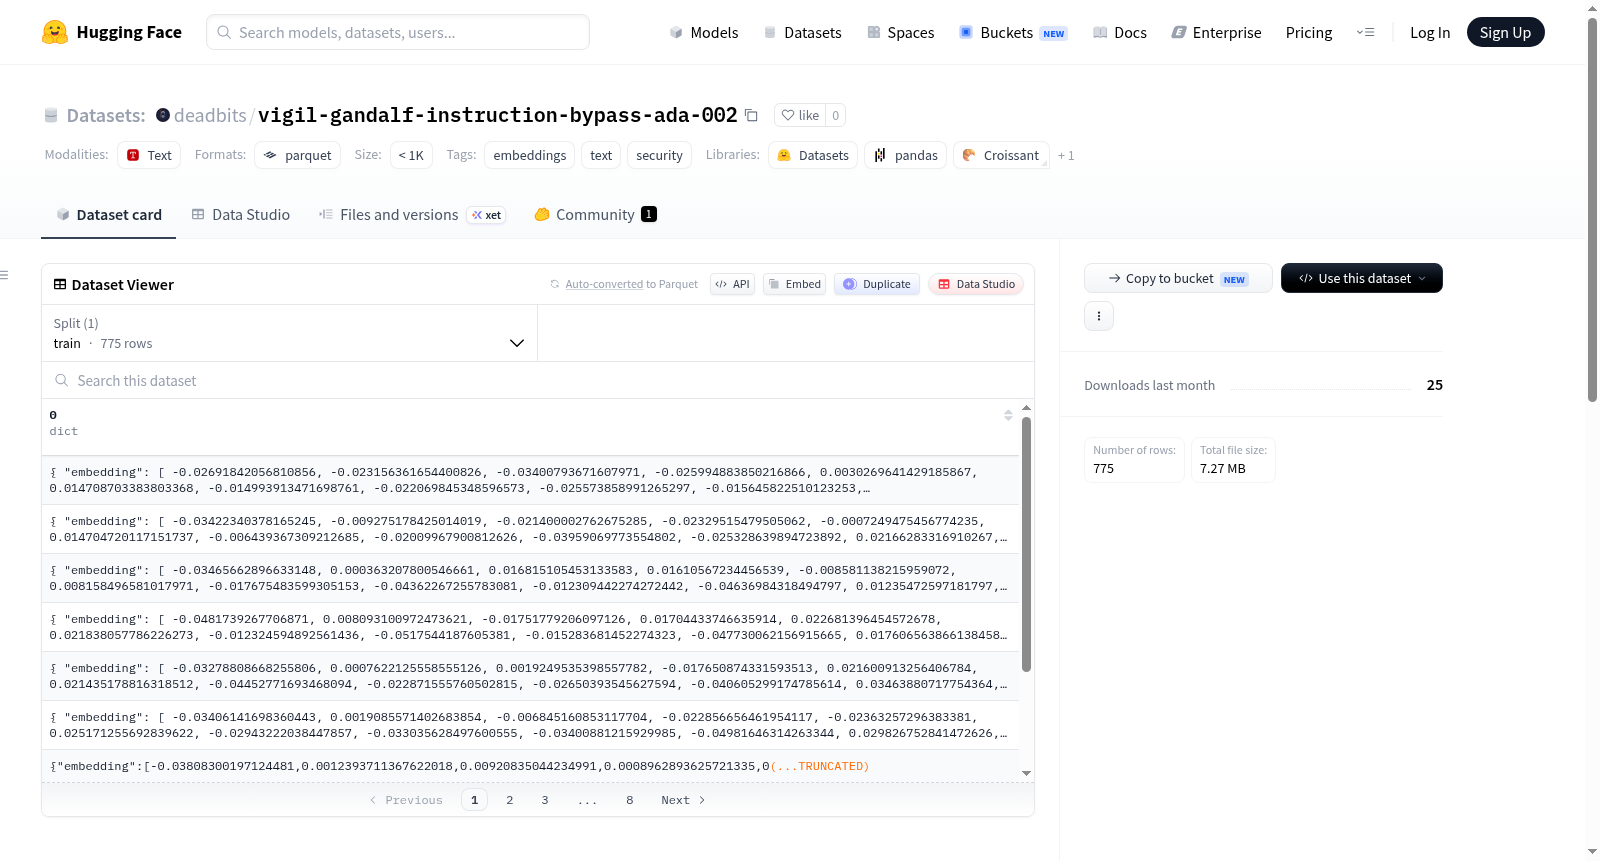
数据集以JSON格式存储,每个条目包含以下字段:
text: 字符串类型,表示提示文本。embedding: 列表类型,表示嵌入向量。model: 字符串类型,表示嵌入模型,此处为text-embedding-ada-002。
使用方法
可以使用parquet2vdb.py工具将嵌入加载到Vigil的chromadb实例中,或在自己的应用程序中使用。
搜集汇总
数据集介绍
构建方式
在大型语言模型安全评估领域,指令绕过攻击对模型部署构成了严峻挑战。本数据集源于Lakera Gandalf“忽略指令”数据集的深度加工,通过将原始提示文本统一转换为小写形式,再利用OpenAI的text-embedding-ada-002模型进行向量化嵌入,最终以JSON格式存储每条文本及其对应的嵌入向量与模型标识。这一构建流程确保了嵌入表示在语义空间中的一致性,为后续的威胁检测任务提供了标准化的数值基础。
特点
该数据集的核心特点在于其针对性的安全应用导向,所有嵌入均基于经过验证的指令绕过攻击样本生成,而非通用文本语料。通过统一的小写预处理和专用嵌入模型,数据集在降低噪声干扰的同时保留了攻击模式的关键语义特征。此外,其简洁的JSON结构(包含文本、嵌入向量和模型字段)便于直接集成到Vigil框架的ChromaDB实例中,或作为独立工具用于红队测试与提示注入检测系统的研发。
使用方法
使用者可借助Vigil框架提供的parquet2vdb.py工具,将本数据集的嵌入向量高效导入ChromaDB向量数据库,从而构建本地化的威胁检测知识库。亦可直接解析JSON文件,提取嵌入特征用于自定义分类器或相似度搜索任务。在应用时需注意,所有文本已执行小写处理,因此查询输入也应采用相同预处理步骤以保持特征空间的对齐,确保检测结果的可靠性。
背景与挑战
背景概述
随着大语言模型(LLM)在各类应用中的广泛部署,其安全性问题日益凸显,尤其是提示注入(prompt injection)和越狱(jailbreak)攻击已成为威胁模型可靠运行的核心挑战。在此背景下,Lakera AI于2023年创建了Gandalf Ignore Instructions数据集,旨在系统性地收集和分析模型在面对指令忽略攻击时的脆弱性。该数据集由Lakera AI的研究团队主导,聚焦于探索LLM在对抗性输入下的行为模式,为安全评估提供了宝贵的基础资源。随后,deadbits团队基于此数据集,利用OpenAI的text-embedding-ada-002模型生成了嵌入表示,形成了Vigil Gandalf Instruction Bypass数据集,进一步推动了LLM安全防御框架Vigil的发展。这一工作不仅强化了对抗性提示的检测能力,也为后续研究提供了标准化的嵌入基准,对提升LLM系统的鲁棒性具有重要影响。
当前挑战
该数据集所面临的挑战主要体现在两个层面。首先,在领域问题层面,LLM的提示注入和越狱攻击具有高度隐蔽性和多样性,攻击者可通过精心设计的指令绕过模型的安全机制,导致模型输出有害或未经授权的信息。传统基于规则或关键词的检测方法难以有效应对不断演变的攻击模式,亟需更精准的语义级检测手段。其次,在数据集构建过程中,原始Gandalf数据集中的提示需经过预处理(如统一小写化)以确保嵌入一致性,但这一过程可能丢失部分攻击特征,影响嵌入的鉴别力。此外,利用text-embedding-ada-002模型生成嵌入时,嵌入质量高度依赖模型本身对对抗性语义的捕捉能力,而该模型并非专为安全检测优化,可能引入偏差,限制了数据集在真实防御场景中的泛化性能。
常用场景
经典使用场景
在大型语言模型安全评估领域,deadbits/vigil-gandalf-instruction-bypass-ada-002数据集为研究者提供了一套基于text-embedding-ada-002嵌入向量的指令绕过攻击样本库。其经典使用场景聚焦于构建和验证对抗性提示检测系统,通过将原始Lakera Gandalf数据集中所有提示文本进行小写化预处理后生成高维语义嵌入,使得研究人员能够利用余弦相似度等度量方法,高效识别并分类诸如提示注入、越狱攻击等恶意输入,从而推动LLM安全防护机制的标准化测试与迭代优化。
解决学术问题
该数据集系统性地解决了大型语言模型在指令遵循场景下对抗性攻击检测的学术难题。传统安全研究往往依赖人工标注的原始文本样本,缺乏统一的数值化表征基准。此数据集通过预计算嵌入向量,消除了文本预处理和特征提取的差异性,使研究者可专注于攻击模式的语义相似性分析。它填补了LLM安全领域标准化嵌入数据集的空白,为对比不同检测算法性能提供了可复现的评估基础,深刻影响了对抗性提示检测方法的可量化研究范式。
衍生相关工作
该数据集催生了多项经典衍生工作,包括基于向量数据库的轻量级检测工具如parquet2vdb.py,实现了从嵌入数据到可查询索引的无缝转换。研究者在此基础上开发了多模态攻击检测系统,将文本嵌入与行为特征结合,提升对复杂越狱攻击的识别率。此外,该数据集还启发了对抗性嵌入空间分析的研究,通过t-SNE等降维技术可视化攻击样本的分布规律,为设计鲁棒性更强的提示净化算法奠定了数据基础。
以上内容由遇见数据集搜集并总结生成


