RSW233/MVCap-4M
收藏资源简介:
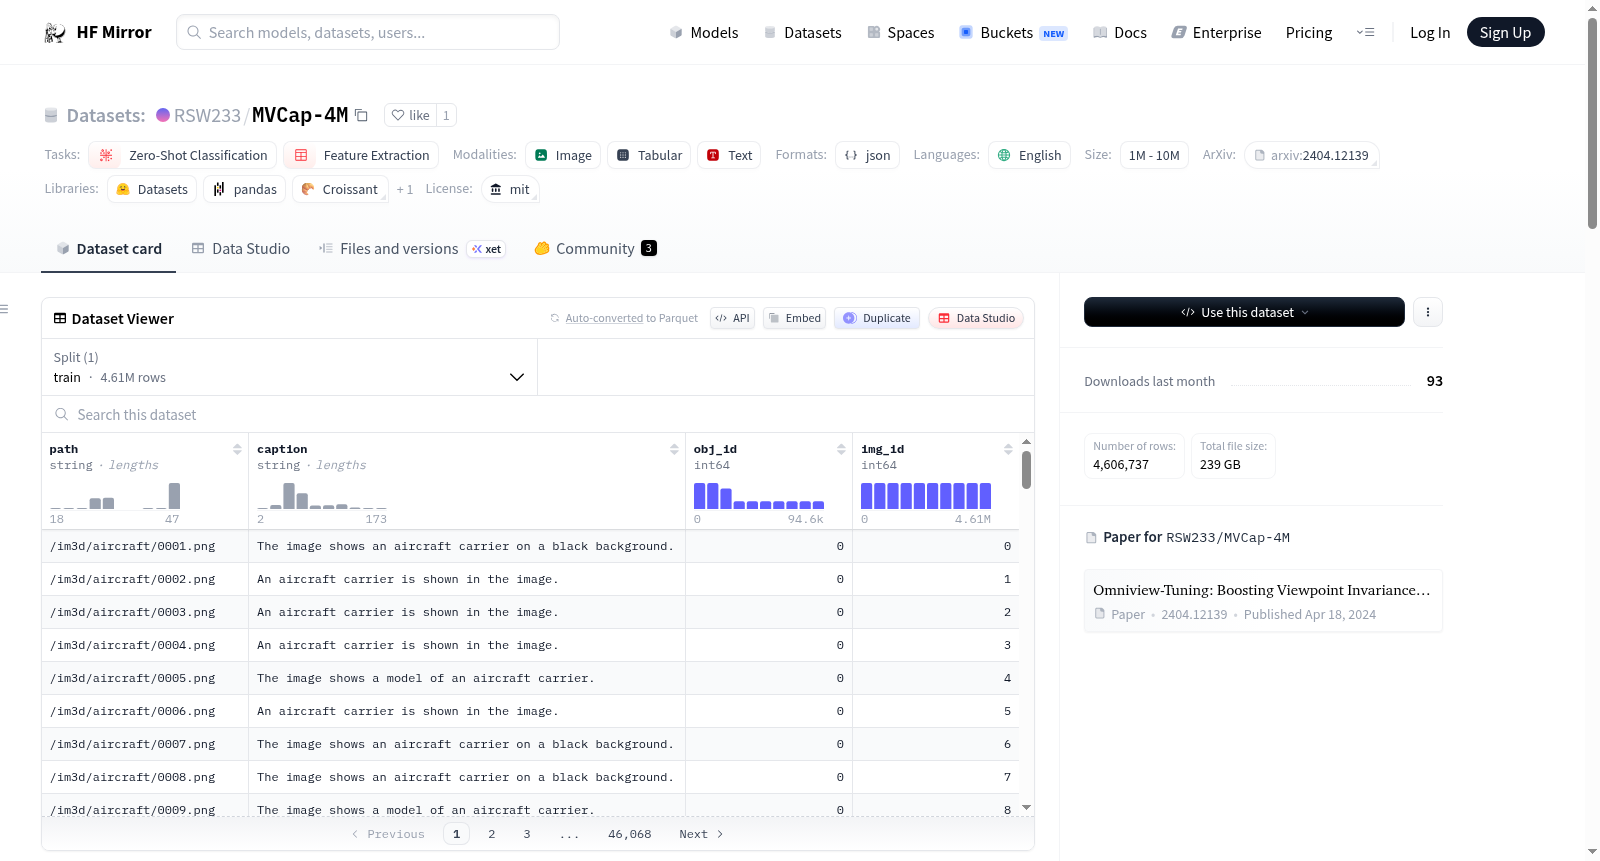
MVCap-4M数据集是一个大规模的多视角图像-文本对数据集,专门用于研究视觉-语言预训练(VLP)模型的视角不变性。该数据集包含了超过460万个多视角图像-文本对,涉及超过10万个对象。数据集的构建结合了多种3D资产和真实世界的多视角数据,通过选择和渲染现有数据集中的多视角图像,并使用视觉大语言模型(VLLM)进行自动字幕生成,以获得丰富的语义描述。为了确保不同视角下类别的一致性,采用了类别引导提示策略。
The MVCap-4M dataset is a large-scale multi-view image-text pair dataset specifically designed for researching the viewpoint invariance of Vision-Language Pretraining (VLP) models. It contains over 4.6 million multi-view image-text pairs across more than 100K objects. The dataset is assembled by combining various 3D assets with real-world multi-view data, selecting and rendering multi-view images from existing datasets, and utilizing a Vision Large Language Model (VLLM) for automated caption generation to obtain semantically rich textual descriptions. A category-guided prompting strategy is implemented to ensure category consistency across varying viewpoints in the generated captions.
MVCap-4M 数据集
概述
- 名称: MVCap-4M
- 语言: 英语
- 任务类别:
- 零样本分类
- 特征提取
- 数据规模: 1M<n<10M
- 配置:
- 配置名称: default
- 数据文件:
- 分割: train
- 路径: metadata.json
数据集描述
- 目标: 用于视觉-语言预训练模型的视角不变性研究。
- 规模: 包含超过460万的多视角图像-文本对,涵盖超过10万个对象。
- 数据来源: 结合多种3D资产与真实世界的多视角数据,通过现有数据集的多视角图像选择和渲染生成。
- 文本生成: 使用视觉大语言模型(VLLM)进行自动化标题生成,采用类别引导提示策略确保不同视角的文本描述一致性。
数据结构
- metadata.json: 存储每个图像样本的路径、标题、对象ID和图像ID序列。
- 多视角图像来源:
- Objavers-80k: 存储在子文件夹
/views - IM3D: 存储在子文件夹
/im3d - MVImgNet: 存储在子文件夹
/mvimgnet
- Objavers-80k: 存储在子文件夹
引用
@article{Ruan2024Omniview, title={Omniview-Tuning: Boosting Viewpoint Invariance of Vision-Language Pre-training Models}, author={{Shouwei Ruan, Yinpeng Dong, Hanqing Liu, Yao Huang, Hang Su, Xingxing Wei}}, journal={European Conference on Computer Vision (ECCV)}, year={2024} }
联系方式