
cerc-aai/CHIRP
收藏官方服务:
资源简介:
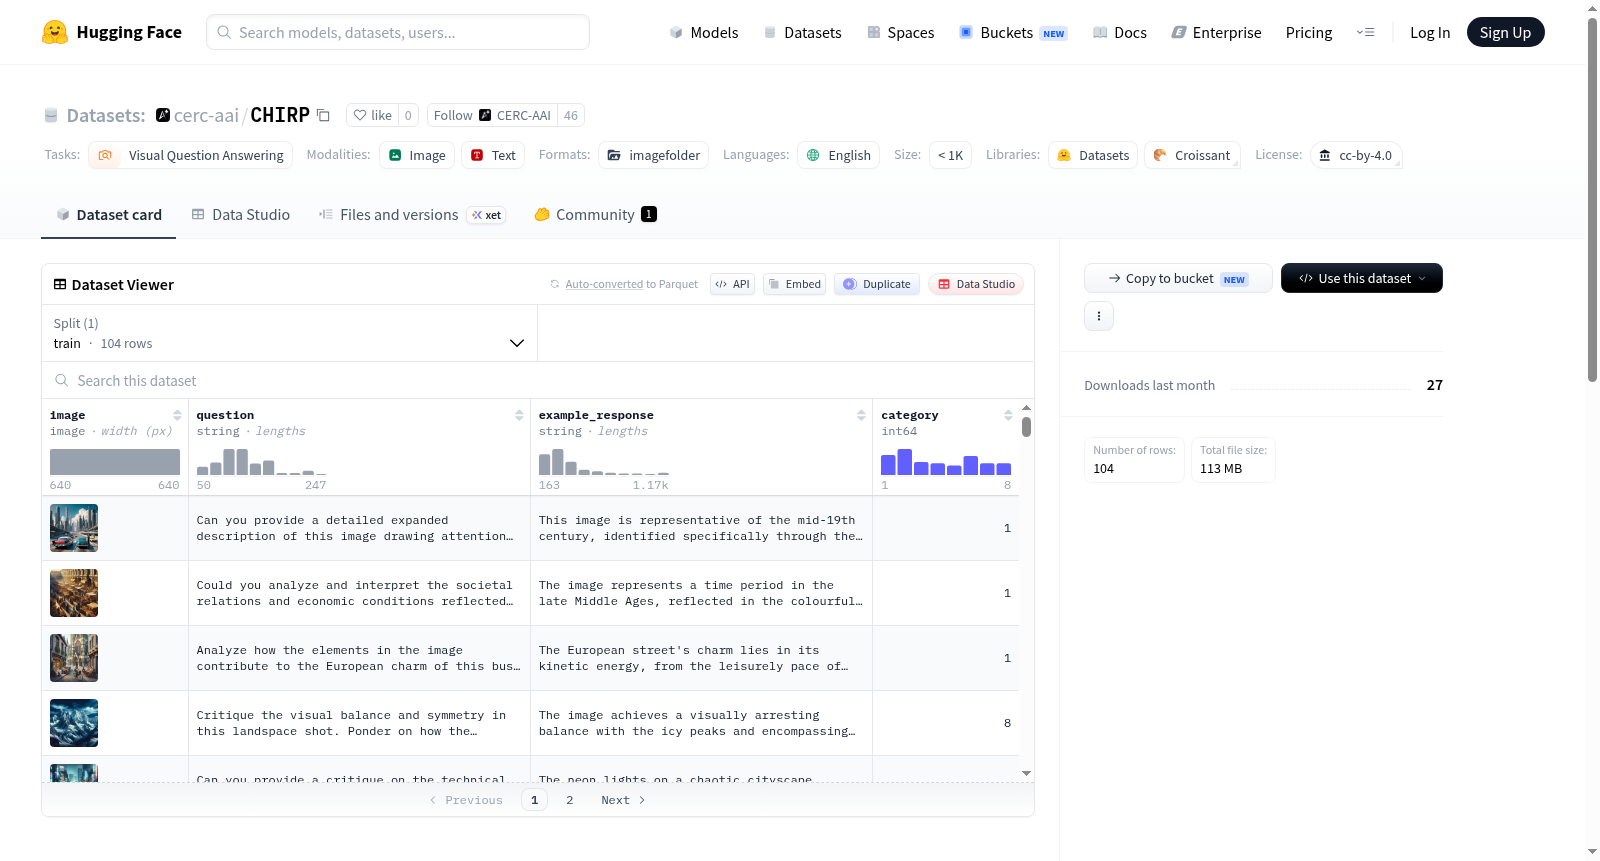
CHIRP Benchmark是一个开放式自由形式的多模态评估基准,包含104个开放式问题。这些问题要求模型生成更具创造性和开放性的回答,而不是简单地给出正确答案。该基准涵盖8个不同类别的问题,每个类别都需要理解图像内容,并提供分析和详尽的回答。类别包括描述性分析、推理推理、情境理解、情感和心理理解、伦理评估、抽象理解、创造性和主观分析以及视觉美学评估。评估通过模型响应的成对比较进行,由视觉语言模型或人类评估者选择更优的响应。
CHIRP Benchmark是一个开放式自由形式的多模态评估基准,包含104个开放式问题。这些问题要求模型生成更具创造性和开放性的回答,而不是简单地给出正确答案。该基准涵盖8个不同类别的问题,每个类别都需要理解图像内容,并提供分析和详尽的回答。类别包括描述性分析、推理推理、情境理解、情感和心理理解、伦理评估、抽象理解、创造性和主观分析以及视觉美学评估。评估通过模型响应的成对比较进行,由视觉语言模型或人类评估者选择更优的响应。
提供机构:
cerc-aai原始信息汇总
CHIRP Benchmark 数据集概述
基本信息
- 许可证: cc-by-4.0
- 任务类别: 视觉问答
- 语言: 英语
- 数据集名称: CHIRP Benchmark
- 数据规模: n<1K
数据集描述
CHIRP Benchmark 是一个新的多模态评估基准,包含 104 个开放式问题。这些问题要求模型生成更具开放性、创造性的响应,且没有“正确”答案。数据集包括 8 个不同类别的问题,每个类别都需要理解图像,并提供深入分析和全面响应的机会。
问题类别
- 描述性分析: 测试模型识别和描述图像中物理元素的能力,包括颜色、位置、交互以及特定细节的识别。
- 推理推理: 考察模型从图像中推断信息的能力,包括预测可能的后续事件、对先前上下文的假设,以及对图像中当前情景的替代情景的假设。
- 上下文理解: 测试模型对图像理解中上下文重要性的认识,可能涉及对地理或时间方面的理解。
- 情感和心理理解: 衡量模型从图像中判断情感和心理状态的能力,包括解读图像中角色的可见情感表达和对其心理状态的假设。
- 伦理评估: 考察模型如何处理图像的伦理影响,能否识别潜在的伦理问题,并根据普遍接受的伦理准则判断图像的公共展示可接受性。
- 抽象理解: 评估模型的抽象思维能力,能否识别图像中不明显的潜在主题或信息,并进行哲学解释。
- 创造性和主观分析: 衡量模型的创造力和表达对图像主观观点的能力,包括基于图像场景构建扩展叙事和提出个人观点。
- 视觉美学评估: 考察模型评估图像视觉美学的能力,包括平衡、对称、色彩构成、光线等方面。
评估方法
通过模型响应的成对比较进行评估,由更强的视觉语言模型 (VLM) 或人类评估者选择偏好响应。评估的潜在提示可在相关论文中找到。
搜集汇总
数据集介绍
构建方式
CHIRP基准数据集由104个开放式问题构成,旨在评估多模态模型的生成能力。其构建核心在于设计了8个独特的问答类别,涵盖描述性分析、推断推理、情境理解、情感与心理理解、伦理评估、抽象理解、创意与主观分析以及视觉美学评估。每个类别的问题均要求模型在理解图像的基础上,生成富有深度和创造性的响应,而非追求单一正确答案。数据集的评估通过成对比较模型回答的方式进行,由更强视觉语言模型或人类评估者选择更优响应。
特点
CHIRP数据集的显著特点在于其开放式、自由形式的问答设计,突破了传统视觉问答基准对固定答案的依赖。8个类别全面覆盖了从基础视觉描述到高级抽象推理的能力维度,尤其强调模型在伦理判断、情感解读和创意表达上的表现。这种设计不仅测试模型的视觉理解深度,还评估其生成连贯、合理且富有洞察力文本的能力,为多模态模型的综合性能提供了更贴近真实应用的评测标准。
使用方法
使用CHIRP数据集时,需将图像与对应开放式问题输入视觉语言模型,要求模型生成自由形式的文本回答。评估阶段采用成对比较法,将同一问题下不同模型的回答进行配对,由评估者(人类或更强VLM)基于整体质量、合理性和创意性选择更优者。研究人员可参考论文中的提示模板,确保评估过程的一致性和可比性。数据集规模较小(少于1000个样本),适合用于模型的快速诊断和比较分析。
背景与挑战
背景概述
在视觉语言模型(VLM)迅猛发展的当下,传统评估基准多聚焦于封闭式问答或事实性推理,难以全面衡量模型的创造性、伦理判断与抽象理解等高级认知能力。为此,CHIRP基准数据集于近期由cerc-aai团队提出,旨在填补开放生成式多模态评估的空白。该基准包含104个精心设计的开放性问题,覆盖描述性分析、推理性推理、情境理解、情感与心理认知、伦理评估、抽象理解、创意主观分析及视觉美学评价等八大维度。其核心研究问题在于探索VLM在无标准答案场景下的生成质量与人类偏好的匹配度,通过成对比较机制实现评估。CHIRP的出现为多模态领域提供了更贴近真实应用场景的评估范式,尤其在人机交互、内容审核与创意生成等前沿方向具有重要影响力。
当前挑战
CHIRP所面临的挑战主要源于其开放生成式评估的本质。首先,领域问题层面,传统VLM在事实性问答中表现优异,但在伦理评估、抽象理解等需高阶认知的任务中,模型常暴露出偏见、逻辑矛盾或缺乏共情能力,这直接挑战了当前多模态模型在复杂社会情境下的泛化能力。其次,构建过程中,设计104个覆盖八大维度的开放性问题本身即具难度,需确保问题既具区分度又避免歧义,且成对比较评估依赖人类或强VLM的偏好判断,这引入了主观性偏差与标注成本问题。此外,如何平衡各维度问题的难度与代表性、防止模型通过记忆而非理解生成回答,也是构建该基准时需持续优化的核心挑战。
常用场景
经典使用场景
CHIRP基准数据集以其104道开放式问题为核心,专为评估多模态模型在自由形式问答中的表现而设计。其经典使用场景在于引导视觉语言模型(VLM)超越简单的事实性回答,转向更具创造性与深度的生成任务。数据集涵盖描述性分析、推理性推理、情境理解、情感与心理洞察、伦理评价、抽象思维、创意主观分析及视觉美学评估八大维度,全面检验模型对图像的多层次理解能力。通过成对比较的评估机制,研究者能够精准衡量模型在开放式场景下的综合表现,推动多模态领域从封闭式任务向开放、复杂、人性化的交互范式演进。
衍生相关工作
CHIRP基准的提出催生了一系列衍生研究工作。一方面,研究者基于其八大评估维度,开发了针对特定认知能力的细粒度测试集,如专注于伦理推理的Moral-VQA或情感理解的EmoVLM。另一方面,其成对比较评估方法被用作改进模型训练策略的参考,例如利用强化学习从人类反馈中优化VLM的开放式生成质量。此外,CHIRP的数据划分与评估协议还启发了多模态领域中的“对抗性基准”构建,用以检验模型对复杂、模糊或矛盾信息的鲁棒性。这些工作共同丰富了视觉语言模型在开放场景下的评估生态,推动了更全面、更严谨的研究方法论的形成。
数据集最近研究
最新研究方向
当前,多模态大语言模型的评估正从封闭式问答向开放式、创造性推理方向演进。CHIRP基准数据集应运而生,它通过104道自由形式问题,系统性地检验视觉语言模型在描述分析、推断推理、伦理判断及美学评价等八个维度的综合能力。该基准紧密关联模型在复杂场景下的情感理解、抽象思维与主观表达等前沿研究热点,其通过成对比较的评估机制,为衡量模型生成的响应质量提供了更贴近人类认知的标尺。CHIRP的提出填补了现有基准缺乏对模型高阶认知与伦理敏感性考察的空白,对推动多模态系统向更具创造性与社会责任感的智能体发展具有重要指导意义。
以上内容由遇见数据集搜集并总结生成


