
mnlp-nsoai/dpo-student-preference-pairs
收藏官方服务:
资源简介:
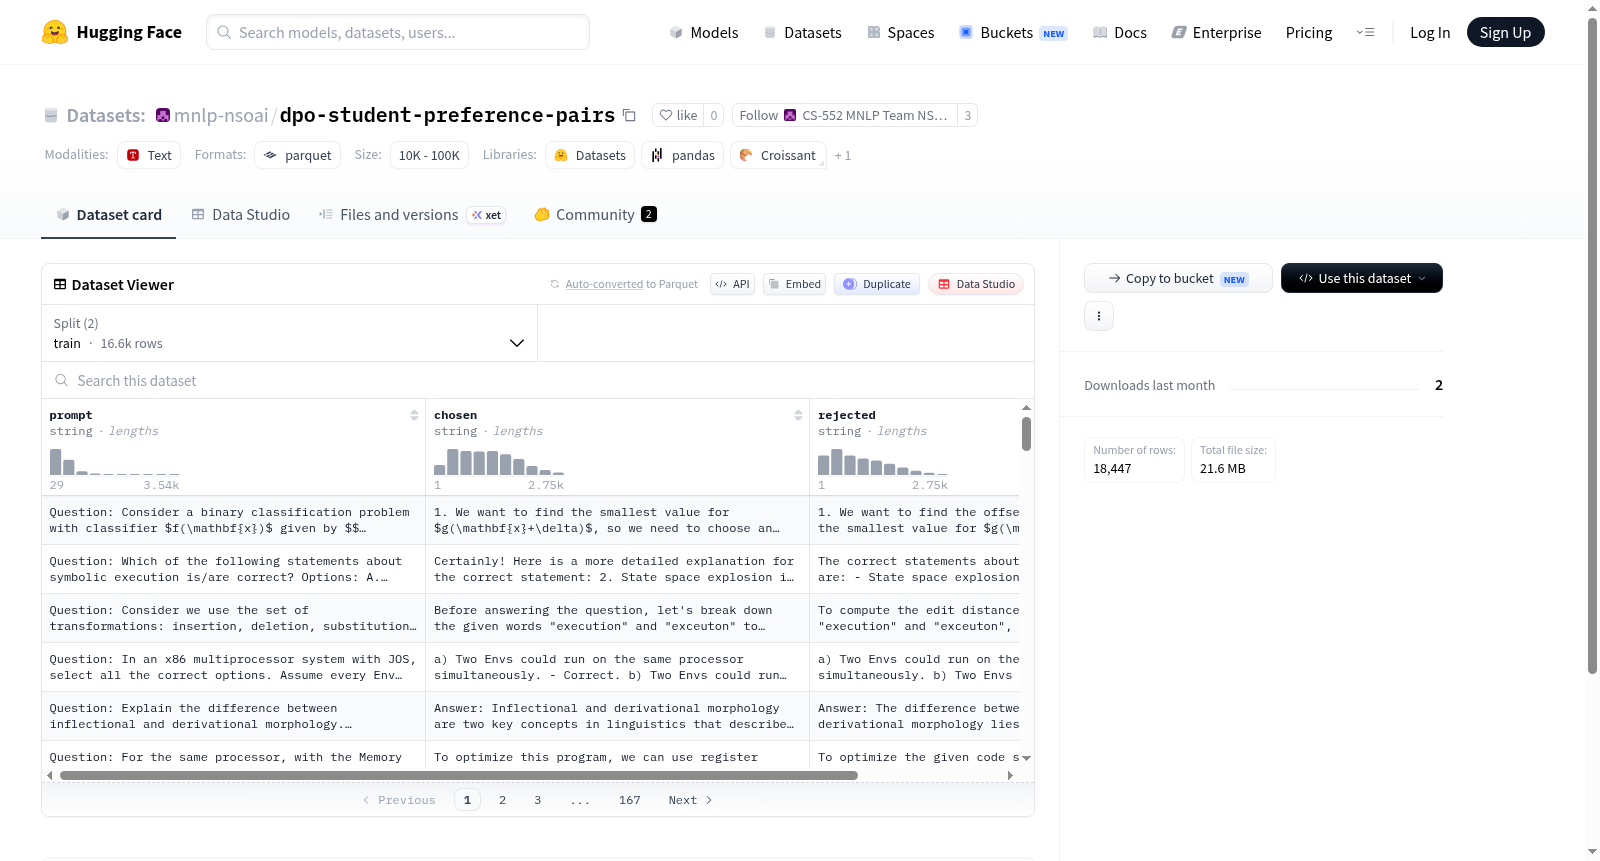
该数据集包含三个主要特征:prompt(提示)、chosen(选定)和rejected(拒绝),均为字符串类型。数据集分为训练集和测试集,训练集有16602个样本,测试集有1845个样本。数据文件分别存储在data/train-*和data/test-*路径下。
该数据集包含三个主要特征:prompt(提示)、chosen(选定)和rejected(拒绝),均为字符串类型。数据集分为训练集和测试集,训练集有16602个样本,测试集有1845个样本。数据文件分别存储在data/train-*和data/test-*路径下。
提供机构:
mnlp-nsoai原始信息汇总
数据集概述
数据集特征
- prompt: 数据类型为字符串
- chosen: 数据类型为字符串
- rejected: 数据类型为字符串
数据集分割
- 训练集 (train):
- 示例数量: 16602
- 数据大小: 40801263字节
- 测试集 (test):
- 示例数量: 1845
- 数据大小: 4535262字节
数据集大小
- 下载大小: 21577156字节
- 数据集总大小: 45336525字节
数据文件配置
- 默认配置 (default):
- 训练集路径: data/train-*
- 测试集路径: data/test-*
搜集汇总
数据集介绍
构建方式
在人工智能对齐领域,偏好数据集是训练强化学习与人类反馈(RLHF)模型的核心基石。mnlp-nsoai/dpo-student-preference-pairs数据集专为直接偏好优化(DPO)算法设计,其构建方式聚焦于学生与模型交互场景。数据集中每条样本包含三个核心字段:prompt(提示)、chosen(被选中的优质回答)和rejected(被拒绝的劣质回答),通过成对对比的形式捕捉人类偏好。该数据集划分为训练集与测试集,其中训练集包含16602个样本,测试集包含1845个样本,确保了模型训练与评估的独立性。数据以Parquet格式存储,并采用分片方式组织,便于高效加载与分布式处理。
使用方法
使用该数据集时,首先需通过HuggingFace Datasets库加载,指定config_name为default即可自动获取训练集与测试集。数据加载后,可直接利用prompt、chosen和rejected字段构建DPO训练流程。例如,在DPO损失函数中,将chosen作为正样本、rejected作为负样本,与模型生成的logits进行对比优化。推荐使用PyTorch或TensorFlow框架,结合transformers库中的AutoModelForCausalLM进行模型微调。训练时需注意数据的分批处理,可利用Datasets的shuffle和map方法进行预处理,确保输入格式与模型tokenizer兼容。最终,通过测试集评估模型在偏好对齐任务上的表现。
背景与挑战
背景概述
在人工智能与教育深度融合的浪潮中,如何精准捕捉并利用学生与模型交互过程中的偏好信息,成为提升智能辅导系统个性化能力的关键。mnlp-nsoai/dpo-student-preference-pairs数据集由南京师范大学自然语言处理团队于2023年创建,聚焦于学生与对话式教育模型交互时产生的偏好对,核心研究问题在于如何通过对比学生选择与拒绝的回复,优化模型的奖励机制与生成策略。该数据集包含约1.8万条训练样本与近2000条测试样本,每条样本由提示词、优选回复与劣选回复构成,为偏好学习、强化学习及教育领域的大模型微调提供了宝贵的基准资源,推动了从通用对话到教育场景的精细对齐研究。
当前挑战
该数据集面临的挑战首先体现在教育领域特有的偏好建模难题:学生偏好受认知水平、情感状态及学习目标等多维因素影响,远复杂于通用场景下的简单优劣判断,现有模型难以从有限样本中泛化出稳定的教育偏好规律。其次,在构建过程中,专家标注一致性难以保证,不同教育工作者对“优选回复”的评判标准存在主观差异,导致标签噪声显著。此外,数据规模相对较小,仅1.6万余条训练对,难以覆盖多样化的学科知识与提问风格,易引发模型过拟合于特定教育语境,限制了其在跨科目、跨年级场景中的迁移能力。
常用场景
经典使用场景
在偏好对齐与强化学习领域,该数据集作为人类反馈驱动的核心资源,广泛用于训练和评估基于直接偏好优化(DPO)算法的语言模型。其经典使用场景在于,通过提供成对的偏好数据(chosen与rejected),使模型能够学习区分更优与次优的生成结果,从而在无需显式奖励建模的情况下直接优化策略。这种范式在微调大规模语言模型时尤为关键,能够有效缓解传统强化学习从人类反馈(RLHF)中奖励模型偏差与训练不稳定的问题。
解决学术问题
该数据集直面了语言模型对齐研究中的核心挑战:如何高效、稳定地让模型输出符合人类偏好。传统RLHF方法依赖独立的奖励模型,不仅计算开销大,且易陷入过拟合或奖励黑客困境。基于此数据集,研究者得以探索DPO等无奖励模型的对齐策略,从而规避了奖励建模的复杂性,同时保持了与人类偏好高度一致的对齐效果。这一突破显著降低了偏好对齐的门槛,推动了可控文本生成与安全语言模型的理论发展。
实际应用
在实际应用中,该数据集赋能了对话系统、内容生成助手与教育辅导工具等产品的伦理对齐。例如,在智能客服场景中,模型可依据偏好对筛选出更礼貌、更准确的回复;在创意写作辅助中,能够自动规避低质或有害内容。此外,它还被用于训练面向特定群体的自适应模型,如青少年教育场景中的安全对话机器人,确保生成内容既符合知识正确性又兼顾情感适宜性。
数据集最近研究
最新研究方向
在人工智能与教育深度融合的浪潮中,偏好对齐技术成为提升大语言模型教学辅助能力的关键突破口。mnlp-nsoai/dpo-student-preference-pairs数据集聚焦于学生与模型交互中的偏好学习,通过收集学生在不同教学场景下对模型回复的倾向性选择,为直接偏好优化(DPO)算法提供高质量训练样本。该数据集的前沿研究方向在于利用细粒度的学生反馈信号,驱动模型从被动应答转向主动适配个体认知水平与学习风格,从而在智能辅导、自适应习题推荐等场景中实现更精准的个性化教育。当前,随着全球对教育公平与效率的关注升温,这一数据集不仅为构建符合人类价值观的助学模型奠定数据基础,更推动了“以学习者为中心”的AI教育范式从理论走向实践,其研究成果有望重塑未来课堂的交互形态与知识传递方式。
以上内容由遇见数据集搜集并总结生成


