
遇见数据集

ViewPulseAI/viewpulse-vpa-sample

收藏
Hugging Face2026-05-28 更新2026-05-31 收录
官方服务:

资源简介:

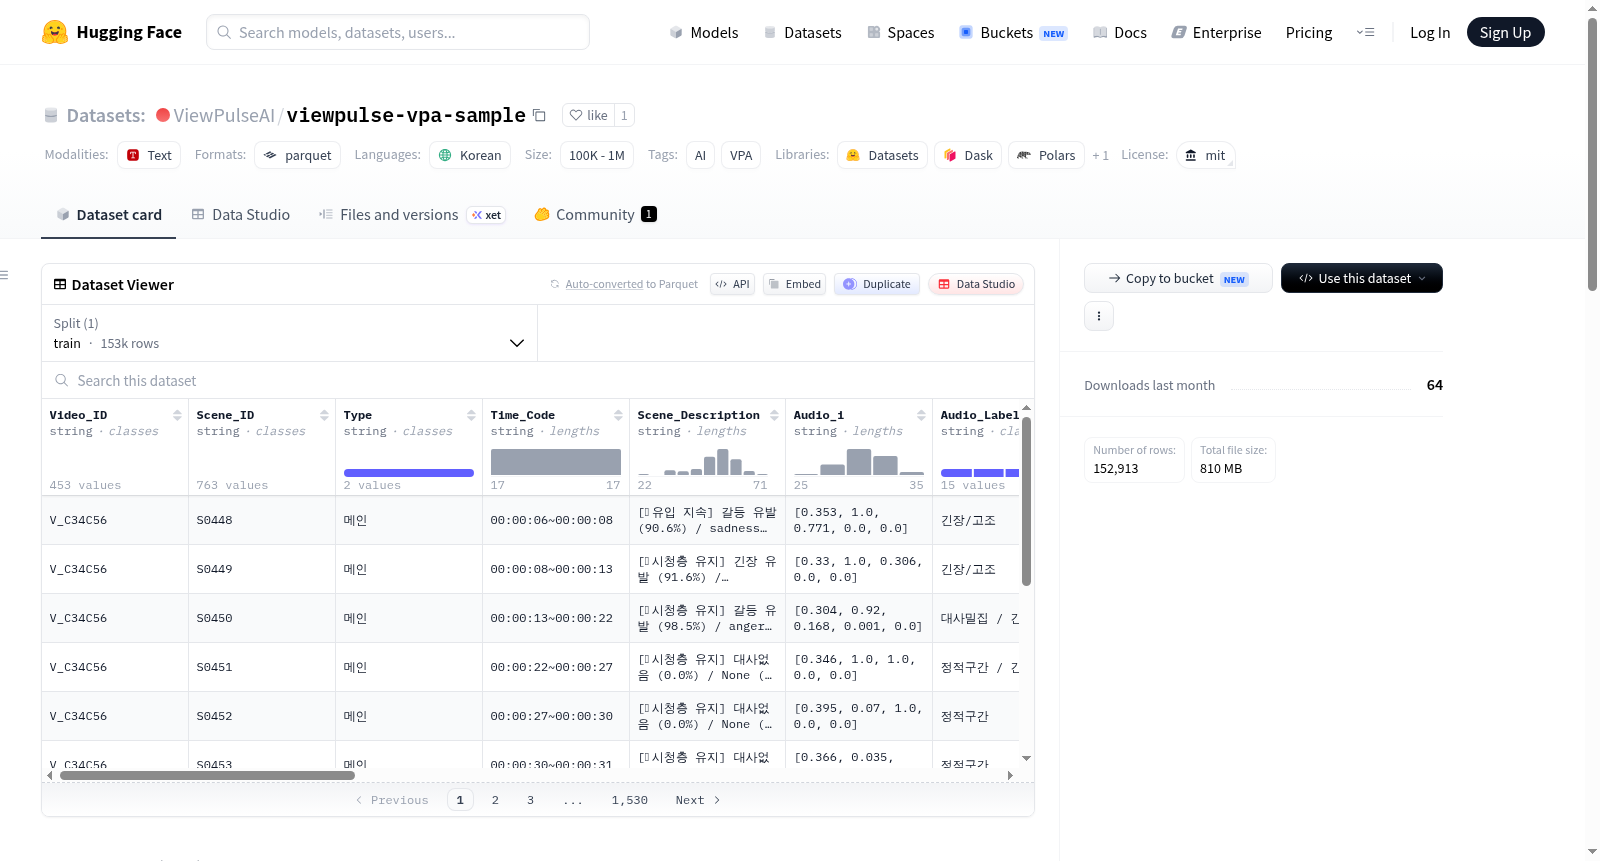
View Pulse AI (VPA) 多模态媒体行为数据集是一个专有数据集,专为预测观众行为分析而设计。它连接原始视频内容与实时观众参与数据,优化用于AI驱动的评分预测引擎。数据集采用Parquet格式,包含音频紧张度与氛围频谱特征、上下文情感分析的NLP向量、场景构图与动态的视觉特征,以及基于序列的时序行为模式特征。标签为Reaction_Class(-1, 0, 1),用于观众行为分类。该数据集通过SBV(场景行为向量)引擎高精度预测观众保留率,支持数据驱动的内容制作和战略广播。

The View Pulse AI (VPA) Multimodal Media Behavior Dataset is a proprietary multimodal dataset designed for predictive audience behavior analysis. It bridges raw video content with real-time viewer engagement, optimized for AI-driven rating prediction engines. The dataset is in Parquet format and includes features such as audio tension and atmosphere spectral features, contextual sentiment analysis via NLP vectors, scene composition and dynamics in vision features, and sequence-based temporal behavioral patterns. The label is Reaction_Class (-1, 0, 1) for audience behavior categorization. It is utilized by the SBV (Scene Behavior Vector) engine to predict viewer retention with high precision, enabling data-backed content production and strategic broadcasting.
提供机构:
ViewPulseAI
搜集汇总
数据集介绍
ViewPulseAI/viewpulse-vpa-sample 数据集图片
构建方式
viewpulse-vpa-sample数据集由ViewPulse AI构建,其核心基于专利保护的SBV(场景行为向量)引擎,旨在弥合原始视频内容与实时观众参与之间的鸿沟。该数据集以高度精炼的Parquet格式呈现,整合了多模态特征:音频模块提取紧张氛围与情绪频谱特征,视觉组件分析场景构成与动态变化,自然语言处理向量则捕捉上下文情感倾向,同时引入时间序列模块刻画序列化行为模式。观众反应被标注为三分类标签(-1、0、1),用于分类受众行为反应类别,从而服务于AI驱动的收视率预测系统。
特点
该数据集最引人注目的特点是其多模态融合的策略与工业级实用性。通过将音频、视觉、文本与时间特征统一编码为1340维的高维向量空间,它实现了对媒体内容观众互动的全面数字化表征。与普通标注数据集不同,VPA强调行为预测的精准度,其标签不仅反映了即时反应,还隐含了时序上的连续影响。此外,受国家专利保护且采用Parquet格式优化存储与吞吐,使其成为面向广播策略优化和内容生产决策的高价值数据资产。
使用方法
使用该数据集时,AI工程师可通过Hugging Face的datasets库直接加载:调用`load_dataset("ViewPulseAI/viewpulse-vpa-sample")`即可获取训练集,随后转换为Pandas DataFrame进行探索分析或直接输入到PyTorch等深度学习框架中。为方便快速体验,开发者还可通过配套的Colab Notebook在线运行代码,零环境配置即可浏览Time_Code、Scene_Description与Audio_Label等核心字段。注意该数据集为样本版本,完整数据集及API接入需联系版权所有方进行商业授权。
背景与挑战
背景概述
View Pulse AI(VPA)多模态媒体行为数据集诞生于智能媒体分析蓬勃发展的背景下,由ViewPulse AI团队研发,核心研究问题在于如何通过多模态特征融合实现精准的观众行为预测。该数据集于2026年申请国家专利,围绕音频张力特征、NLP情感向量、视觉场景动态及时间序列模式构建了1340维的场景行为向量(SBV),旨在弥补传统收视率预测中缺乏实时多模态整合的空白。作为专有数据集,它展示了AI驱动的内容生产与广播策略的革新潜力,为媒体行业提供数据支撑的观众留存预测工具。
当前挑战
该数据集面临的挑战涵盖领域问题与构建过程两方面。在领域层面,如何从纷繁复杂的视频内容中提取高度抽象的音频、视觉与情感特征以准确分类观众反应(-1, 0, 1)是一大难点,需要解决多模态信息异构性带来的语义对齐问题。构建过程中,数据集需确保时域维度上特征与标签的精确对齐,并处理大量样本的标注一致性;同时,作为专有数据集,其商业授权模式限制了开放研究的共享与验证,增加了跨场景泛化的不确定性。
常用场景
经典使用场景
在受众行为预测与多模态内容理解领域,ViewPulse VPA 数据集凭借其整合音频、视觉、自然语言与时间序列信号的独特架构,成为训练高精度观众留存率预测模型的核心数据资源。该数据集的经典使用场景聚焦于基于场景行为向量引擎的观众反应分类任务,研究者可借助其1340维多模态特征与三级反应标记,构建端到端的深度学习框架,实现对视频内容中观众情绪与注意力波动的实时捕捉与量化。
实际应用
在实际应用层面,ViewPulse VPA 数据集赋能内容生产与广播电视行业的智能化决策。基于其训练的预测引擎能够辅助影视制作团队在后期剪辑阶段评估关键场景的观众留存潜力,助力广播公司实现基于数据结果的播出策略优化。此外,它还可应用于广告投放效果预判与流媒体平台的个性化推荐系统,通过量化分析观众对特定情感线索的反应模式,提升商业内容与用户需求的匹配效率。
衍生相关工作
围绕该数据集衍生的经典工作主要集中在多模态行为预测网络架构的演进。研究者借鉴了场景行为向量的概念,开发了结合注意力机制与时间卷积的混合模型以强化序列行为建模;同时,基于其三级反应标签,衍生出细粒度的音频-视觉-文本联合嵌入方法。这些工作不仅验证了跨模态表征对提升观众行为预测精度的有效性,还推动了将影视内容理解为动态心理刺激场这一理论框架的发展。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

