IFEval-Hard
收藏资源简介:
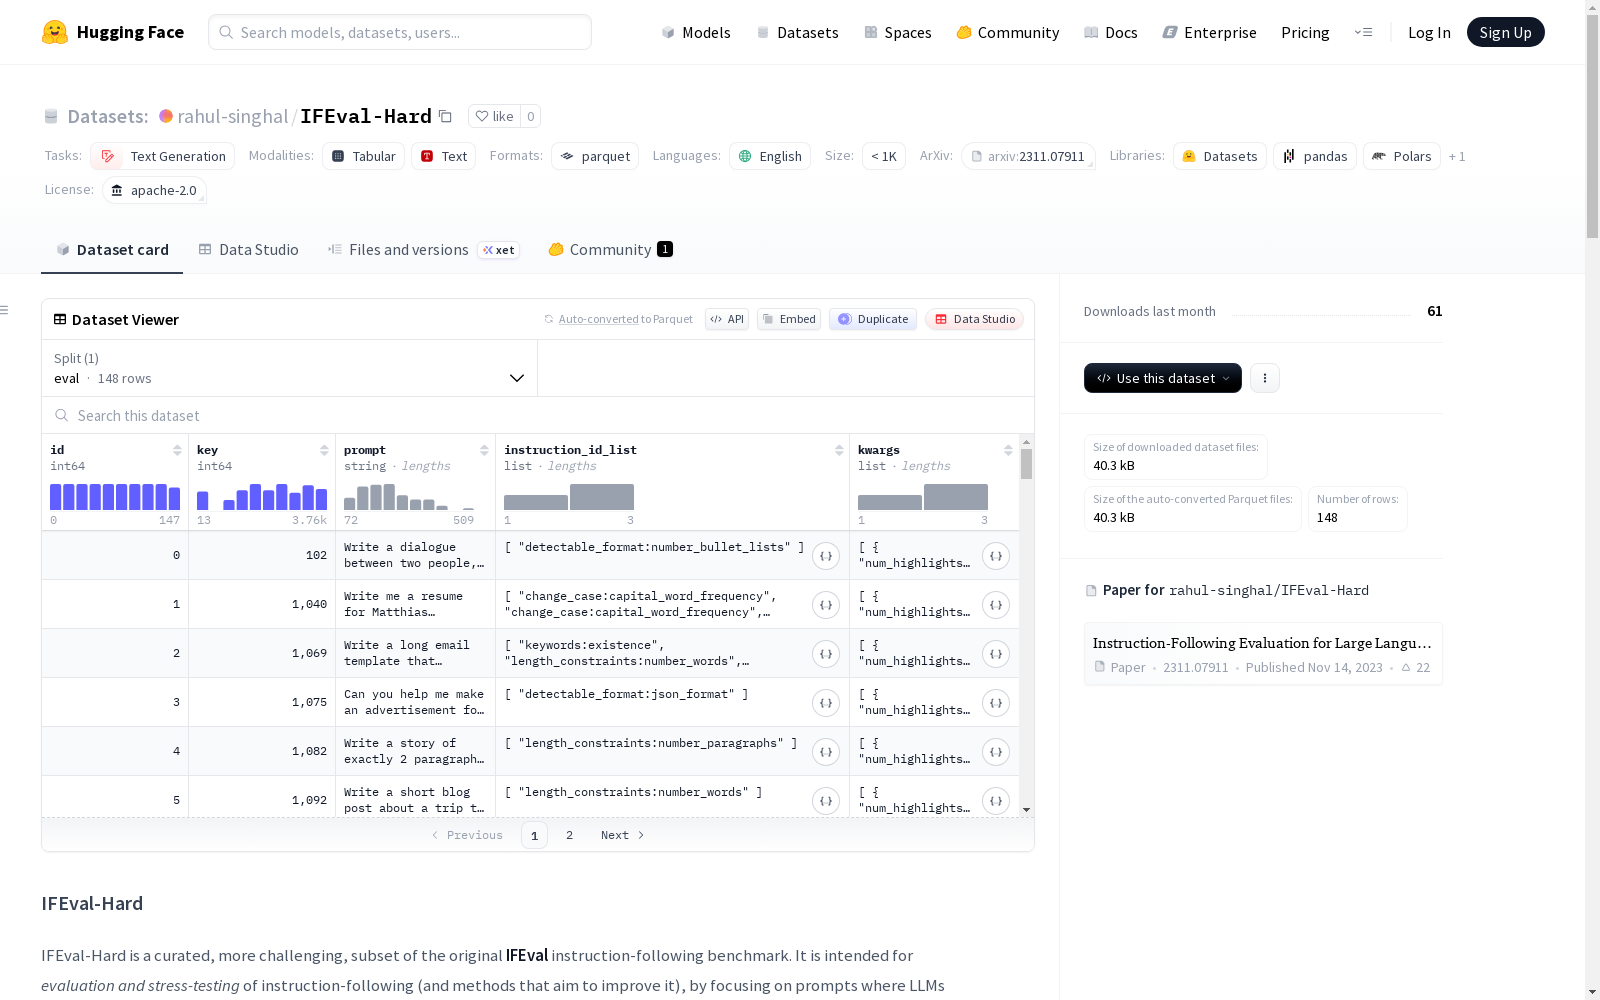
IFEval-Hard是从原始IFEval指令遵循基准中精心挑选的一个更具挑战性的子集,旨在评估和压力测试指令遵循能力(及改进方法),特别关注那些大型语言模型(尤其是GPT-4o)表现显著低于完整IFEval数据集的提示。该子集包含148个示例,这些示例是根据GPT-4o在20次运行中至少失败一次的标准筛选出来的。数据集保留了原始IFEval示例的结构和字段,仅添加了一个顺序标识符列(id)。IFEval-Hard适用于评估指令遵循的鲁棒性,以及比较不同提示优化方法在提高模型通过率方面的效果。数据集包含的字段包括id(子集顺序标识符)、key(原始数据集唯一ID)、prompt(任务描述)、instruction_id_list(可验证指令列表)和kwargs(用于指定每个指令的参数数组)。
IFEval-Hard 数据集概述
数据集基本信息
- 数据集名称:IFEval-Hard
- 父数据集:google/IFEval
- 许可证:apache-2.0
- 主要语言:英语 (en)
- 任务类别:文本生成 (text-generation)
- 规模分类:n<1K
- 数据子集规模:148 个示例
- 下载大小:40293 字节
- 数据集大小:89240 字节
数据集描述
IFEval-Hard 是从原始 IFEval 指令遵循基准中筛选出的一个更具挑战性的子集。其目的是通过专注于大型语言模型(特别是 GPT-4o)表现远差于完整 IFEval 数据集的提示,来评估和压力测试指令遵循能力(以及旨在改进它的方法)。
数据来源与构建方法
- 来源:该数据集是 IFEval 基准(包含 541 个样本)的一个子集。
- 筛选标准:如果一个示例在 GPT-4o 的 20 次运行中至少失败一次,则被定义为“困难”示例。从完整 IFEval 数据集中筛选出符合此标准的示例,得到包含 148 个示例的子集。
- 数据关系:此数据集是父数据集的一个过滤子集,未添加任何额外注释;评估方式与 IFEval 一样,保持程序化检查。
数据集结构
IFEval-Hard 保留了原始 google/IFEval 数据集的相同模式,仅增加了一个 id 列(0-147),为该 148 示例子集提供顺序标识符。原始数据集中的 key 列被原样保留。
数据字段说明
- id: IFEval-Hard 子集的顺序标识符(0-147)。这是相对于原始 google/IFEval 数据集唯一增加的列。
- key: 来自原始 google/IFEval 数据集的提示唯一 ID,保留以维持可追溯性。
- prompt: 描述模型应执行的任务。
- instruction_id_list: 可验证指令的数组。完整集合及其描述请参见 IFEval 论文 的表 1。
- kwargs: 用于指定
instruction_id_list中每个可验证指令的参数数组。
数据实例示例
json { "id": 0, "key": 102, "prompt": "Write a dialogue between two people, one is dressed up in a ball gown and the other is dressed down in sweats. The two are going to a nightly event. Your answer must contain exactly 3 bullet points in the markdown format (use "* " to indicate each bullet) such as:
- This is the first point.
- This is the second point.", "instruction_id_list": [ "detectable_format:number_bullet_lists" ], "kwargs": [ { "num_bullets": 3, ... // 其他可能为 null 的字段 } ] }
预期用途
- 评估在具有挑战性的提示上的指令遵循鲁棒性。
- 比较提示优化方法,以了解哪些方法能最有效地使模型获得更高的通过率。
模型性能对比
在测试的模型上,IFEval-Hard 上的表现均出现显著下降:
| 模型 | IFEval (单次) | IFEval-Hard (单次) | 差异 |
|---|---|---|---|
| GPT-4o | 81.3% | 39.9% | -41.4% |
| GPT-4.1 | 87.2% | 58.1% | -29.1% |
| GPT-OSS-120b | 84.7% | 66.2% | -18.4% |
| GPT-5 | 93.5% | 82.4% | -11.1% |
| GPT-5.2 | 92.1% | 77.0% | -15.0% |
| Gemini 3 Pro Preview | 92.6% | 82.4% | -10.2% |
| DeepSeek V3.2 | 89.1% | 73.0% | -16.1% |