
YAP470_Code_Classification_Final_Data
收藏官方服务:
资源简介:
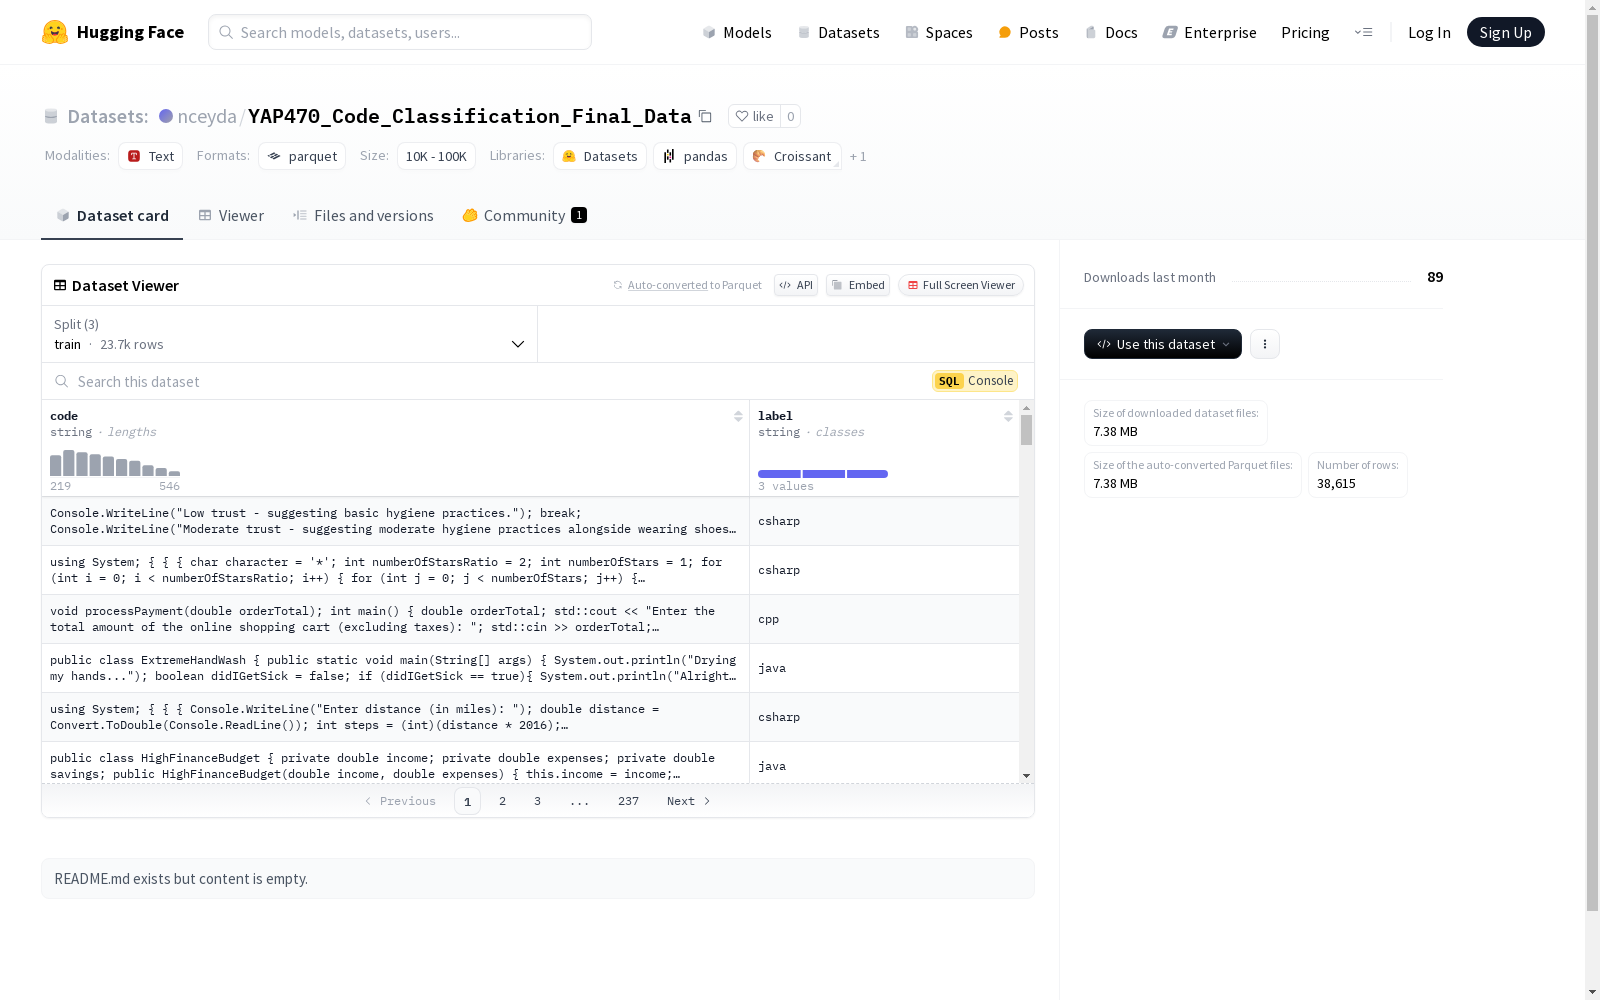
该数据集包含两个主要特征:'code'和'label',均为字符串类型。数据集分为三个部分:训练集(train)、验证集(validation)和测试集(test),分别包含23692、5923和9000个样本。数据集的总下载大小为7383137字节,总数据集大小为17660435字节。数据集配置为'default',数据文件路径分别对应训练、验证和测试集。
This dataset includes two core features: 'code' and 'label', both of which are string data types. The dataset is split into three subsets: training set (train), validation set (validation), and test set (test), containing 23692, 5923, and 9000 samples respectively. The total download size of the dataset is 7383137 bytes, and the total dataset size is 17660435 bytes. The dataset is configured with the 'default' configuration, and the data file paths correspond to the training, validation, and test sets respectively.
创建时间:
2024-12-01
原始信息汇总
YAP470_Code_Classification_Final_Data 数据集概述
数据集信息
特征
- code: 类型为字符串(string)
- label: 类型为字符串(string)
数据分割
- train:
- 样本数量: 23692
- 字节数: 8538651
- validation:
- 样本数量: 5923
- 字节数: 2130845
- test:
- 样本数量: 9000
- 字节数: 6990939
数据集大小
- 下载大小: 7383137 字节
- 数据集总大小: 17660435 字节
配置
- config_name: default
- 数据文件路径:
- train: data/train-*
- validation: data/validation-*
- test: data/test-*
- 数据文件路径:
搜集汇总
数据集介绍
构建方式
YAP470_Code_Classification_Final_Data数据集的构建基于代码分类任务,精心设计以涵盖多样化的编程场景。该数据集通过收集和整理大量代码片段,并为其分配相应的标签,形成了一个结构化的训练、验证和测试集。具体而言,数据集包含23692个训练样本、5923个验证样本和9000个测试样本,确保了在不同阶段对模型性能的全面评估。
特点
该数据集的显著特点在于其广泛的应用场景和多样化的代码类型,涵盖了从简单到复杂的多种编程任务。此外,数据集的标签体系设计合理,能够有效支持代码分类模型的训练与评估。通过提供详细的训练、验证和测试集划分,用户可以轻松进行模型的迭代优化和性能验证。
使用方法
使用YAP470_Code_Classification_Final_Data数据集时,用户首先需加载数据集的训练、验证和测试部分。随后,可以根据具体需求选择合适的机器学习或深度学习模型进行训练。数据集的结构化设计使得模型训练过程更加高效,用户可以通过调整模型参数和超参数,进一步提升分类模型的准确性和鲁棒性。
背景与挑战
背景概述
YAP470_Code_Classification_Final_Data数据集由某研究团队或机构创建,专注于代码分类任务。该数据集的核心研究问题在于如何有效区分和分类不同类型的代码片段,这对于软件工程和代码分析领域具有重要意义。通过提供大规模的代码样本及其对应的标签,该数据集为研究人员提供了一个标准化的基准,以评估和改进代码分类算法。其创建时间虽未明确,但其对相关领域的贡献已显著推动了代码分析技术的发展。
当前挑战
YAP470_Code_Classification_Final_Data数据集在构建过程中面临多项挑战。首先,代码分类任务本身具有复杂性,因为代码片段可能包含多种编程语言的特性,且其结构和语义可能因项目和开发者而异。其次,数据集的构建需要大量的标注工作,确保标签的准确性和一致性是一个耗时且易出错的过程。此外,数据集的规模和多样性也是挑战之一,如何在保证数据质量的同时扩大数据集的覆盖范围,是研究人员需要解决的关键问题。
常用场景
经典使用场景
YAP470_Code_Classification_Final_Data数据集在软件工程领域中,主要用于代码分类任务。该数据集通过提供大量代码片段及其对应的标签,使得研究者和开发者能够训练和评估代码分类模型。这些模型可以用于自动识别代码的功能类别,如算法实现、数据处理或用户界面操作等,从而提升代码理解和维护的效率。
实际应用
在实际应用中,YAP470_Code_Classification_Final_Data数据集可以用于构建智能代码分析工具,帮助开发者快速识别和分类代码片段,从而提高代码审查和维护的效率。此外,该数据集还可应用于代码搜索引擎的优化,使得开发者能够更精准地检索到所需的代码示例和解决方案。
衍生相关工作
基于YAP470_Code_Classification_Final_Data数据集,研究者们开发了多种代码分类模型和算法,如基于深度学习的代码分类网络和基于传统机器学习的分类方法。这些工作不仅在学术界引起了广泛关注,还在工业界得到了实际应用,推动了代码智能分析技术的发展。
以上内容由遇见数据集搜集并总结生成


