
samolego/OASST1-slovene
收藏官方服务:
资源简介:
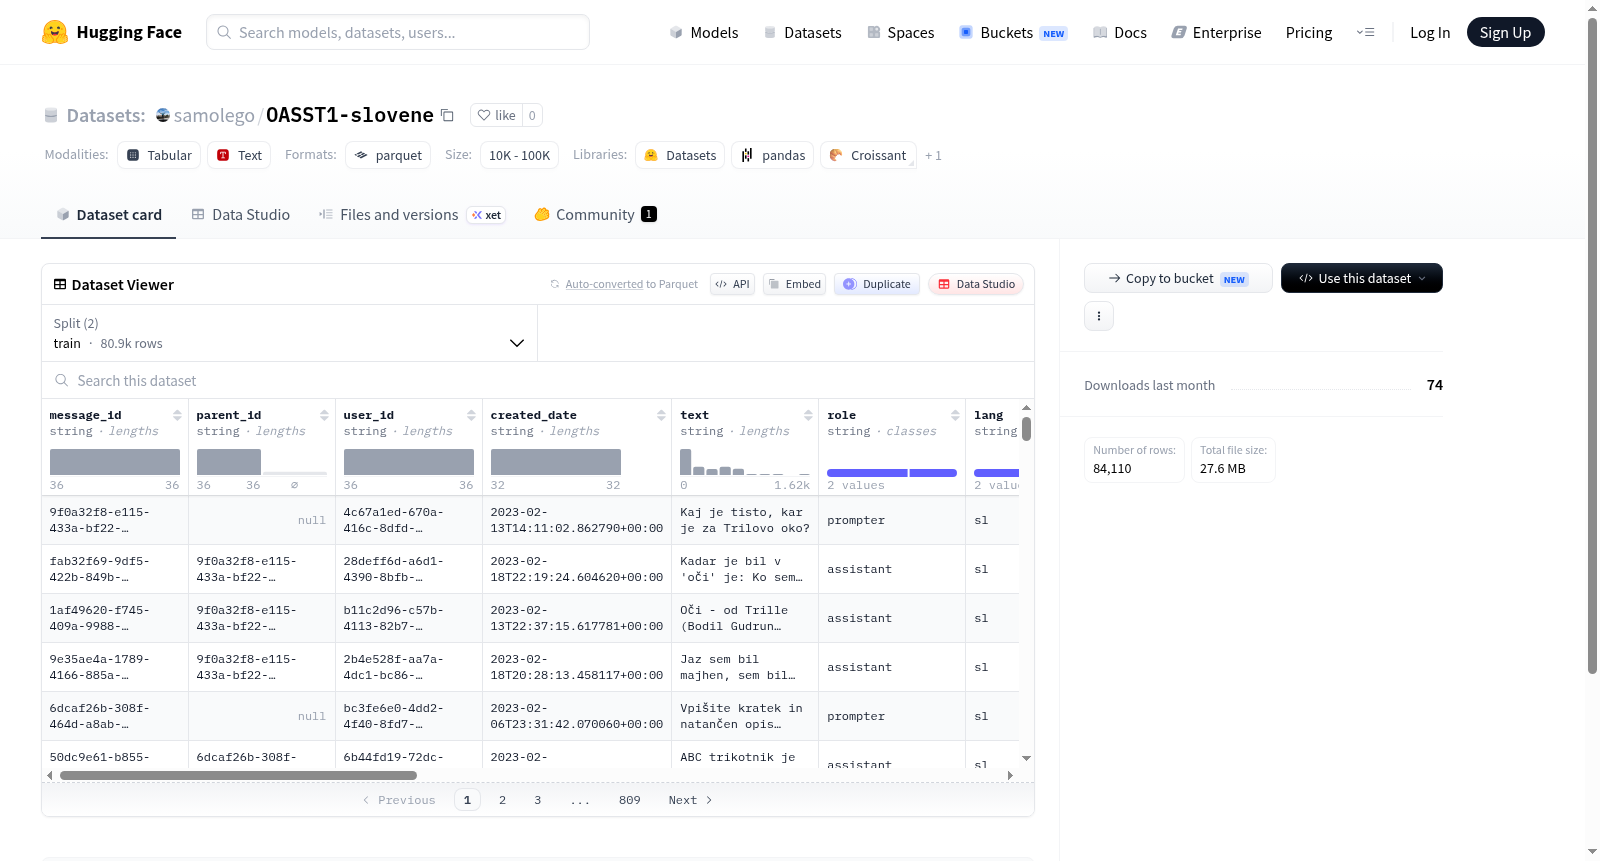
该数据集包含多种特征,如消息ID、用户ID、创建日期、文本内容等,以及结构化数据如detoxify(包含多个与毒性相关的指标)和emojis(表情符号的计数和名称)。数据集分为训练集和验证集,分别存储在不同的路径下,总数据集大小为83583958字节,下载大小为27643869字节。
This dataset includes multiple features, such as message ID, user ID, creation date, text content, etc., as well as structured data including detoxify (which contains multiple toxicity-related metrics) and emojis (counts and names of emojis). The dataset is split into training and validation sets, which are stored in separate paths. The total size of the full dataset is 83583958 bytes, while the download size is 27643869 bytes.
提供机构:
samolego原始信息汇总
数据集概述
数据集特征
- message_id: 字符串类型
- parent_id: 字符串类型
- user_id: 字符串类型
- created_date: 字符串类型
- text: 字符串类型
- role: 字符串类型
- lang: 字符串类型
- review_count: 整数类型
- review_result: 布尔类型
- deleted: 布尔类型
- rank: 浮点数类型
- synthetic: 布尔类型
- model_name: 空值类型
- detoxify: 结构类型,包含以下子特征:
- identity_attack: 浮点数类型
- insult: 浮点数类型
- obscene: 浮点数类型
- severe_toxicity: 浮点数类型
- sexual_explicit: 浮点数类型
- threat: 浮点数类型
- toxicity: 浮点数类型
- message_tree_id: 字符串类型
- tree_state: 字符串类型
- emojis: 结构类型,包含以下子特征:
- count: 序列整数类型
- name: 序列字符串类型
- labels: 结构类型,包含以下子特征:
- count: 序列整数类型
- name: 序列字符串类型
- value: 序列浮点数类型
数据集分割
- validation: 数据量3245条,占用空间3265400字节
- train: 数据量80865条,占用空间80318558字节
数据集大小
- 下载大小: 27643869字节
- 数据集总大小: 83583958字节
搜集汇总
数据集介绍
构建方式
在自然语言处理与对话系统研究领域,多语言高质量数据集的构建始终是推动模型泛化能力的关键。samolego/OASST1-slovene数据集源自Open Assistant项目,旨在提供斯洛文尼亚语的对话数据。该数据集通过众包方式收集,包含来自不同用户的对话树结构,每条消息记录了message_id、parent_id、user_id等元信息,以及文本内容、角色(如用户或助手)、语言标签等核心字段。数据经过审核机制,通过review_count、review_result和deleted字段过滤低质量内容,并利用detoxify模块对文本进行毒性检测,涵盖身份攻击、侮辱、色情等七个维度。最终数据划分为训练集(80865条)和验证集(3245条),以结构化格式存储。
特点
该数据集的核心特点在于其丰富的结构化标注与多维度质量保障机制。每条消息不仅包含对话层级关系(通过message_tree_id和parent_id体现),还记录了用户反馈(如rank评分、emojis情感标记)和审核结果(review_result)。特别地,detoxify字段提供了细粒度的毒性评分,为训练安全可控的对话模型提供了重要参考。此外,labels字段支持多分类标签体系,可辅助进行对话意图识别或情感分析。数据集的规模虽仅涵盖斯洛文尼亚语,但其完整的对话树结构和小语种稀缺性,使其在低资源语言对话系统研究中具有独特价值。
使用方法
使用该数据集时,研究者可直接通过HuggingFace的datasets库加载,指定配置为default后即可获取训练集和验证集。数据以parquet格式存储,支持高效读取。对于对话建模任务,可利用message_id和parent_id重建对话树结构,或将文本字段作为输入,结合role字段区分用户与助手的交互。在进行模型安全性评估时,可借助detoxify评分筛选低毒性样本。若需多标签分类训练,labels字段中的name和value可直接用于监督学习。此外,通过过滤deleted为False且review_result为True的条目,可获得高质量子集用于微调指令跟随模型。
背景与挑战
背景概述
在自然语言处理领域,多语言对话系统的构建依赖于高质量、多样化的指令数据。OASST1-slovene数据集是OpenAssistant项目的一部分,由全球志愿者社区于2023年创建,专注于斯洛文尼亚语的对话数据收集。该数据集的核心研究问题在于如何通过众包方式获取涵盖广泛主题的、经过人工标注的对话树,以支持低资源语言的指令微调与对齐研究。其影响力体现在为斯洛文尼亚语等小语种提供了首个大规模、结构化的开放对话数据集,填补了非英语语言在对话理解与生成任务上的数据空白,推动了多语言AI助手的公平性与包容性发展。
当前挑战
该数据集面临的核心挑战包括:其一,解决斯洛文尼亚语在对话生成与理解任务中的领域问题,即低资源语言缺乏充足的高质量训练数据,导致模型在文化特定表达、语法复杂性和语义多样性上表现欠佳。其二,构建过程中的挑战尤为突出,例如众包标注的质量控制,需依赖社区贡献者确保对话树的逻辑一致性与语言自然度;此外,数据集中包含毒性检测(如身份攻击、侮辱等)与情感标签的多维度标注,要求平衡标注准确性与标注者主观偏差,同时处理斯洛文尼亚语中特有的冒犯性表达识别难题。
常用场景
经典使用场景
在自然语言处理与对话系统研究领域,OASST1-slovene数据集作为斯洛文尼亚语高质量人机对话语料库,其经典使用场景集中于多轮对话建模与指令微调。该数据集包含超过8万条训练样本和3千余条验证样本,每条对话均标注了角色、时间戳、情感倾向及毒性评分等结构化信息,为构建面向低资源语言的对话生成模型提供了标准化训练基准。研究者常利用其树状对话结构与人工评分标签,开展对话质量评估与回复排序任务,尤其适合探索非英语语境下的语义理解与上下文连贯性建模。
实际应用
在实际应用中,OASST1-slovene数据集被广泛用于开发面向斯洛文尼亚语用户的智能客服、教育辅导及内容审核系统。例如,企业可基于该数据集微调对话模型,使其理解斯洛文尼亚语的日常表达习惯与地域文化背景,从而提升自动应答的准确性与用户满意度。此外,数据集中的毒性检测标签可直接用于训练社交媒体内容过滤算法,帮助平台识别并拦截歧视性、侮辱性言论。在公共服务领域,该数据还支撑了政府网站智能问答机器人的部署,显著降低了人工客服的响应成本。
衍生相关工作
基于OASST1-slovene数据集,学术界衍生出多项经典研究工作。其中最具代表性的是面向低资源语言的指令微调框架,研究者通过对比该数据集与英语OASST数据上的模型表现,提出了跨语言知识蒸馏方法,有效提升了小语种对话系统的生成质量。此外,该数据集被用于验证多任务学习范式在对话情感识别与毒性检测中的协同效应,催生了融合多标签分类的端到端对话评估模型。在数据增强领域,有工作利用其树状结构生成合成对话分支,通过半监督学习进一步扩充了训练规模,为低资源对话系统的鲁棒性优化开辟了新路径。
以上内容由遇见数据集搜集并总结生成


