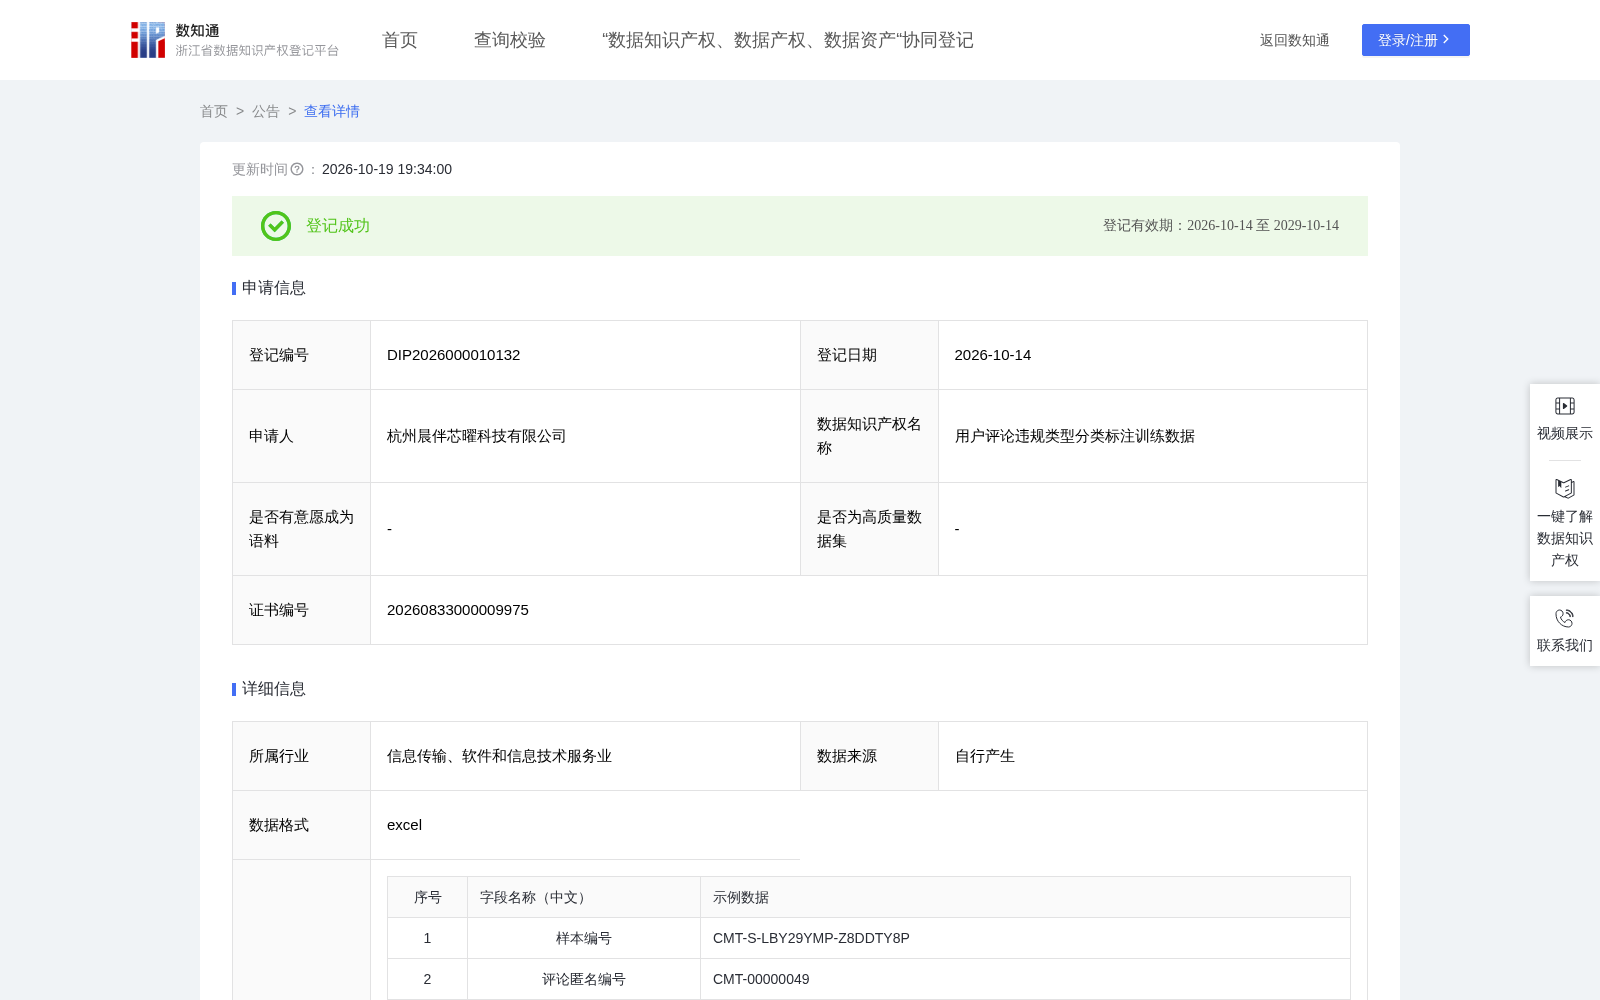
用户评论违规类型分类标注训练数据
收藏资源简介:
本数据面向内容社区、电商平台和品牌商家评论区治理场景,适用于识别辱骂攻击、色情低俗、违法交易、个人隐私、引流广告和虚假信息等评论。通过文本标准化、敏感信息识别和违规规则匹配,形成可回查的违规证据与类型标签,为评论审核、风险筛查和分类模型训练提供结构化数据。使用时需提供经过合法收集和去标识化处理的评论文本,并按照同一违规分类口径使用。数据使用方可结合去标识化标准评论文本、规则命中结果、连续证据片段及其字符位置评价不同违规类型的识别效果,训练文本分类和证据定位模型,并利用正常评论检验非违规内容的区分能力。一、加工前的数据说明: 原始数据来源于企业自有内容平台或电商评价区评论文本,原始字段包括记录编号、用户编号、内容类别和原始评论文本。用户及评论编号改为匿名编码,直接身份信息经去标识化处理。 二、处理规则: 1.数据清洗:按评论记录编号去重,删除文本缺失及无关记录;替换评论中的直接身份信息,统一字符编码、全半角符号、标点和空白符,形成去标识化标准评论文本。 2.算法标注:对去标识化标准评论文本分词切分,再以辱骂攻击、色情低俗、违法交易、个人隐私、引流广告和虚假信息六类规则库匹配词语组合及上下文表达。命中规则时形成对应的规则命中结果和评论违规类型;多处文本同时符合规则时,以能够直接说明违规性质的连续片段作为主要判定依据。未命中六类违规规则的记录标注为正常,并将规则命中结果记为未命中。最终类型包括正常、辱骂攻击、色情低俗、违法交易、个人隐私、引流广告和虚假信息。 3.证据定位:在去标识化标准评论文本中定位支持判定的连续证据片段;证据起始位置从0开始,证据结束位置采用左闭右开区间,使文本按起止位置截取的内容与违规证据片段脱敏值一致。正常评论的证据片段及两个位置字段统一记为“-”。 4.算法校验:逐条验证证据片段等于对应字符区间,并核对规则命中结果与违规类型。以去标识化标准评论文本作为核心文本签名,相同签名仅保留一条;同一文本存在多个可用证据片段时,优先保留能够较完整说明违规性质的连续片段,长度相同时保留位置靠前的片段。按用户匿名编号和去标识化标准评论文本联合分组,约8:1:1划分训练集、验证集和测试集,避免同一用户或相同评论文本跨集合出现。 三、数据内容描述: 最终形成结构化数据集合,包含以下字段:1)样本编号:样本匿名唯一标识;2)评论匿名编号:评论去标识化编号;3)用户匿名编号:用户去标识化编号;4)内容类别:商品评论区;5)去标识化标准评论文本:删除直接身份信息并完成编码、标点和空白符统一后的评论;6)违规证据片段脱敏值:支持违规判定的连续文本片段;7)证据起始位置:证据片段在去标识化标准评论文本中的起始字符位置;8)证据结束位置:证据片段左闭右开区间的结束位置;9)规则命中结果:违规规则命中情况;10)评论违规类型:正常、辱骂攻击、色情低俗、违法交易、个人隐私、引流广告或虚假信息;11)数据集划分标识:训练集、验证集或测试集。