
遇见数据集

GlyphByT5/GlyphByT5Pretraining

收藏
Hugging Face2024-07-10 更新2024-06-22 收录
官方服务:

资源简介:

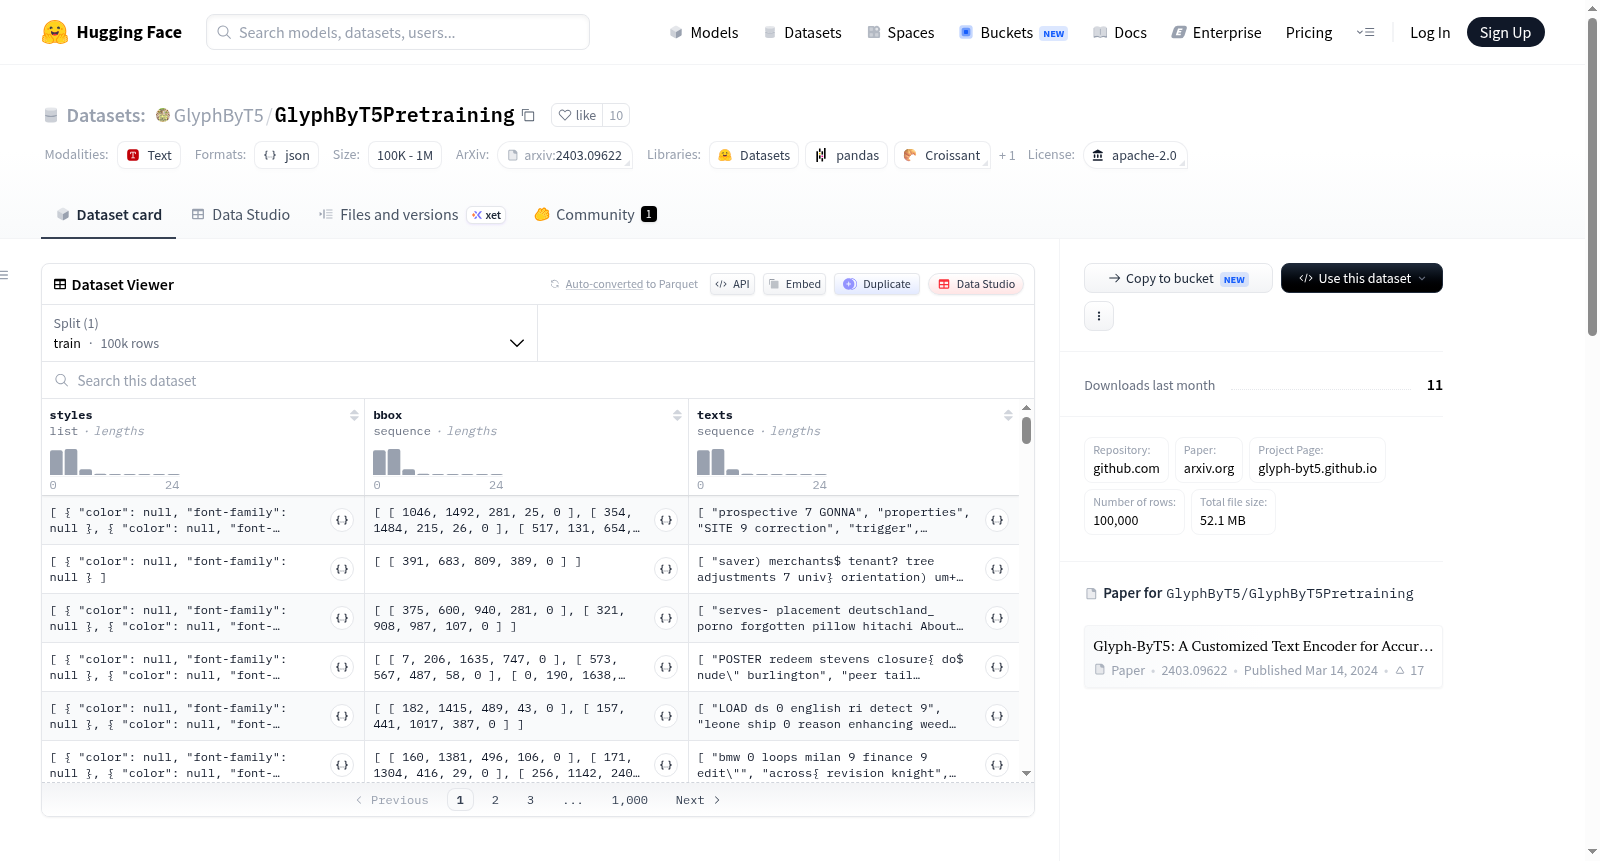
GlyphByT5Pretraining数据集包含用于Glyph-ByT5模型预训练阶段的100,000个排版数据标注,这些标注可用于生成视觉文本。数据集结构包括一个JSON文件,其中每个标注包含文本、样式(颜色和字体家族)和边界框信息。

GlyphByT5Pretraining数据集包含用于Glyph-ByT5模型预训练阶段的100,000个排版数据标注,这些标注可用于生成视觉文本。数据集结构包括一个JSON文件,其中每个标注包含文本、样式(颜色和字体家族)和边界框信息。

提供机构:
GlyphByT5
原始信息汇总

数据集卡片 for GlyphByT5Pretraining

数据集概述

该数据集包含用于Glyph-ByT5中引入的字形对齐预训练阶段的数据。数据集包含100K排版数据注释,可用于渲染视觉文本。

数据集来源

  • 仓库: [https://github.com/AIGText/Glyph-ByT5]
  • 论文: [https://arxiv.org/abs/2403.09622]
  • 项目页面: [https://glyph-byt5.github.io/]

数据集结构

数据集包含一个json文件,其中包含详细注释。每个注释的组织结构如下:

json { "texts": [ "text string 1", "text string 2", ... "text string k" ], "styles": [ { color: color 1, # 一个表示颜色的十六进制代码 font-family: font 1 # 表示字体的字体代码 }, { color: color 2, font-family: font 2 }, ... { color: color k, font-family: font k }, ], "bbox": [ [x1, y1, w1, h1, a1], # 绝对坐标在[0, 1645]之间 [x2, y2, w2, h2, a2], ... [xk, yk, wk, hk, ak] ] }

使用

更多详细信息请参阅我们的论文项目页面

引用

如果您发现我们的工作对您的研究有用,请考虑引用:

plaintext @misc{liu2024glyphbyt5, title={Glyph-ByT5: A Customized Text Encoder for Accurate Visual Text Rendering}, author={Zeyu Liu and Weicong Liang and Zhanhao Liang and Chong Luo and Ji Li and Gao Huang and Yuhui Yuan}, year={2024}, eprint={2403.09622}, archivePrefix={arXiv}, primaryClass={cs.CV} }
搜集汇总
数据集介绍
GlyphByT5/GlyphByT5Pretraining 数据集图片
构建方式
GlyphByT5Pretraining数据集是为Glyph-ByT5视觉文本渲染模型定制的预训练数据资源。该数据集以JSON格式存储注释文件,组织为字典列表形式,每个字典包含三个核心字段:'texts'字段记录渲染所需的文本序列,'styles'字段存储每个文本对应的字体族与颜色属性(其中颜色与字体族在预训练阶段被设为空值,由数据加载代码随机填充),'bbox'字段则定义每个文本的边界框坐标,包括位置、尺寸及旋转角度。数据集附带了100种具有免费商业使用许可的字体子集,确保了构建过程的合法性与实用性。
特点
该数据集最显著的特点在于其灵活性与可扩展性。通过将字体与颜色作为随机变量处理,数据集能够模拟真实世界中视觉文本的多样性,增强了模型对字体风格与色彩变化的鲁棒性。同时,边界框的旋转角度参数支持对倾斜文本的建模,拓展了文本渲染的空间自由度。此外,数据集采用结构化的JSON格式,便于研究人员根据需求定制数据加载流程,而公开的字体子集则降低了复现门槛,促进了学术交流与工业应用。
使用方法
使用该数据集时,需配合Glyph-ByT5模型的预训练代码。用户可直接加载JSON注释文件,通过解析字典中的'texts'、'styles'与'bbox'字段构建训练样本。由于颜色与字体族在注释中预设为空,实际应用中应调用数据加载器随机分配这些属性,以充分发挥数据集的设计优势。建议结合官方仓库提供的字体文件与示例代码,确保数据流水线的正确性。该数据集适用于PyTorch等主流深度学习框架,便于集成至现有文本渲染或图像生成项目中。
背景与挑战
背景概述
在视觉文本渲染领域,精准生成包含复杂字形与排版细节的图像始终是一项艰巨挑战。GlyphByT5Pretraining数据集由微软亚洲研究院联合清华大学、北京大学及澳大利亚国立大学的研究团队于2024年创建,核心研究人员包括刘泽宇、梁伟聪等。该数据集旨在解决扩散模型在文本到图像生成中普遍存在的字符变形、笔画缺失等视觉文本渲染失真问题,为Glyph-ByT5模型提供定制化的预训练语料。通过引入包含字体、颜色及空间位置标注的结构化文本图像对,该数据集推动了文本编码器与图像生成器的深度耦合,显著提升了多语言视觉文本渲染的准确性与美观度,为广告设计、数字内容创作等应用场景奠定了数据基础。
当前挑战
当前数据集面临的核心挑战首先在于视觉文本渲染的领域难题:现有生成模型难以精准控制字形拓扑结构,尤其在处理中文字符等复杂笔画系统时,易出现笔画断裂、部件错位等结构性错误。其次,数据集构建过程中面临字体多样性不足与版权限制的困境,尽管已收录100款免费商用字体,但覆盖的字符集与字体风格仍远不能满足现实应用需求。此外,颜色与字体属性的随机采样策略虽增强了数据多样性,却导致标注一致性难以保障,可能引入噪声干扰模型训练。这些挑战共同制约着Glyph-ByT5模型在工业级视觉文本生成任务中的泛化能力与可靠性。
常用场景
经典使用场景
GlyphByT5Pretraining数据集专为视觉文本渲染任务而生,其核心应用在于训练Glyph-ByT5文本编码器,以精准生成包含复杂字形与排版的图像。该数据集通过提供丰富的文本内容、随机化的字体与颜色属性,以及精确的边界框注释,使模型能够学习从文本语义到视觉形态的映射关系。研究人员常利用此数据集进行多字形、多风格的文本图像生成训练,从而提升扩散模型在广告设计、海报制作等场景中对文本元素的渲染准确度。
衍生相关工作
GlyphByT5Pretraining数据集衍生了一系列经典工作,包括Glyph-ByT5文本编码器本身,该编码器被集成到Stable Diffusion等主流生成框架中,实现了对任意字体和颜色的精准渲染。后续研究如GlyphDraw与TextDiffuser借鉴其数据构建思路,进一步探索了多行文本、艺术字特效等复杂场景。此外,该数据集催生了针对中文、日文等复杂字符集的专用编码器优化工作,推动了视觉文本渲染在非拉丁语系语言中的突破,并成为评估生成模型文本保真度的基准测试之一。
数据集最近研究
最新研究方向
GlyphByT5/GlyphByT5Pretraining数据集专注于视觉文本渲染的前沿研究,尤其在多模态生成模型中,精确的文字生成是当前热点。该数据集通过定制化文本编码器,解决了传统扩散模型或自回归模型中文本模糊、变形等痛点,与近期AI图像生成(如DALL-E 3、Stable Diffusion 3)对高质量文本渲染的迫切需求紧密相关。其预训练数据包含字体、颜色、位置等精细标注,支持在复杂场景下生成清晰、风格一致的文本,推动了文本到图像生成在广告、海报设计等实际应用中的精准性和可控性。这一研究不仅提升了生成内容的可读性与美感,还为跨语言、多字体视觉文本渲染奠定了坚实基础,对数字内容创作和自动化设计领域具有深远影响。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

