
遇见数据集

LiuHongwei1992/520634PatentsDataset

收藏
Hugging Face2026-05-29 更新2026-05-31 收录
官方服务:

资源简介:

这是一个包含520,634项中国发明专利和实用新型专利的采样数据集,用于PatentConceptor系统——一个基于专利的跨领域设计概念生成工具。数据集覆盖了1985年至2024年的专利申请年份,通过分层随机采样方法从中国国家知识产权局(CNIPA)约3329万专利全集中提取,确保了在年份、国际专利分类(IPC)部分(A-H部)以及专利类型(发明与实用新型)之间的均衡覆盖。数据以CSV格式提供,包含专利名称、专利类型、摘要文本、国际专利分类号、申请人类型、申请年份、申请人城市、IPC主分类号、IPC部类信息和采样年份标签等字段。数据集支持直接通过Hugging Face的datasets库加载,也可用于本地部署。

A sampled dataset of 520,634 Chinese invention and utility model patents used for the PatentConceptor system — a patent-based cross-domain design concept generation tool. The dataset spans application years from 1985 to 2024 and is created via stratified random sampling from the full corpus of approximately 33.29 million patents from the China National Intellectual Property Administration (CNIPA), ensuring proportional coverage across years, all 8 IPC sections (A–H), and a balance between invention patents and utility models. It is provided in CSV format with fields including patent title, patent type, abstract text, IPC classification, applicant type, application year, applicant city, primary IPC, IPC section info, and sampling year label. The dataset can be loaded directly using Hugging Faces datasets library or used for local deployment.
提供机构:
LiuHongwei1992
搜集汇总
数据集介绍
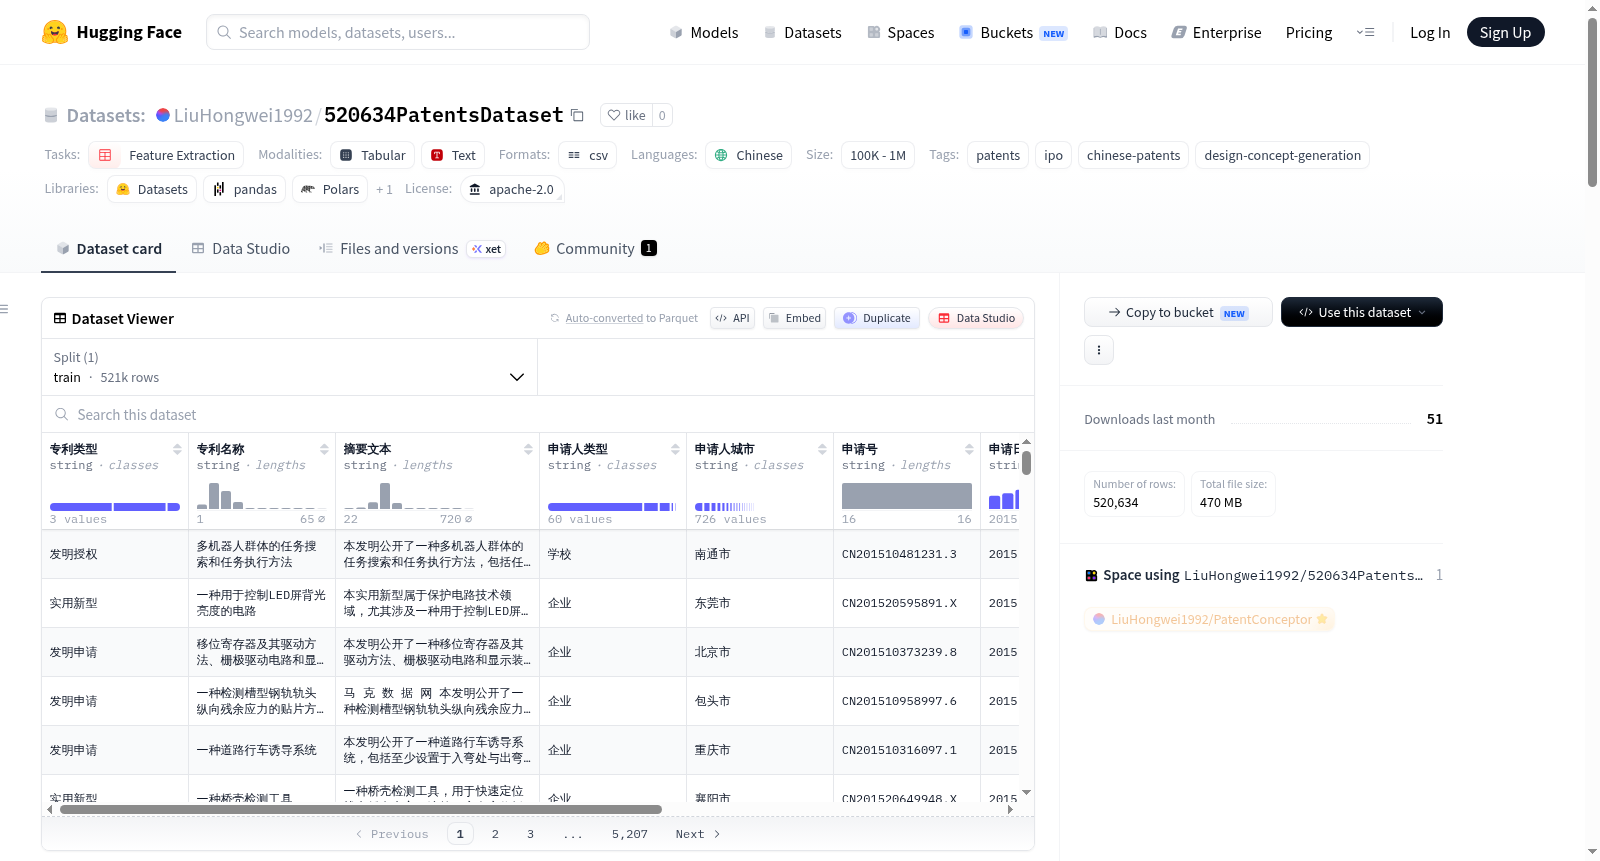
LiuHongwei1992/520634PatentsDataset 数据集图片
构建方式
该数据集源自中国国家知识产权局(CNIPA)庞大的专利数据库,其原始语料库包含约3329万条专利记录。为确保样本的代表性与均衡性,研究团队采用了分层随机抽样策略进行构建。具体而言,抽样过程同时依据申请年份、国际专利分类(IPC)的八个部类(A至H)以及专利类型(发明专利与实用新型)三个维度进行分层,从而从海量数据中提取出520,634条高质量的中文专利样本,形成了本数据集。这一方法有效避免了单一维度抽样可能带来的偏差,确保了样本在时间跨度、技术领域分布及专利类型上的全面覆盖。
特点
本数据集的显著特点在于其规模适中且结构精良,共包含520,634条中国发明与实用新型专利记录,时间跨度从1985年至2024年,覆盖了近四十年的技术创新历程。数据以CSV格式存储,提供了十项关键字段,包括专利名称、类型、摘要文本、完整的IPC分类号、申请人类型与城市、以及申请年份等,信息维度丰富。尤为重要的是,数据集在构建时已完成了IPC部类信息的解析与采样年份标签的添加,为后续的跨领域分析与时序研究奠定了坚实基础。其分层抽样的设计确保了样本在各个技术领域(A至H部)和不同年份间的分布均衡,极大提升了数据的代表性。
使用方法
该数据集的使用方式灵活便捷,主要支持两种途径。首先,用户可直接通过Hugging Face的datasets库进行加载,仅需调用一行代码即可将全部数据读取为便于操作的Dataset对象,极大简化了数据预处理流程。其次,针对需要本地部署的专利概念生成系统PatentConceptor,用户可通过huggingface-cli工具或Python脚本将CSV文件下载至指定目录,并替换应用配置文件中的路径,即可无缝集成。值得注意的是,数据集还提供了不同子集的内存需求参考,用户可根据硬件条件(如RAM大小)灵活选择10K、100K或完整的520K样本进行实验,兼顾了开发测试与大规模研究的实际需求。
背景与挑战
背景概述
520634PatentsDataset是由Liu Hongwei于2025年创建的一个大规模中文专利数据集,其核心研究问题在于支持跨领域设计概念生成系统PatentConceptor的开发。该数据集抽样自中国国家知识产权局(CNIPA)约3329万件专利库,涵盖1985至2024年间的中文发明专利与实用新型专利,总计520,634件。通过引入分层随机抽样策略,数据集确保了在申请年份、国际专利分类(IPC)八个部类以及专利类型上的全面覆盖,为专利知识驱动的产品概念创新提供了高质量语料基础。作为专利分析与自然语言处理交叉领域的重要资源,该数据集有效推动了设计自动化与知识图谱在工业创新中的应用,其规模与结构化特征使其在相关研究中具有显著影响力。
当前挑战
该数据集所应对的领域挑战在于,传统产品设计概念生成往往依赖经验或有限领域知识,缺乏跨领域专利知识的系统性融合与利用;专利文本的庞大规模与专业术语也限制了其在机器学习模型中的直接使用。在构建过程中,面临的挑战包括:从超过三千万件专利中高效实施年份、IPC和专利类型的分层随机抽样,以确保代表性并避免数据偏差;清理与规范化非结构化专利摘要、IPC分类号及申请人信息等字段,使其适用于建模;以及管理520,634份样本约需16 GB内存的高计算资源需求,在兼顾数据完整性的同时实现可行的加载与处理效率。
常用场景
经典使用场景
520634PatentsDataset汇聚了逾52万份中国发明专利与实用新型专利,覆盖1985年至2024年间全部八个IPC部类,在跨领域设计概念生成领域堪称奠基性资源。基于分层随机抽样策略对近3300万份中国专利进行精细筛选,该数据集确保了时间跨度、技术领域与专利类型的全面均衡。经典使用场景包括驱动PatentConceptor系统——一种基于专利知识的跨域设计概念生成工具,利用海量专利摘要与IPC分类信息实现创新想法的激发与融合。研究者通过分析专利名称、摘要文本及其分类号,识别不同技术领域间的潜在关联,进而生成跨行业的产品概念,为设计阶段的早前期创意发散提供数据驱动的决策支持。
解决学术问题
该数据集的核心价值在于破解设计领域中概念生成高度依赖专家经验的瓶颈,为自动化创意激发提供了可复现的实证基础。在专利分析与创新管理研究中,520634PatentsDataset解决了跨领域知识迁移的量化难题——传统方法常受限于样本规模与分类覆盖度,难以捕捉不同IPC部类之间的隐性联系。该数据集的问世推动了数据驱动设计理论的发展,使研究者能够从大规模专利文本中挖掘技术演变规律与创新模式,验证设计概念生成的统计学意义,并为自然语言处理在工程设计领域的应用开辟了新的实验范式。
衍生相关工作
围绕该数据集已衍生出多项具有影响力的学术工作,其中最具代表性的是PatentConceptor系统——一个利用大语言模型与专利知识进行设计概念生成的创新框架,其论文已在相关领域引起广泛关注。该数据集还支撑了多项关于专利文本表示学习与跨领域技术预测的研究,例如基于专利摘要的语义嵌入训练、IPC分类树结构下的知识图谱构建以及创新扩散路径的图神经网络建模。这些工作共同推动了专利情报分析从传统统计方法向深度学习范式的转型,为后续研究者在计算机辅助创新、技术演化分析及智能专利检索等方向提供了可参照的实验基准与数据基础。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

