HVUE-v2
收藏资源简介:
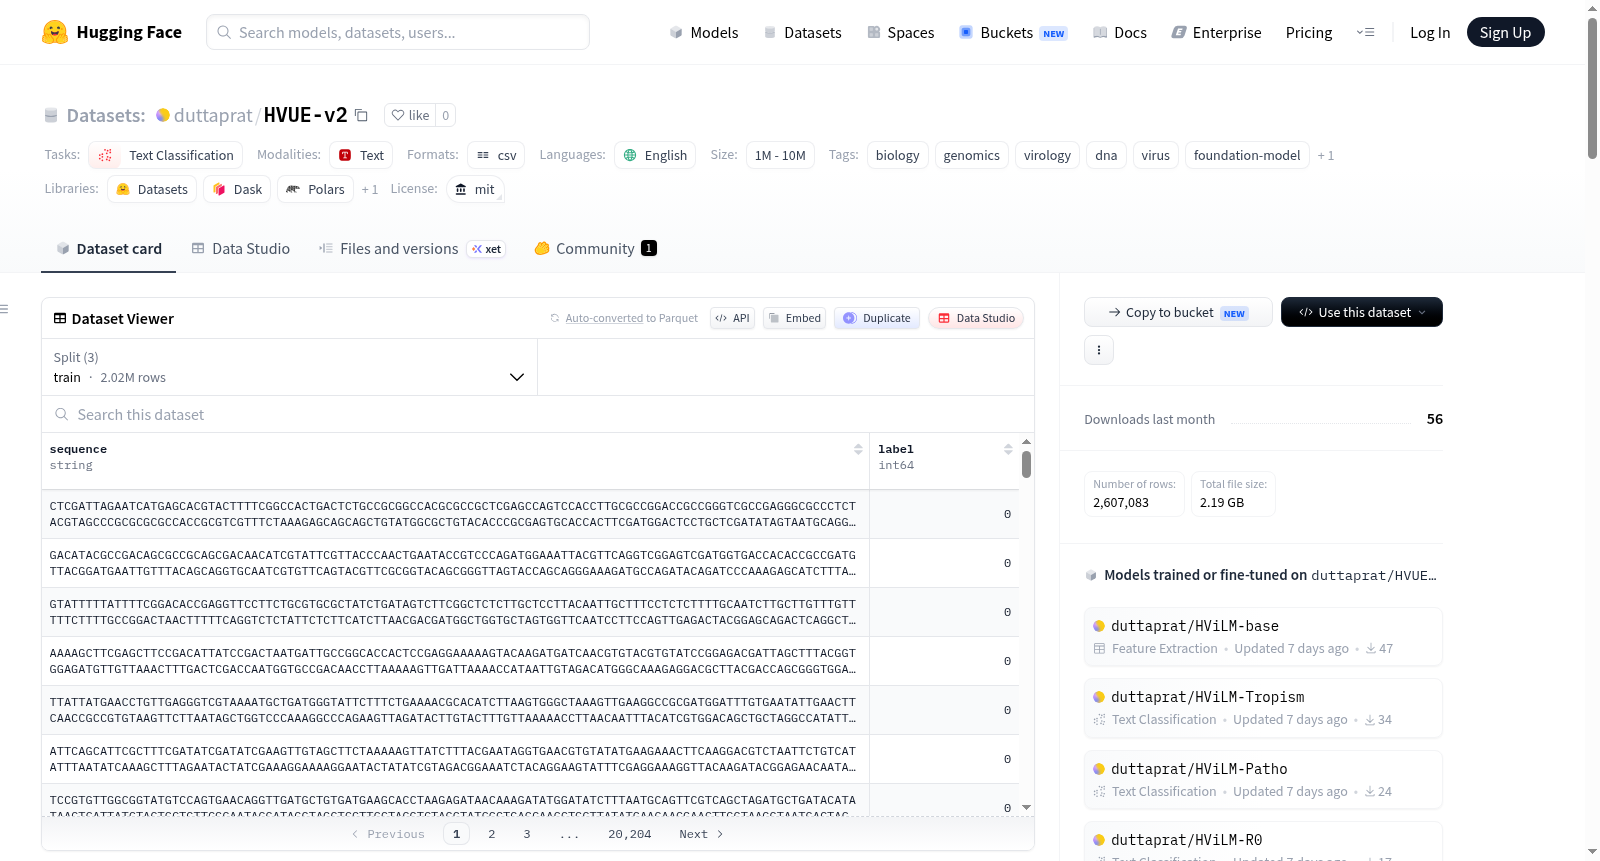
HVUE v2(人类病毒组理解评估基准)是一个用于评估DNA语言模型在病毒基因组学任务中表现的基准数据集。该数据集专注于三个具有流行病学意义的分类任务:致病性分类(区分致病性与良性病毒株)、传播性预测(基于R₀值的二元分类,R₀<1 vs R₀≥1)以及宿主趋向性预测(识别感染人类的病毒与非人类趋向病毒)。HVUE v2通过一个六阶段流水线构建,包括基因组合并与去重、MMseqs2聚类(95%或70%相似度)、聚类感知的数据划分(70/15/15训练/验证/测试分割,确保同一聚类内所有序列进入同一分割)、固定长度窗口分块(500/1000/2000 bp)、SHA-256哈希精确去重以及自动泄漏审计,从而彻底消除了版本1中存在的训练-测试重叠问题。数据集按任务和配置组织为多个子集,例如致病性任务包含standard_capped_500bp、standard_capped_1000bp、standard_capped_2000bp、hard_capped_1000bp和standard_temporal_1000bp等配置;传播性任务具有类似配置;宿主趋向性任务则包含standard_95_500bp、standard_95_1000bp、standard_95_2000bp和hard_70_1000bp配置。每个子集下包含train.csv、dev.csv和test.csv文件,每行包含两列:sequence(DNA序列,由A/T/G/C组成)和label(二元标签0或1)。所有配置均经过验证,确认无任何精确匹配或近似匹配的泄漏。该数据集适用于训练和评估面向病毒基因组学的DNA基础模型,如HViLM。
HVUE v2 (Human Virome Understanding Evaluation Benchmark) is a benchmark dataset designed to evaluate the performance of DNA language models on viromics tasks. It focuses on three classification tasks of epidemiological significance: pathogenicity classification (distinguishing between pathogenic and benign viral strains), transmissibility prediction (binary classification based on R₀ value, R₀<1 vs R₀≥1), and host tropism prediction (identifying human-infecting viruses vs. non-human tropic viruses). HVUE v2 is constructed through a six-stage pipeline including genome assembly and deduplication, MMseqs2 clustering (at 95% or 70% similarity), cluster-aware data splitting (70/15/15 train/validation/test split ensuring all sequences from the same cluster go to the same split), fixed-length window chunking (500/1000/2000 bp), SHA-256 hash exact deduplication, and automatic leakage auditing, thereby completely eliminating training-test overlap issues present in version 1. The dataset is organized into multiple subsets by task and configuration. For example, the pathogenicity task includes configurations such as standard_capped_500bp, standard_capped_1000bp, standard_capped_2000bp, hard_capped_1000bp, and standard_temporal_1000bp; the transmissibility task has similar configurations; the host tropism task includes configurations such as standard_95_500bp, standard_95_1000bp, standard_95_2000bp, and hard_70_1000bp. Each subset contains train.csv, dev.csv, and test.csv files, with each row having two columns: sequence (DNA sequence composed of A/T/G/C) and label (binary label 0 or 1). All configurations have been validated to have no exact or approximate match leakage. This dataset is suitable for training and evaluating DNA foundation models for viromics, such as HViLM.
HVUE v2: 人类病毒组理解评估基准(Human Virome Understanding Evaluation Benchmark)
数据集概述
HVUE v2 是一个为评估 DNA 语言模型而严格构建的基准数据集,聚焦于三个具有流行病学相关性的病毒预测任务。该数据集为 HVUE 基准的第二版,相比第一版(存在训练-测试序列重叠问题),v2 通过聚类感知划分进行了修正,并验证了零泄漏。
核心任务
- 致病性分类(Pathogenicity Classification):区分致病病毒株与非致病病毒株
- 传播性预测(Transmissibility Prediction):基于 R₀ 值的二分类(R₀ < 1 与 R₀ ≥ 1)
- 宿主嗜性预测(Host Tropism Prediction):识别可感染人类的病毒与非人类嗜性病毒
六阶段构建流程
- 整合:收集源基因组并在基因组水平去重
- MMseqs2 聚类:在 95% 同一性(标准)或 70% 同一性(严格)下进行基因组聚类
- 聚类感知划分:在簇级别进行训练/验证/测试划分(70/15/15),同一簇内所有序列归入同一划分
- 分块:划分后将基因组切割为固定长度窗口(500/1000/2000 bp)
- 去重:基于 SHA-256 哈希在划分内部进行精确匹配去重
- 泄漏审计:自动验证跨划分零重叠
与 v1 的关键改进:v1 先分块后随机划分,v2 先以聚类级别划分再分块。
数据集配置
致病性分类配置
| 配置名称 | 描述 |
|---|---|
standard_capped_500bp |
标准泄漏控制基准,500-bp 片段 |
standard_capped_1000bp |
标准泄漏控制基准,1000-bp 片段 |
standard_capped_2000bp |
标准泄漏控制基准,2000-bp 片段 |
hard_capped_1000bp |
更严格的硬划分基准,1000-bp 片段 |
standard_temporal_1000bp |
时间基准,1000-bp 片段 |
传播性预测配置
| 配置名称 | 描述 |
|---|---|
standard_capped_500bp |
标准泄漏控制基准,500-bp 片段 |
standard_capped_1000bp |
标准泄漏控制基准,1000-bp 片段 |
standard_capped_2000bp |
标准泄漏控制基准,2000-bp 片段 |
hard_capped_1000bp |
更严格的硬划分基准,1000-bp 片段 |
standard_temporal_1000bp |
时间基准,1000-bp 片段 |
宿主嗜性预测配置
| 配置名称 | 描述 |
|---|---|
standard_95_500bp |
95% 聚类感知基准,500-bp 片段 |
standard_95_1000bp |
95% 聚类感知基准,1000-bp 片段 |
standard_95_2000bp |
95% 聚类感知基准,2000-bp 片段 |
hard_70_1000bp |
70% 聚类感知严格基准,1000-bp 片段 |
注:宿主嗜性预测不提供时间划分(源数据缺乏采集日期元数据)。
数据格式
数据集目录结构按任务划分,每个配置目录下包含 train.csv、dev.csv 和 test.csv 文件。每个 CSV 文件包含两列:
sequence:DNA 序列(A/T/G/C)label:二分类标签(0 或 1)
数据质量保证
所有配置均已确认在跨划分间实现零精确匹配或近似匹配重叠。审计脚本可通过相关资源获取。
数据集信息
- 许可证:MIT License
- 语言:英语
- 任务类别:文本分类
- 标签:生物学、基因组学、病毒学、DNA、病毒、基础模型、基准
相关资源
- HViLM 模型权重:https://huggingface.co/duttaprat/HViLM-base
- 代码仓库:https://github.com/duttaprat/HViLM
- HVUE v1(已弃用):https://huggingface.co/datasets/duttaprat/HVUE
引用信息
bibtex @article{dutta2026hvilm, title={HViLM: A foundation model for viral genomics enables multi-task prediction of pathogenicity, transmissibility, and host tropism}, author={Dutta, Pratik and Vaska, Jack and Surana, Pallavi and Sathian, Rekha and Chao, Max and Zhou, Zhihan and Liu, Han and Davuluri, Ramana V}, journal={bioRxiv}, pages={2026--03}, year={2026}, publisher={Cold Spring Harbor Laboratory} }