
遇见数据集

nikitamounier/swe-bench-verified-raw-traces-qwen3-coder

收藏
Hugging Face2026-05-27 更新2026-05-31 收录
官方服务:

资源简介:

该数据集包含来自20250802_mini-v1.0.0_qwen3-coder-480b-a35b-instruct模型的原始mini-SWE-agent轨迹,用于SWE-bench Verified。其中,raw/easy分割使用了来自公开数据集parsaidp/SWE-bench_Verified_easy的194个实例ID,但轨迹内容是本地的mini-SWE-agent/Qwen轨迹,而非原始数据集的问题和答案。数据集提供原始轨迹JSONL文件以及桥接格式(Megatron Bridge vlm-preloaded)的数据,用于训练、验证和测试。

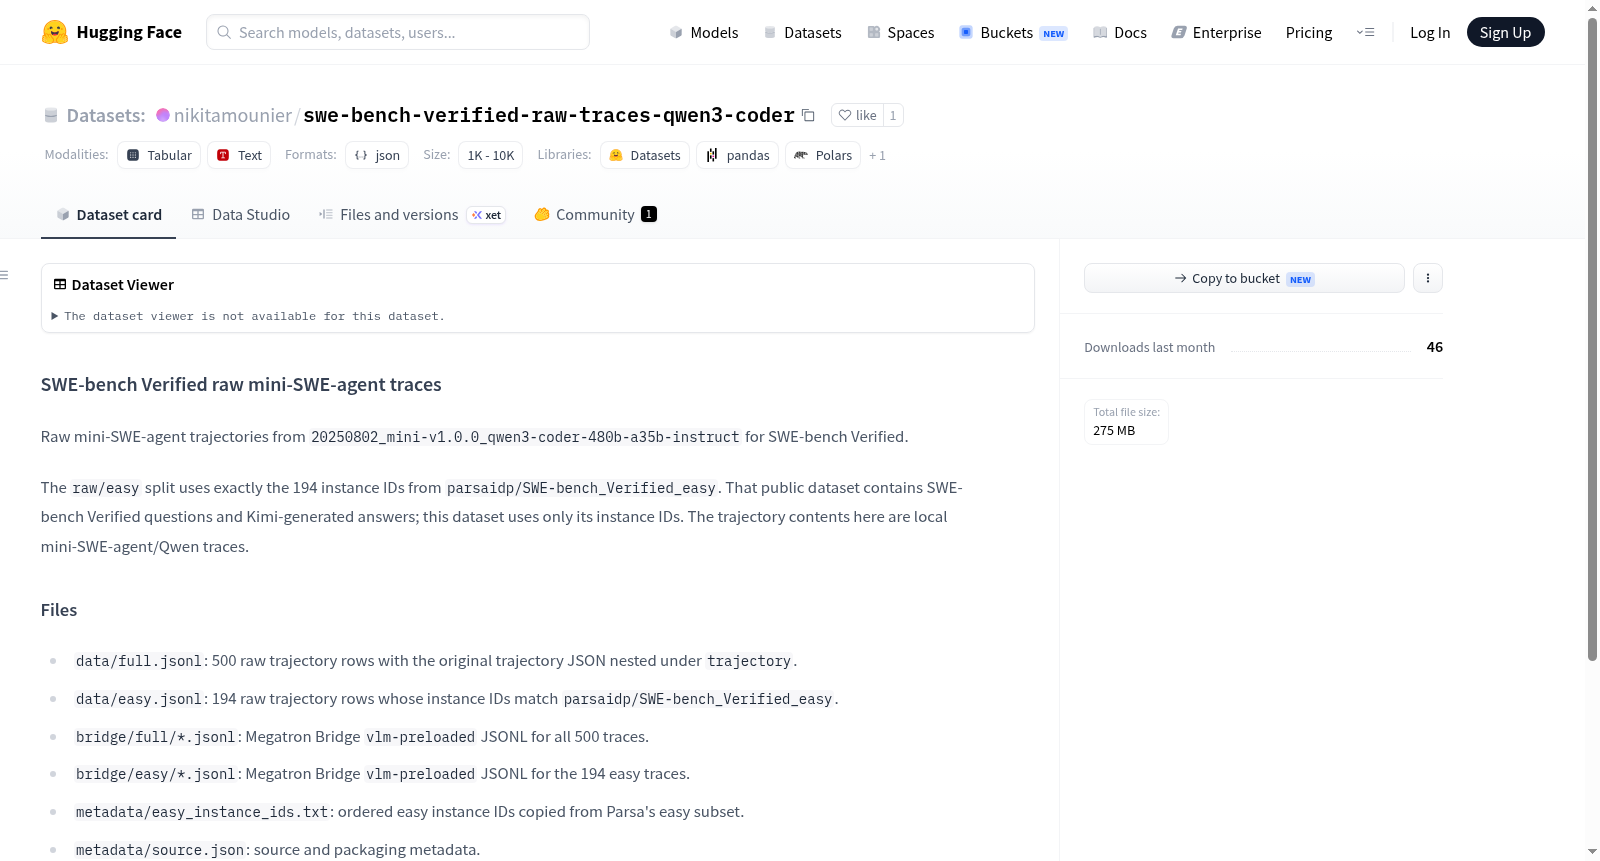
This dataset contains raw mini-SWE-agent trajectories from the model 20250802_mini-v1.0.0_qwen3-coder-480b-a35b-instruct for SWE-bench Verified. The raw/easy split uses 194 instance IDs from the public dataset parsaidp/SWE-bench_Verified_easy, but the trajectory content consists of local mini-SWE-agent/Qwen traces, not the original questions and answers. It provides raw trajectory JSONL files and bridge format (Megatron Bridge vlm-preloaded) data for training, validation, and testing.
提供机构:
nikitamounier
搜集汇总
数据集介绍
nikitamounier/swe-bench-verified-raw-traces-qwen3-coder 数据集图片
构建方式
该数据集基于Qwen3 Coder-480B-A35B-Instruct模型生成的mini-SWE-agent轨迹构建而成,时间戳为20250802_mini-v1.0.0。原始轨迹数据来源于SWE-bench Verified基准测试,共包含500条完整轨迹,存储于data/full.jsonl文件中。此外,数据集从中抽取了194条实例ID与parsaidp/SWE-bench_Verified_easy子集一致的轨迹,形成easy子集,存放于data/easy.jsonl。为便于不同场景使用,数据还提供了Megatron Bridge格式的vlm-preloaded JSONL文件,分为bridge_full和bridge_easy两个配置,每个配置下均包含训练、验证和测试三个标准分割,其中验证和测试集为确定性小样本,主要用于管道测试与评估。
特点
该数据集的核心特点在于其原始轨迹直接来源于Qwen3 Coder模型在SWE-bench Verified任务上的真实推理过程,而非合成或人工标注数据,具有高度的生态真实性和可复现性。easy子集专门筛选了经过验证的简单实例,降低了评估难度,便于调试和模型能力基线分析。数据集的存储结构清晰,同时提供原始JSONL格式和Megatron Bridge格式,兼顾了直接使用与大规模分布式训练的需求。Bridge分割保留了全部样本在训练集中,验证和测试集则采用确定性采样,确保评估的可重复性。此外,相关元数据文件如easy实例ID列表和来源信息也被附带提供,方便用户追溯与定制。
使用方法
使用者可通过HuggingFace Datasets库加载该数据集,利用config_name参数选择raw、bridge_full或bridge_easy等不同配置。raw配置适合直接获取原始轨迹数据进行可视化或轨迹分析,而bridge配置则适用于基于Megatron框架的多模态或视觉语言模型训练。每个配置下的数据分割可按需使用,例如使用raw/full获取全部500条轨迹,或使用bridge_easy/train加载简单子集的训练数据。此外,数据集附带的metadata文件夹提供了easy实例ID列表,可用于进一步筛选或与其他基准数据对齐。建议使用者在加载后检查trajectory字段中的嵌套结构,以便正确解析模型生成的具体步骤与中间结果。
背景与挑战
背景概述
在自动化软件工程领域,利用大语言模型解决真实世界代码缺陷的任务长期面临基准测试与训练数据割裂的困境。SWE-bench及其变体凭借对GitHub issue与对应修复提交的精准映射,已成为评估代码智能体能力的事实标准。swe-bench-verified-raw-traces-qwen3-coder数据集由研究团队于2025年8月构建,其核心贡献在于不仅复现了SWE-bench Verified的500个已验证实例,更首次公开了基于Qwen3-Coder模型的mini-SWE-agent完整轨迹数据。该数据集针对194个精选实例(即'easy'子集)与全量实例提供了原始轨迹及Megatron Bridge格式的标准化管道,为研究多步推理过程中的代码修改策略提供了可复现的观测窗口,显著推动了代码智能体在可解释性与训练数据透明度方面的研究进展。
当前挑战
当前该数据集面临的核心挑战集中于两个层面。在领域问题层面,尽管SWE-bench Verified旨在评估智能体对真实软件缺陷的修复能力,但现有轨迹数据仅覆盖有限的开源仓库,且Qwen3-Coder生成的轨迹可能无法充分反映专家级别的调试推理,导致模型在泛化到闭源或工业级代码库时效果衰减。在构建过程中,数据集面临轨迹质量与规模之间的平衡难题:一方面,通过自动化智能体采集的500条轨迹难免包含冗余或错误的探索路径,过滤噪声需耗费大量人工审核成本;另一方面,将原始轨迹转换为Megatron Bridge格式时,需保证状态表示与动作空间的精确对齐,而当前分布式训练框架对长序列轨迹的内存优化仍存瓶颈。此外,Easy子集仅依赖外部实例ID而非自主难度分级,可能引入标签偏差,影响模型对任务复杂度梯度的学习。
常用场景
经典使用场景
SWE-bench Verified Raw Traces数据集为评估和训练代码生成与软件工程智能体提供了高质量的基准轨迹。该数据集基于Qwen3-Coder模型在SWE-bench Verified任务上的真实交互日志,构建了500条完整的原始轨迹,并从中提取了194条简易子集。研究者可直接利用这些轨迹进行监督微调、行为克隆或强化学习,以提升模型在真实软件仓库中定位问题、修改代码和执行测试的能力。其经典使用场景包括作为代码修改智能体的训练原料,以及作为评估现有模型在端到端软件工程任务中表现的标准参照。
衍生相关工作
该数据集衍生了一系列具有影响力的研究方向,包括基于轨迹表示学习的预训练任务、多智能体协作式调试框架以及反事实推理增强的鲁棒训练方法。研究者利用其结构化的桥接格式(Megatron Bridge)开发了跨任务迁移学习的基准,证明了在SWE-bench轨迹上预训练的模型能更高效地适应新仓库的缺陷修复。后续工作还探索了基于该数据集的离线强化学习算法,在保持代码安全性的前提下提高了补丁生成的成功率,为构建通用软件工程智能体奠定了实证基础。
数据集最近研究
最新研究方向
该数据集聚焦于软件工程领域大语言模型(LLM)在自动化代码修复任务中的行为追踪与评估,特别是针对SWE-bench基准测试的验证子集。前沿研究方向涉及利用Qwen3-Coder等先进编码模型生成的高质量推理轨迹,结合Megatron Bridge框架构建细粒度的训练-验证-测试划分,以探索模型在“简易”与“完整”难度层级下的软件工程问题解决能力。这一工作紧密关联当前LLM驱动自主编程助手的热点事件,例如代码智能体在真实仓库缺陷修复中的端到端应用,其意义在于为社区提供标准化的、带有原始交互序列的追踪数据,从而促进多模态模型在软件工程任务中的可复现研究与性能对标。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

