
遇见数据集

EvanOLeary/pallasbench-robust-gpu-a100

收藏
Hugging Face2026-05-30 更新2026-05-31 收录
官方服务:

资源简介:

PallasBench是一个针对JAX Pallas GPU内核的鲁棒基准测试数据集,专注于NVIDIA A100 80GB GPU。该数据集包含45个JAX Pallas内核,覆盖3个难度级别(L1:单操作,L2:融合模式,L3:架构级),这些内核最初为TPU设计,但通过2D分块等修复方法适配GPU兼容性。数据集提供了内核的正确性检查、执行时间、编译性能分析结果,其中39个内核通过测试。它旨在填补Pallas在GPU上基准测试的空白,作为进化内核优化(如ShinkaEvolve)的初始种群,并遵循SakanaAI的评估方法和数据格式。数据集包括原始TPU内核代码、GPU修复后代码、评估框架和完整结果文件。

PallasBench is a robust benchmark dataset for JAX Pallas GPU kernels, focused on NVIDIA A100 80GB GPU. It includes 45 JAX Pallas kernels across 3 difficulty levels (L1: single ops, L2: fused patterns, L3: architecture), originally designed for TPU but adapted for GPU compatibility via fixes like 2D tiling. The dataset provides correctness checking, execution timing, and compilation profiling results, with 39 kernels passing tests. It aims to fill the gap in Pallas benchmarking for GPUs, serving as an initial population for evolutionary kernel optimization (e.g., ShinkaEvolve), and follows SakanaAIs evaluation methodology and data format. The dataset includes original TPU kernel code, GPU-fixed code, evaluation framework, and complete result files.
提供机构:
EvanOLeary
搜集汇总
数据集介绍
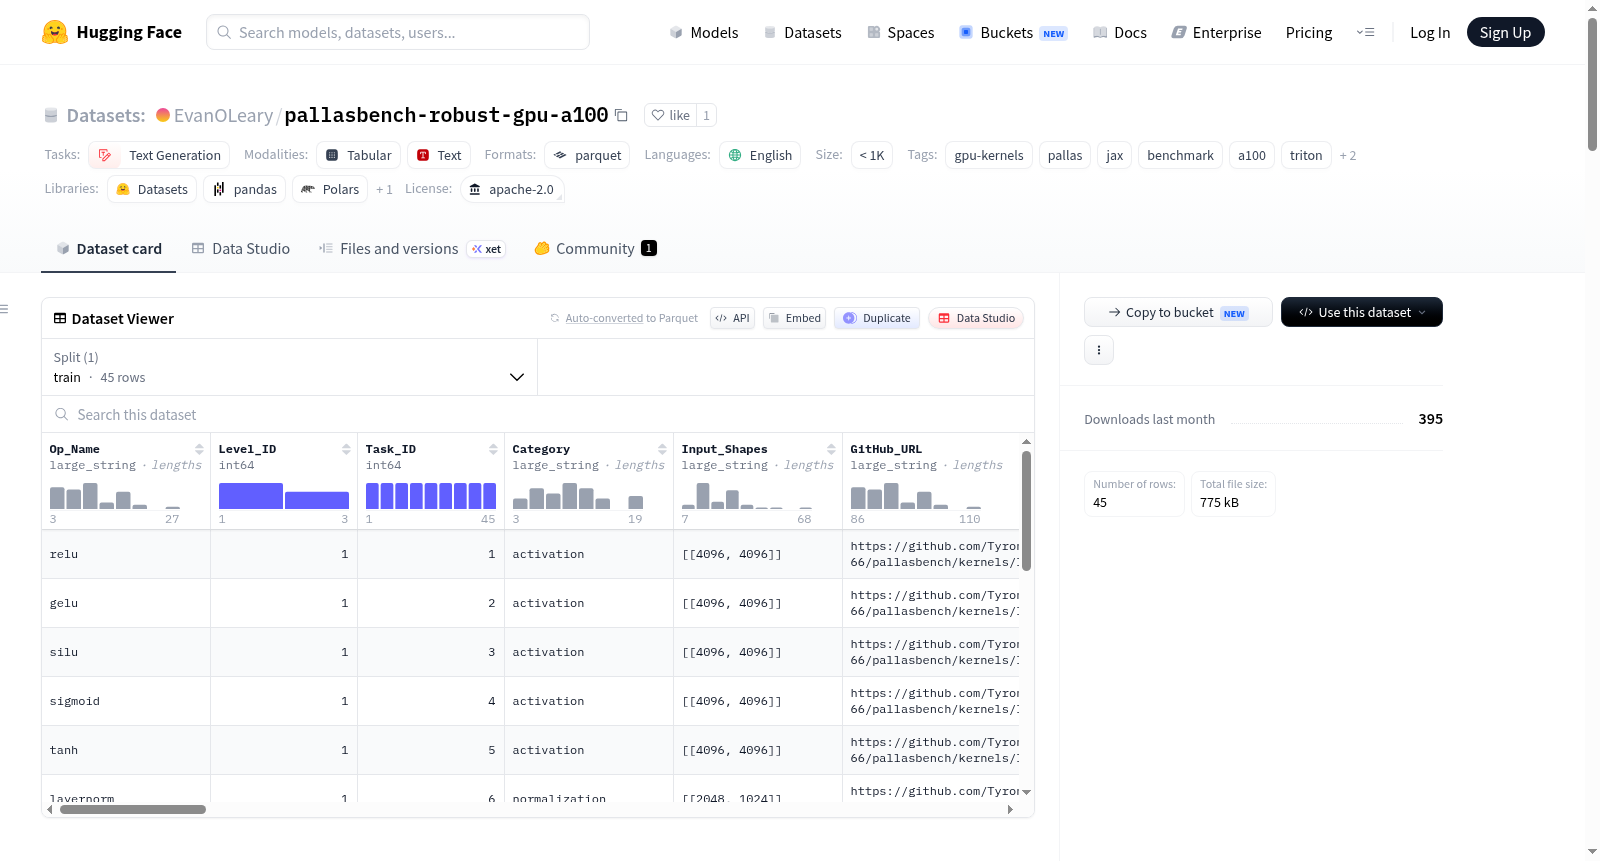
EvanOLeary/pallasbench-robust-gpu-a100 数据集图片
构建方式
PallasBench-Robust-GPU-A100数据集由45个JAX Pallas内核构成,覆盖三个难度级别,其原始版本专为TPU设计。由于Pallas在NVIDIA硬件上通过Triton编译并受限于严格的块大小限制,原始内核在GPU上无法运行。研究团队通过将TPU导向的块尺寸(如(1024, 4096))调整为(128, 128)或(16, 16)的二维分块策略,实现了全部内核的GPU兼容性。数据集在NVIDIA A100 80GB平台上进行了正确性验证、执行时间测量和编译剖析,最终有39个内核通过测试,失败内核的根源被归因于JAX/Triton集成层面的限制。每条记录均包含内核源码、JAX基线实现、加速比、修复类型等结构化字段。
特点
该数据集的核心价值在于填补了Pallas内核在GPU上系统化评估的空白,是首个面向GPU的Pallas内核基准测试。其特点在于内核虽正确但未经GPU优化,完美模拟了大语言模型在缺乏GPU调优知识时生成的Pallas代码质量。数据集继承了robust-kbench的反博弈过滤器、分块分析和中间表示捕获等稳健评估框架,确保了评测的公平性与可靠性。数据格式兼容AI-CUDA-Engineer-Archive标准,支持跨研究工作的对比。所有失败案例均附有详细的根本原因分析,为理解JAX/Triton编译栈的局限提供了宝贵参照。
使用方法
研究人员可通过加载sakanaai_pallasbench.json文件获取完整的评测结果,每条记录包含Op_Name、Level_ID、Pallas_Runtime、JAX_Baseline_Runtime、Speedup及内核源码等字段。利用该数据集,可将其作为进化内核优化(如ShinkaEvolve方法)的初始种群,通过Pallas和Triton编译管道探索自动调优策略。用户也可基于fix.patch文件重现所有GPU兼容性修复,或直接使用gpu_fixed目录下的内核源码进行二次开发。推荐结合robust-kbench的评估脚本运行,并在NVIDIA A100及以上架构的GPU上验证性能表现。
背景与挑战
背景概述
PallasBench-Robust-GPU-A100是由Tyronita团队于2024年创建的一个专注于JAX Pallas GPU内核的鲁棒性基准测试数据集。该数据集旨在填补现有GPU内核基准测试(如KernelBench、robust-kbench)中缺乏Pallas内核评估的空白,Pallas作为唯一能够同时编译至GPU(通过Triton)和TPU(通过Mosaic)的领域特定语言(DSL),其跨硬件兼容性对高效计算具有重要意义。研究团队基于SakanaAI的鲁棒评估方法论,对45个JAX Pallas内核进行了GPU适配与正确性验证,其中39个内核在NVIDIA A100上成功运行,揭示了TPU与GPU编译后端在块大小限制、共享内存容量等方面的本质差异。该数据集不仅为进化式内核优化(如ShinkaEvolve)提供了初始种群,还推动了跨硬件内核编译技术的理解与优化,对异构计算领域的基准测试标准与自动化内核生成研究具有深远影响。
当前挑战
PallasBench-Robust-GPU-A100所解决的领域问题在于,Pallas内核在从TPU迁移至GPU时面临编译后端的根本性差异:Triton严格限制块元素数(≤1,048,576)及共享内存容量(164KB/SM),导致TPU原生的大块(如(1024,4096))直接编译失败。为此,数据集通过二维分块(如(128,128))将PTX代码大小从10MB缩减至300KB,编译时间从数小时降至秒级,但仍有6个内核因JAX/Triton集成限制(如非数组操作、嵌套约简)无法修复。构建过程中,挑战集中于系统化修复45个原始TPU设计内核的GPU兼容性,包括重写块尺寸策略、添加边界钳位,并确保在鲁棒评估框架下(含防博弈过滤器、时序分析与IR捕获)通过五重正确性检验。这些工作不仅暴露了跨硬件编译管线的深层瓶颈,也为未来自动化内核移植与优化算法(如遗传编程)提供了关键基准与调试数据。
常用场景
经典使用场景
PallasBench-Robust-GPU-A100数据集的核心用途在于评估与优化基于JAX Pallas框架编写的GPU内核性能。该数据集包含了45个精心设计的Pallas内核,覆盖从单操作到融合模式乃至高级架构的多个层次,特别适用于验证Pallas代码从TPU向NVIDIA A100 GPU迁移时的正确性与效率。研究者可借助该基准测试正确但未优化的内核,作为初始种群进行自动化内核优化,如演化算法或强化学习,以探索在GPU硬件约束下的最佳性能边界。
解决学术问题
该数据集填补了Pallas内核在GPU上系统性评估的空白,解决了当前学术研究中缺乏跨平台内核编译基准的问题。它揭示了Pallas通过Triton编译至GPU时面临的块尺寸限制与共享内存瓶颈,为理解JAX/Triton集成中的非数组运算、嵌套规约等局限性提供了实证基础。通过提供39个通过测试的GPU兼容内核与详细的失败案例分析,该数据集助力研究者剖析编译器行为差异,推动跨硬件后端的内核生成与优化理论发展。
衍生相关工作
该数据集衍生了一系列关键工作,包括对SakanaAI提出的稳健内核评估框架的方法论借鉴,如反博弈过滤策略及其在JAX/Pallas编译流水线中的适配。受其启发,研究者发展了针对Pallas内核的自动化修复工具,以及结合进化优化(如ShinkaEvolve)的内核微调技术。同时,数据集中的失败案例促进了Triton后端对非数组操作和复杂规约模式支持的改进,启发了多个关于编译器前端与后端协同设计的研究方向。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

