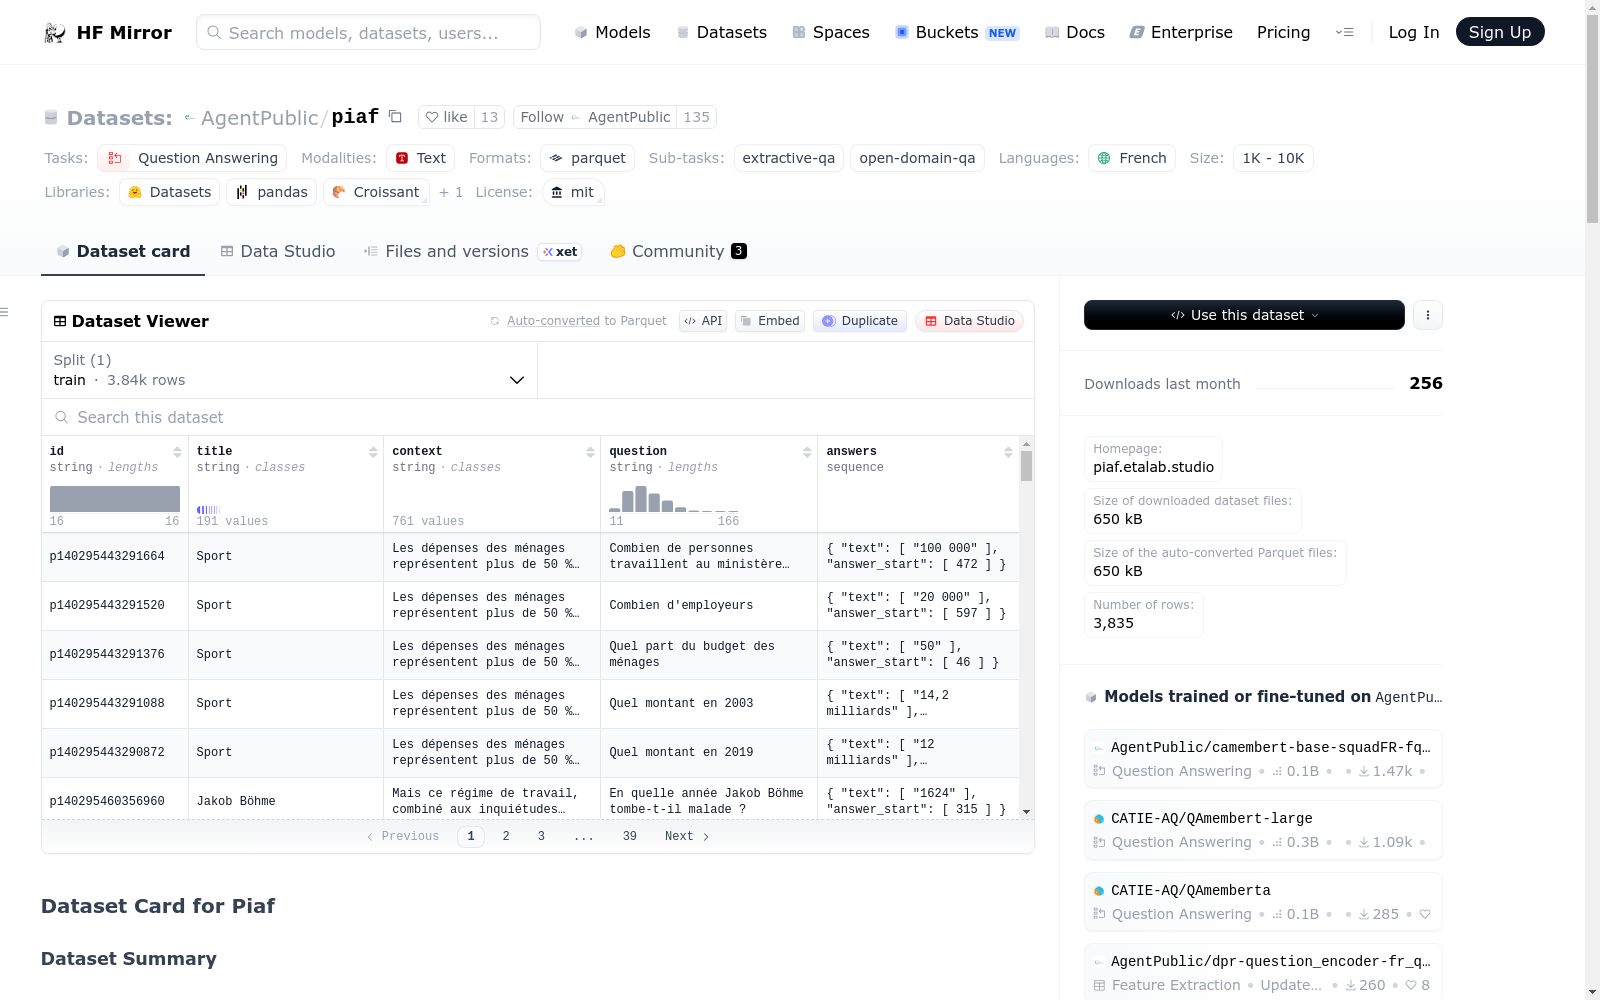
AgentPublic/piaf
收藏资源简介:
Piaf是一个阅读理解数据集,包含3835个关于法语维基百科的问题。该数据集适用于问答任务,所有内容均为法语,采用MIT许可证。数据集的创建和语言标注是通过众包完成的,结构上包括id、title、context、question和answers等特征,其中answers包含text和answer_start。数据集分为一个包含3835个例子的训练集。
Piaf is a reading comprehension dataset containing 3,835 questions about French Wikipedia. It is designed for question answering tasks, with all content in French, and released under the MIT License. The dataset was created and linguistically annotated via crowdsourcing. Structurally, it includes features such as id, title, context, question, and answers, where the answers field consists of two sub-fields: text and answer_start. The dataset is split into a training set that includes all 3,835 examples.
数据集概述
名称: Piaf
语言:
- 语言:
fr - 语言BCP47:
fr-FR
许可: mit
多语言性: monolingual
大小类别: 1K<n<10K
源数据集: original
任务类别: question-answering
任务ID:
extractive-qaopen-domain-qa
数据集结构
数据实例
-
数据集大小:
- 下载大小: 1.31 MB
- 生成数据集大小: 3.18 MB
- 总磁盘使用: 4.49 MB
-
训练集大小:
- 字节数: 3332905
- 示例数: 3835
数据字段
id:stringtitle:stringcontext:stringquestion:stringanswers:text:stringanswer_start:int32
数据集创建
注释创建者: crowdsourced
语言创建者: crowdsourced