
遇见数据集

oliverkinch/da-instruct-dynaword-contemporary-hq

收藏
Hugging Face2026-05-27 更新2026-05-31 收录
官方服务:

资源简介:

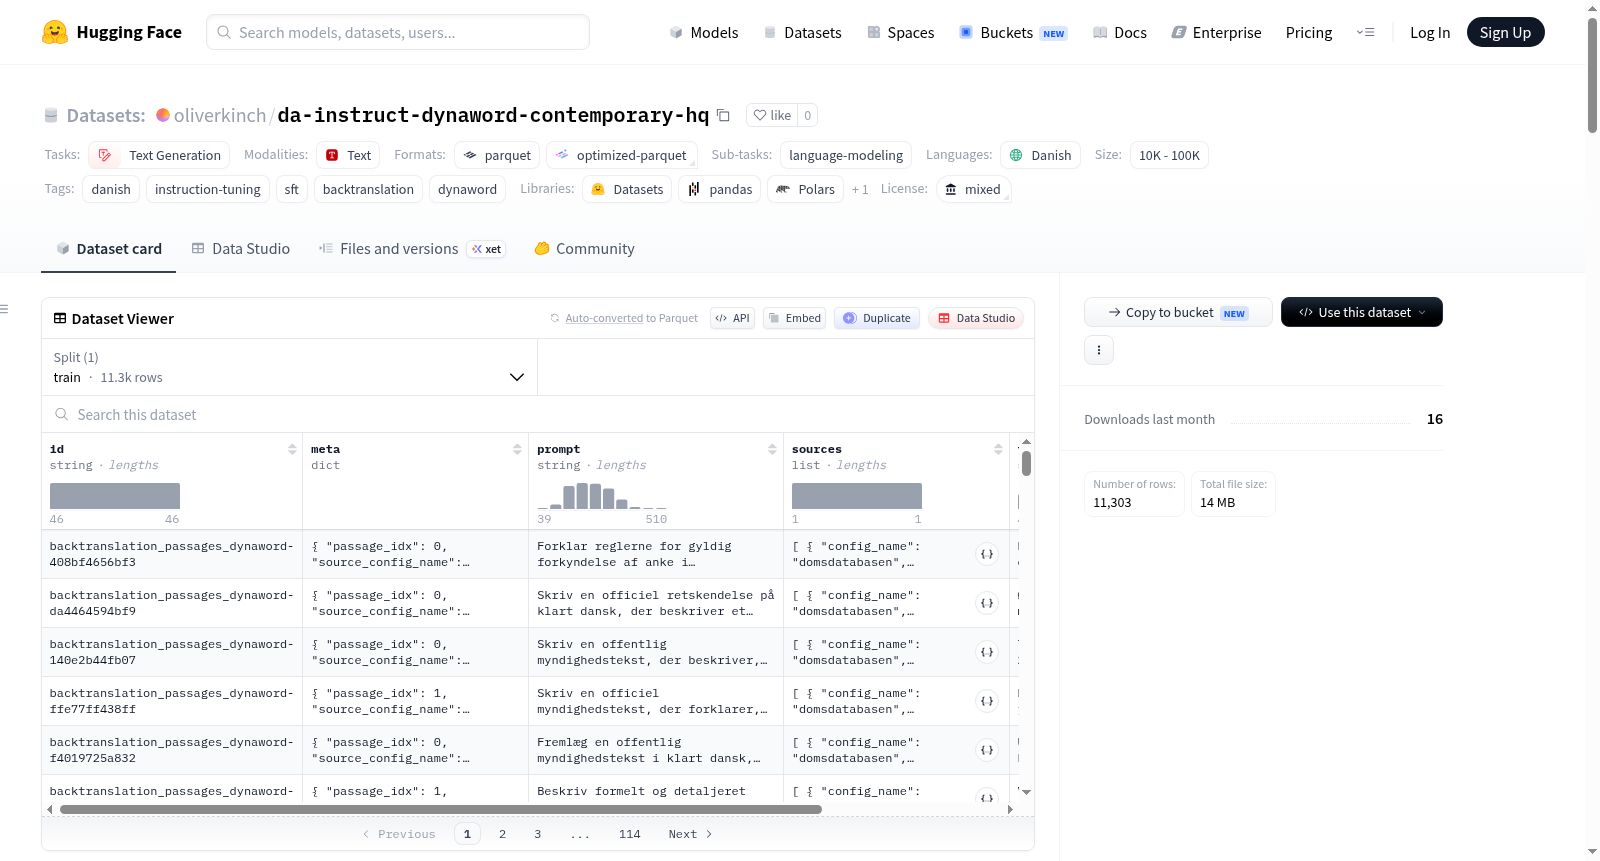
这是一个通过反向翻译从danish-foundation-models/danish-dynaword生成的丹麦语指令微调数据集,并使用danish-foundation-models/dynaword-annotations进行高质量当代丹麦语样本的过滤。排除了主要是历史或古丹麦语的子集。每一行数据都是一个(prompt, target)对,其中target是来自DynaWord精选子集的真实丹麦语文本段落,prompt是通过Qwen3.5-397B-A17B模型使用反向翻译方法生成的现实丹麦语用户指令,这些指令会引发语言模型产生类似的文本。数据集包含11,303个指令对,来自28个DynaWord子集的9,200个随机抽样源ID。

Danish instruction fine-tuning dataset generated via backtranslation from danish-foundation-models/danish-dynaword, filtered to high-quality contemporary Danish samples using danish-foundation-models/dynaword-annotations. Subsets consisting primarily of historical or archaic Danish are excluded. Each row is a (prompt, target) pair where target is a passage of authentic Danish text drawn from a curated subset of DynaWord, and prompt is a realistic Danish user instruction generated by Qwen3.5-397B-A17B using a backtranslation approach that would plausibly elicit that text from a language model. The dataset contains 11,303 instruction pairs generated from 9,200 randomly sampled source IDs across 28 dynaword subsets.
提供机构:
oliverkinch
搜集汇总
数据集介绍
oliverkinch/da-instruct-dynaword-contemporary-hq 数据集图片
构建方式
该数据集基于丹麦语大规模语料库DynaWord,通过反向翻译技术构建指令微调样本。首先,利用dynaword-annotations对原始566万样本进行质量过滤,仅保留内容完整、质量卓越、安全无害且无个人识别信息的当代丹麦语样本,并排除历史或古语子集,最终从28个当代子集中随机无放回抽取9200个样本标识。随后,对文章进行长度筛选(不低于400字符)与分块处理(每块不超过2500字符),并施加严格的段落级质量过滤以剔除OCR噪声、重复内容及文档元数据。最后,采用Qwen3.5-397B-A17B模型,结合六种领域特定的系统提示(政府、文学、学术、税务指导、演讲、新闻),为每个文本段落生成逼真的丹麦语用户指令,并通过规则验证确保指令的语言与形式合规。
使用方法
该数据集以HuggingFace标准格式发布,可通过datasets库直接加载,加载后默认提供训练集(train)划分。每个样本包含id、prompt、target及元数据字段,其中元数据记录了源子集名称、源数据集标识、文本来源类型与字符数等信息。用户可按照监督微调(SFT)范式将样本格式化为多轮对话结构,将prompt映射为用户消息,target映射为助手消息,从而用于丹麦语大语言模型的指令微调训练。数据集采用混合许可证,各子集遵循其原始开放许可证(如CC0、CC-BY、CC-BY-SA等),而生成的prompt列则基于CC-BY 4.0协议发布。
背景与挑战
背景概述
该数据集创建于2024年,由研究人员Oliver Kinch主导,依托丹麦基础模型小组(Danish Foundation Models)构建,旨在解决丹麦语指令微调数据稀缺的核心问题。通过逆向翻译技术,从拥有560万样本的丹麦语多领域语料库DynaWord中提取高质量当代文本,并利用Qwen3.5-397B-A17B模型生成符合丹麦语用户习惯的指令对。研究聚焦于提升丹麦语大语言模型在政府、法律、学术等多领域的指令跟随能力,其发布填补了非英语语言高质量指令数据集的空白,对推动北欧地区自然语言处理研究具有里程碑式的意义。
当前挑战
该数据集面临的挑战首先体现在领域问题上:丹麦语作为低资源语言,缺乏大规模且高质量的人工标注指令数据集,已有的多语言模型往往因忽略丹麦语独特的语法和语用特征而导致生成质量低下。在构建过程中,技术挑战同样严峻:对原始DynaWord语料库的质量筛选需剔除历史用语、考古丹麦语及噪声内容,同时确保样本覆盖28个当代子领域;逆向翻译生成的指令需通过规则过滤器剔除语言不一致、角色扮演和内容重叠等问题,最终还需平衡样本分布以避免领域偏斜,这在高精度自动化处理中极为困难。
常用场景
经典使用场景
在自然语言处理领域,指令微调数据集是驱动语言模型对齐人类意图的核心资源。该数据集专为丹麦语指令微调设计,采用回译技术从当代丹麦语高质量文本中生成指令对,其经典使用场景在于训练丹麦语大语言模型,使其能够理解并执行用户以丹麦语提出的多样化指令。通过涵盖法律、政府、新闻、文学等28个子集的真实文本,数据集为模型提供了丰富而精准的训练样例,尤其适用于开发具备丹麦语会话能力、内容生成能力和知识问答能力的对话式AI系统。
解决学术问题
该数据集针对低资源语言丹麦语在指令微调领域面临的数据匮乏与质量参差问题,提供了系统性解决方案。学术上,它解决了如何从大规模非结构化丹麦语语料中自动构建高质量指令数据集的核心难题,通过结合质量标注过滤与回译生成策略,有效消除了历史语料、噪声文本和不安全内容的影响。这一工作为低资源语言的指令微调数据构建提供了可复现的方法论,推动了非英语语言大模型研究的均衡发展,并成为评估丹麦语语言模型对齐能力的重要基准。
实际应用
在实际生产环境中,该数据集训练出的模型可直接服务于丹麦政府机构的政务咨询自动化、税务法规的智能问答、法律文书的辅助撰写以及新闻内容的摘要生成。例如,基于该数据集微调的聊天机器人能够准确回答公民关于税收规则的具体问题,或将议会演讲记录转化为通俗易懂的摘要。此外,其在医疗健康、环境管理、教育出版等领域的应用潜力同样显著,为丹麦语数字服务的智能化升级提供了关键数据支撑。
数据集最近研究
最新研究方向
在低资源语言大模型微调领域,该数据集通过反向翻译与质量标注双重筛选机制,生成了高保真丹麦语指令对。其前沿性体现在:采用Qwen3.5-397B-A17B大模型进行上下文感知的提示生成,覆盖法律、政务、学术等6类领域模板,解决了小语种指令数据稀缺难题。通过与dynaword-annotations质量注释系统的协同过滤,剔除了OCR噪声、历史语料及包含PII的样本,确保训练数据的当代性与安全性。该数据集为丹麦语SFT提供了11,303条高质量对话对,其构建范式可推广至其他斯堪的纳维亚语言,对推动非英语大模型生态建设具有示范意义。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

