
joeylee2333/qwen3-235b-a22b-distill-math-processed
收藏搜集汇总
数据集介绍
构建方式
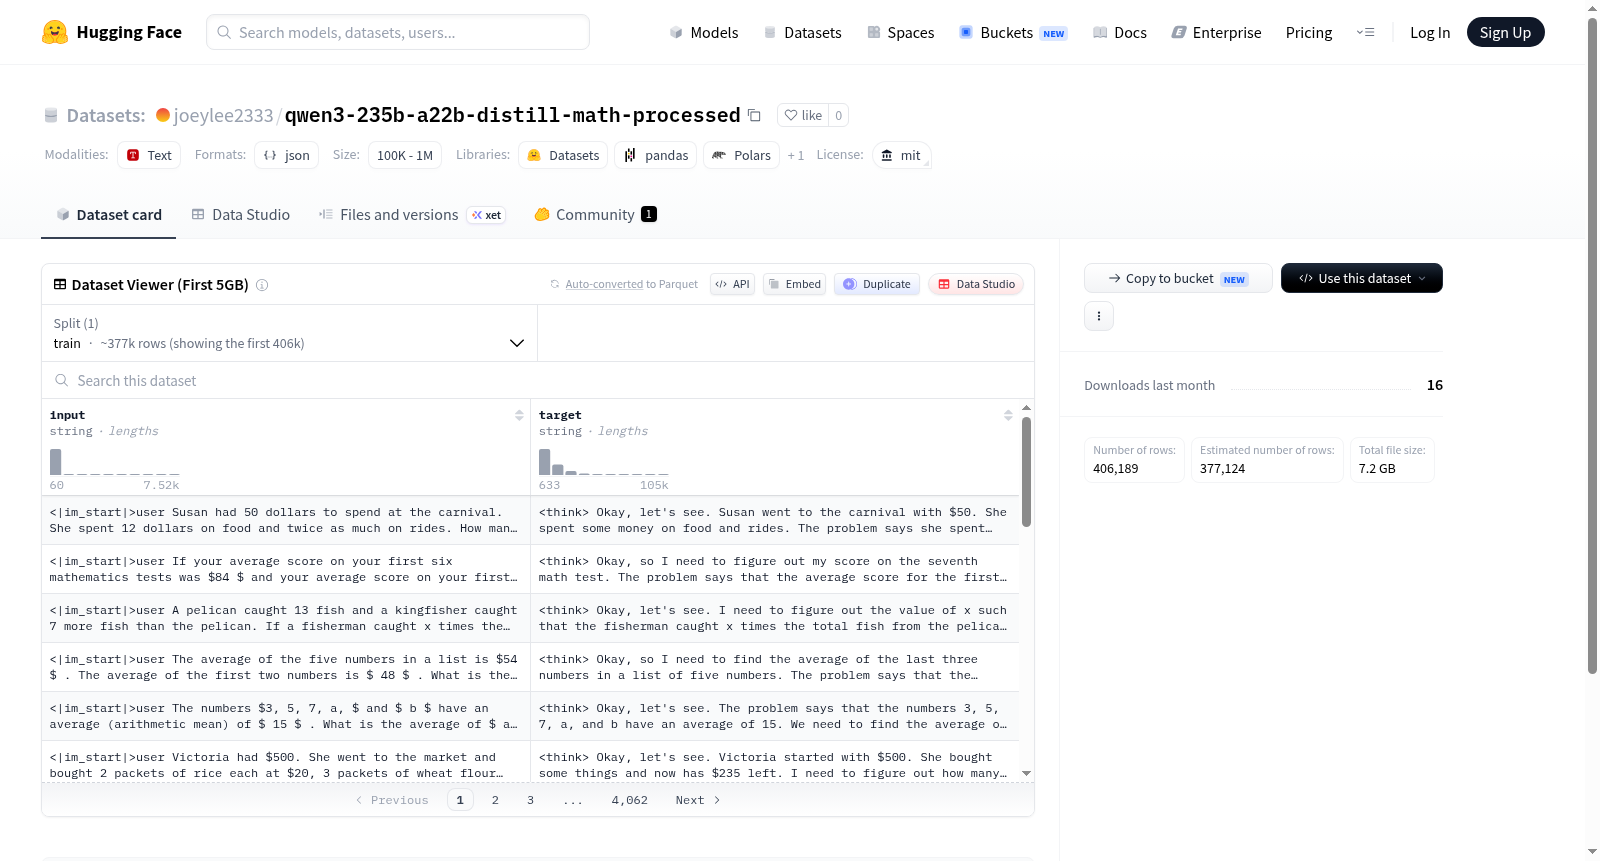
qwen3-235b-a22b-distill-math-processed数据集是基于Qwen3-235B-A22B大语言模型,通过知识蒸馏技术从教师模型中提炼数学推理能力而构建的。该数据集聚焦于数学领域的复杂推理任务,涵盖代数、几何、概率统计等多个数学分支的题目与解答过程。构建过程中,首先由教师模型生成高质数学问题的逐步推理链,随后经由学生模型进行模仿学习与优化筛选,最终形成包含详尽解题步骤的数学问答对集合,旨在强化模型在数学逻辑推演方面的表现。
使用方法
使用qwen3-235b-a22b-distill-math-processed数据集时,推荐将其用于监督微调(SFT)阶段,以增强大语言模型在数学推理任务上的专业能力。开发者可将数据集按训练、验证和测试集进行划分,并配合常用的因果语言模型训练流程,如采用自回归方式最大化推理步骤的下一个词预测概率。建议在微调时设置较低的学习率,并结合数学相关评估指标(如准确率、推理步骤匹配度)来监控模型的学习效果。该数据集兼容HuggingFace Transformers等主流框架,可直接通过load_dataset函数加载使用。
背景与挑战
背景概述
在大型语言模型快速演进的背景下,提升复杂数学推理能力成为前沿研究焦点。Qwen3-235B-A22B-Distill-Math-Processed数据集由通义千问团队于2025年发布,依托Qwen2.5-VL系列模型的混合专家架构,通过知识蒸馏技术从235B参数教师模型中提取数学推理知识,聚焦于处理结构化数学问题。该数据集的提出旨在弥补现有数学推理数据集在隐式格式推理方面的空白,为训练新一代推理模型提供高质量训练语料,对推动数学自动推理与代码辅助解题领域的发展具有重要意义。
当前挑战
该数据集所解决的领域问题聚焦于提升大型语言模型在复杂数学推理任务中的表现,尤其是在隐式格式数学问题上的推理准确性,克服了传统数据集仅覆盖显式格式解题的局限。在构建过程中,面临的核心挑战包括:如何从235B参数教师模型中高效蒸馏出高质量的推理知识,避免知识蒸馏过程中的信息损失;同时,需确保处理后的数学问题覆盖广泛题型与难度层次,并维持数据格式的统一性与可扩展性,以适应多模态与多步推理场景的复杂需求。
常用场景
经典使用场景
在数学推理与符号计算研究领域,qwen3-235b-a22b-distill-math-processed数据集因其蕴含的复杂数学问题求解过程而广受青睐。该数据集由大规模语言模型蒸馏生成,聚焦于数学推导与多步逻辑推理,是训练和评估模型数学能力的经典基准。研究者常利用该数据集对模型进行指令微调,以提升其在数值计算、几何证明、代数方程求解等任务上的表现。此外,该数据集中包含的逐步推理链为涌现于语言模型的隐性数学能力提供了可解释的监督信号,是探索模型逻辑思维链的关键资料。
解决学术问题
该数据集针对的核心学术问题在于增强大型语言模型的数学推理能力,尤其是多步骤、长链条的逻辑推导。传统的预训练语料往往缺乏结构化、分步式的数学解题示范,导致模型难以泛化到需要严谨推理的数学任务。qwen3-235b-a22b-distill-math-processed通过提供高质量、经过蒸馏处理的数学过程数据,有效缓解了模型在数值运算和符号推理中常见的‘幻觉’与逻辑断层问题。其对研究的意义在于验证了知识蒸馏在数学领域迁移能力中的有效性,推动了从统计模式匹配向真正逻辑推理的范式转变,对构建可靠、可解释的数学人工智能具有深远影响。
实际应用
在实际应用层面,该数据集赋能的模型可广泛部署于智能教育、辅助科研与自动化工程计算场景。例如,在自适应学习系统中,经过该数据微调的语言模型能够充当数学导师,为学生提供分步解题指导与个性化错误纠正;在科研自动化领域,模型能够协助解析论文中的数学公式、验证理论推导的正确性;此外,在金融风控、物理仿真等需要严格推导的工业场景中,基于该数据训练的系统也表现出更强的逻辑一致性与结果可靠性。这些应用不仅提升了特定行业的效率,也拓展了语言模型在专业计算领域的落地边界。
数据集最近研究
最新研究方向
在大规模语言模型与数学推理的交叉领域,qwen3-235b-a22b-distill-math-processed数据集的发布标志着知识蒸馏技术在数学推理任务中的又一突破。该数据集通过将高性能教师模型(如Qwen系列)的推理能力压缩至更轻量的学生架构,为复杂数学问题的高效求解提供了高质量的训练素材。当前研究热点集中于利用此类蒸馏数据提升模型对符号计算、几何证明及多步逻辑链的泛化能力,尤其在减少计算资源消耗的同时保持模型在MATH、GSM8K等基准上的竞争力。这一方向不仅推动了数学辅助工具的发展,还催生了工业界与学术界对“小而精”专用推理模型的广泛探索,为教育科技、自动化定理证明等应用场景奠定了数据基础。
以上内容由遇见数据集搜集并总结生成
相关数据集

暂无相关数据集


